Elasticsearch 从 0 到 1 部署上线全攻略:从架构计划到踩坑复盘
不是装个 docker run 就叫部署。真正的从 0 到 1,是把高可用架构、安全认证、索引计划、数据同步、性能调优、监控 告警这条链路全部走通,并沉淀成团队的尺度部署 SOP。
这篇文章,我联合自己生产环境搭建 3 节点 ES 集群的实战经验,从架构选型 → 环境调优 → 集群部署 → 索引计划 → 数据接入 → 性能加固 → 踩坑复盘七个阶段展开,全程贴合生产落地尺度。不管你是准备面试,照旧真要上手干活,这篇都能帮你少走弯路。
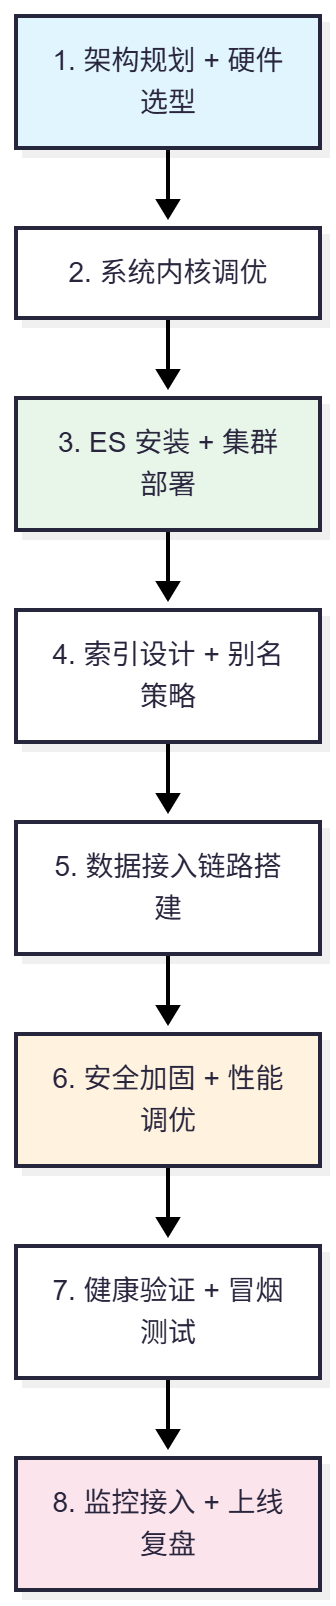
一、整体部署流程全景
先上一张全景图,心里有个数,后面每一步都在这个框架里填肉:
二、架构规划:3 节点起步,要能扛住生产
2.1 硬件选型(生产尺度)
环境类型CPU内存磁盘类型节点数实用场景开发测试4C8GSATA SSD1功能验证生产集群16C32GNVMe SSD3台起业务承载别在磁盘上省钱。ES 是 I/O 密集型应用,NVMe SSD 和 SATA SSD 的随机读写差距可以到 5-10 倍,直接影响搜索延迟和写入吞吐。
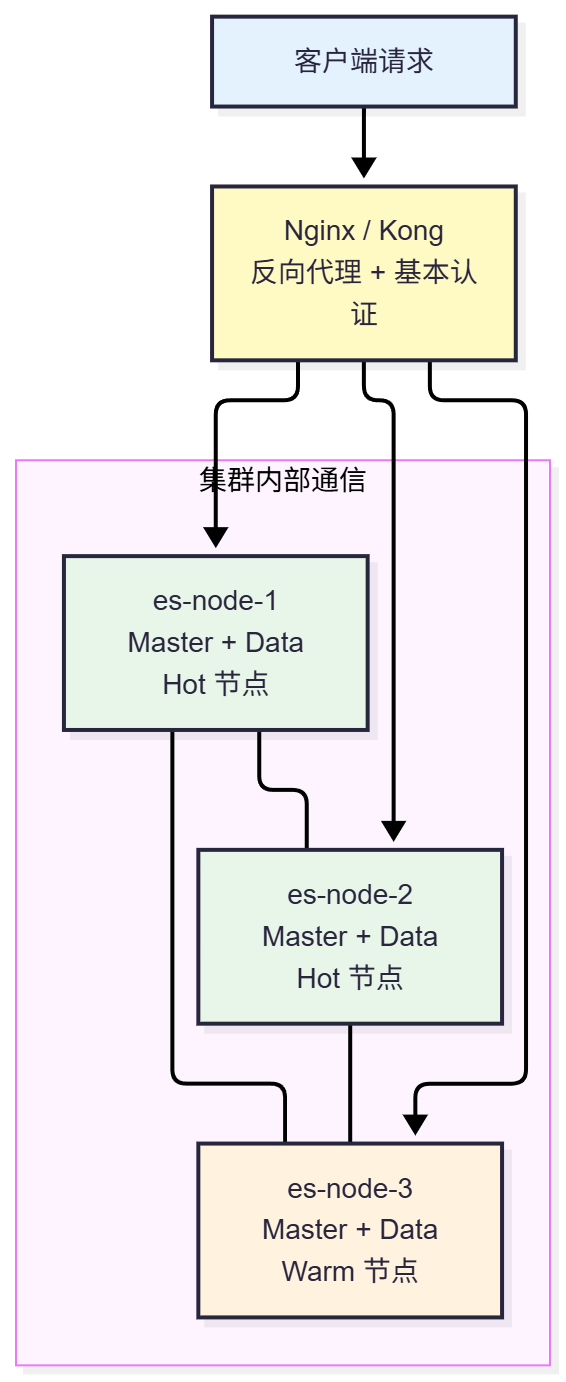
2.2 集群架构图
生产最小可用集群,我一般这样规划:
2.3 三个关键决议点
1. 主节点要不要独立?
小规模集群(3-5 节点),Master 和 Data 可以复用。但集群规模一大(>10 节点),务必把 Master 节点独立出来(node.roles: [master])。否则 Master 被 GC 卡顿拖住,整个集群的选主和状态管理都会出问题。
2. 冷热分离怎么做?
通过节点标签 node.attr.box_type: hot/warm 区分,热数据放 SSD,冷数据放 HDD。再配合 ILM(索引生命周期管理)自动迁移,日志 类数据可以省 50% 以上的存储本钱。
3. 脑裂怎么防?
这是面试高频考点,也是生产真会遇到的问题:
- 主节点数量保持奇数(3 或 5),保证投票不会出现平票
- 7.x+ 通过 cluster.initial_master_nodes 规范首次选举,之后自动管理
- 避免跨机房部署主节点,网络分区是脑裂的头号元凶
关于这个问题的底层原理和更多实战细节,我整理了一份《大厂面试手册》,包罗大厂高频面试题、源码剖析和性能调优案例。
关注公众号【Rain的Java大神之路】,回复“Java”即可免费领取,持续更新中。
三、系统调优:部署前的必修课
80% 的 ES 启动失败,都是系统参数没调好。这一步别偷懒。
3.1 关闭 Swap
ES 极度依赖内存,Swap 交换会导致查询性能骤降,甚至节点假死。- swapoff -a
- # 永久关闭:注释 /etc/fstab 中 swap 分区行
ES 大量使用内存映射文件(mmap),默认值 65530 不敷用,直接启动失败。- echo "vm.max_map_count=262144" >> /etc/sysctl.conf
- sysctl -p
ES 会打开大量索引文件,默认 1024 完全无法满足生产需求。- echo "* soft nofile 65536" >> /etc/security/limits.conf
- echo "* hard nofile 65536" >> /etc/security/limits.conf
实战建议:把上面三步写成一个 init-es-os.sh 脚本,纳入运维尺度化流程。每次新机部署先跑一遍,省得踩坑。
四、集群部署:Docker-Compose 一键拉起
4.1 版本选择
推荐 7.17.x(生产主流 LTS 版本),兼容性和稳固性最佳。JDK 用 ES 自带的就行,不消额外安装,避免版本兼容问题。
4.2 焦点配置 elasticsearch.yml
- # 集群名称:同集群所有节点必须一致
- cluster.name: es-prod-cluster
- # 节点名称:建议与主机名对应,便于故障排查
- node.name: es-node-1
- # 节点角色:生产建议分离,测试可兼用
- node.roles: [master, data]
- # 绑定网卡:生产绑定内网 IP,禁止 0.0.0.0 直接暴露公网
- network.host: 192.168.1.101
- http.port: 9200
- # 集群发现:种子节点列表,填写所有节点 IP
- discovery.seed_hosts: ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
- # 初始主节点:仅首次集群启动配置,集群形成后必须删除!
- cluster.initial_master_nodes: ["es-node-1", "es-node-2", "es-node-3"]
- # 数据与日志路径:禁止放在系统盘
- path.data: /data/es/data
- path.logs: /data/es/logs
踩坑提醒:cluster.initial_master_nodes 只在集群首次启动时使用。集群成功组建后,肯定要从配置中移除这一项,否则节点重启时大概引发异常选举。
4.3 JVM 内存配置(技能亮点)
- # config/jvm.options
- # 堆内存设置为相同值,避免堆扩容缩容带来的性能抖动
- -Xms16g
- -Xmx16g
为什么?因为 JVM 的 Compressed Oops(压缩对象指针) 在 32G 以内生效。一旦超过 32G,指针从 32 位变成 64 位,同样的数据量占用内存反而增加 10%-20%。所以 32G 是 ES 堆内存的"黄金分割线"。
4.4 Docker-Compose 编排(3 节点)
- version: '3.7'
- services:
- es01:
- image: docker.elastic.co/elasticsearch/elasticsearch:7.17.6
- container_name: es01
- environment:
- - node.name=es01
- - cluster.name=prod-es-cluster
- - discovery.seed_hosts=es02,es03
- - cluster.initial_master_nodes=es01,es02,es03
- - "ES_JAVA_OPTS=-Xms8g -Xmx8g"
- - node.attr.box_type=hot
- volumes:
- - ./es01/data:/usr/share/elasticsearch/data
- - ./es01/config/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
- ports:
- - 9200:9200
- networks:
- - es-net
- es02:
- image: docker.elastic.co/elasticsearch/elasticsearch:7.17.6
- container_name: es02
- environment:
- - node.name=es02
- - cluster.name=prod-es-cluster
- - discovery.seed_hosts=es01,es03
- - cluster.initial_master_nodes=es01,es02,es03
- - "ES_JAVA_OPTS=-Xms8g -Xmx8g"
- - node.attr.box_type=warm
- volumes:
- - ./es02/data:/usr/share/elasticsearch/data
- networks:
- - es-net
- es03:
- image: docker.elastic.co/elasticsearch/elasticsearch:7.17.6
- container_name: es03
- environment:
- - node.name=es03
- - cluster.name=prod-es-cluster
- - discovery.seed_hosts=es01,es02
- - cluster.initial_master_nodes=es01,es02,es03
- - "ES_JAVA_OPTS=-Xms8g -Xmx8g"
- volumes:
- - ./es03/data:/usr/share/elasticsearch/data
- networks:
- - es-net
- networks:
- es-net:
- driver: bridge
很多新人直接往 ES 灌数据,keyword 和 text 不分,效果聚合慢、排序错。这一步必须严谨。
5.1 创建商品索引(技能亮点)
- PUT /goods_v1
- {
- "settings": {
- "number_of_shards": 3,
- "number_of_replicas": 1,
- "refresh_interval": "30s",
- "analysis": {
- "analyzer": {
- "ik_smart_pinyin": {
- "type": "custom",
- "tokenizer": "ik_smart",
- "filter": ["lowercase"]
- }
- }
- }
- },
- "mappings": {
- "properties": {
- "goodsId": { "type": "keyword" },
- "title": {
- "type": "text",
- "analyzer": "ik_max_word",
- "fields": {
- "pinyin": { "type": "text", "analyzer": "ik_smart_pinyin" }
- }
- },
- "price": { "type": "scaled_float", "scaling_factor": 100 },
- "createTime": { "type": "date" },
- "tags": { "type": "keyword" }
- }
- }
- }
字段类型选择计划理由goodsIdkeyword不参与分词,适合准确匹配和聚合排序titletext + ik_max_word全文检索,细粒度分词提升召回率title.pinyin子字段 + 拼音分词器支持"输入拼音搜商品"的场景pricescaled_float比 double 省空间,精度可控(分转元)tagskeyword标签准确匹配,用于过滤聚合5.2 别名策略:零停机切换的秘诀
索引以 _v1 结尾,配合别名 goods 对外暴露。后续重建索引时,只需将别名指向新索引 goods_v2,业务代码零修改,实现零停机切换。- POST /_aliases
- {
- "actions": [
- { "remove": { "index": "goods_v1", "alias": "goods" } },
- { "add": { "index": "goods_v2", "alias": "goods" } }
- ]
- }
这个技巧在 Reindex(重建索引)、Mapping 变更、版本升级等场景下非常好用,是生产环境的标配利用。
六、数据接入:MySQL 到 ES 的高可靠同步方案
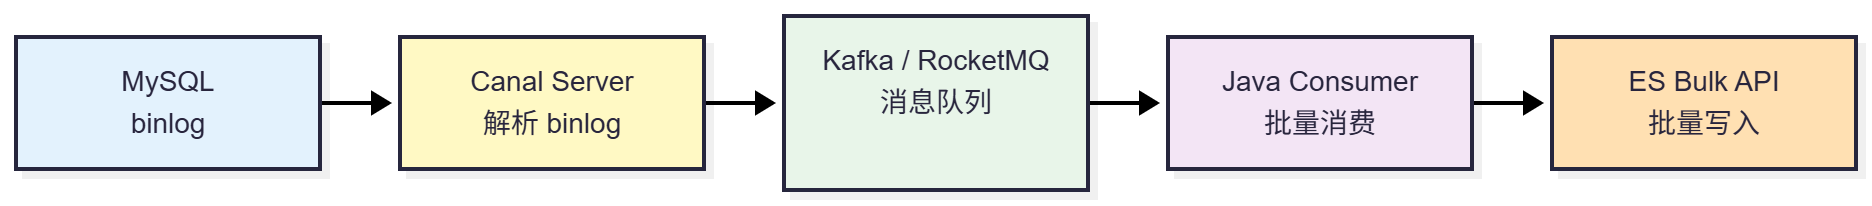
数据来源是 MySQL,放弃简单的 Logstash 全量同步,选择 Canal + MQ + 自定义消耗者 的异步链路,保证最终一致性。
6.1 数据流架构
6.2 Java 焦点代码:批量消耗 + 去重写入
- @KafkaListener(topics = "goods_binlog")
- public void consume(List<ConsumerRecord<String, String>> records) {
- BulkRequest bulkRequest = new BulkRequest();
- for (ConsumerRecord<String, String> record : records) {
- GoodsDTO goods = JSON.parseObject(record.value(), GoodsDTO.class);
- // 使用 goodsId 作为文档 ID,幂等写入
- IndexRequest request = new IndexRequest("goods")
- .id(goods.getGoodsId())
- .source(JSON.toJSONString(goods), XContentType.JSON);
- bulkRequest.add(request);
- }
- // 单批次 1000 条,超时 2 分钟
- BulkResponse response = restHighLevelClient.bulk(bulkRequest,
- RequestOptions.DEFAULT);
- // 失败重试或记录死信
- if (response.hasFailures()) {
- log.error("ES bulk error: {}", response.buildFailureMessage());
- // 写入重试队列
- }
- }
- 次序保证:Canal 保证 binlog 次序,单分区 Kafka 避免乱序,消耗者单线程拉取,简化逻辑
- 幂等写入:使用业务 ID(goodsId)作为 ES 文档 ID,天然幂等,不怕重复消耗
- 熔断降级:ES 写入超时或拒绝时,立刻暂停消耗,熔断肯定时间后恢复,防止拖垮整条链路
七、安全加固 + 性能调优
7.1 安全加固(7.x 默认开启 XPack)
- # 批量设置内置用户密码
- bin/elasticsearch-setup-passwords interactive
- # 依次设置 elastic / kibana / logstash_system 等内置用户密码
- xpack.security.enabled: true
- xpack.security.transport.ssl.enabled: true
上线前逐项核对,这也是面试中最能体现经验的部分:
类别调优项落地方案JVM堆内存 ≤ 32G,且不超过物理内存 50%-Xms16g -Xmx16g,开启 G1GC,bootstrap.mlockall: true 锁内存OS文件形貌符 + 虚拟内存映射ulimit -n 65535,vm.max_map_count=262144索引按时间切分(如按天)利用 ILM 自动 rollover,删除过期索引写入增加 bulk 队列和线程池thread_pool.write.queue_size: 1000搜索禁用 wildcard 前缀通配符用 ngram 分词器代替,防止集群 OOM磁盘水位线告警low: 85% / high: 90% / flood_stage: 95%监控Prometheus + Grafana通过 elasticsearch_exporter 监控 GC 频率、搜索延迟、节点负载7.3 磁盘水位线配置
这个必须提前配,不然磁盘打满后 ES 会自动把索引设为只读,直接无法写入:- cluster.routing.allocation.disk.watermark.low: 85%
- cluster.routing.allocation.disk.watermark.high: 90%
- cluster.routing.allocation.disk.watermark.flood_stage: 95%
8.1 集群健康查抄
- # 查看集群健康状态
- curl -XGET http://192.168.1.101:9200/_cluster/health?pretty
- # 查看节点列表与角色
- curl -XGET http://192.168.1.101:9200/_cat/nodes?v
状态寄义是否必要处理Green所有主分片 + 副本都正常分配统统正常Yellow主分片正常,副本未分配单节点必现,非故障;多节点需排查Red存在主分片丢失,数据缺失告急排查,大概有数据丢失风险8.2 冒烟测试
- # 1. 创建测试索引(3 主分片 1 副本)
- curl -XPUT -u elastic:密码 http://192.168.1.101:9200/test_demo \
- -H 'Content-Type: application/json' -d '
- {
- "settings": {
- "number_of_shards": 3,
- "number_of_replicas": 1
- }
- }'
- # 2. 插入测试数据
- curl -XPOST -u elastic:密码 http://192.168.1.101:9200/test_demo/_doc/1 \
- -H 'Content-Type: application/json' -d '
- {"name":"es部署测试","status":"success"}'
- # 3. 查询验证数据一致性
- curl -XGET -u elastic:密码 http://192.168.1.101:9200/test_demo/_doc/1?pretty
九、生产踩坑复盘:6 个真实场景
这是全文最值钱的部分。每一个都是从生产变乱里提炼出来的经验。
坑 1:集群脑裂(出现多个 Master)
征象:集群出现两个 Master 节点,数据写入不一致。
根因:网络分区导致多个节点自以为主。
解决方案:
- 主节点数量保持奇数,生产用 3 台专用主节点
- 7.x+ 通过 initial_master_nodes 规范首次选举
- 避免跨机房部署主节点,网络延迟是隐形杀手
坑 2:启动直接报错退出
征象:ES 进程启动后几秒就挂掉。
根因:系统内核参数不满足(虚拟内存映射数、文件句柄数不敷)。
解决方案:部署前统一执行系统调优脚本,纳入运维尺度化流程。别手动一项一项配。
坑 3:磁盘打满后索引只读
征象:突然无法写入数据,报 cluster_block_exception。
根因:触发 flood_stage 水位线(95%),ES 自动锁索引掩护集群。
解决方案:
- 扩容磁盘 / 清理过期索引
- 接入磁盘使用率告警,提前预警
- 解锁索引:PUT //_settings {"index.blocks.read_only_allow_delete": null}
坑 4:堆内存频繁 OOM
征象:JVM 堆内存打满,节点频繁 Full GC 甚至 OOM 退出。
根因:堆内存设置不合理,或大查询 / 聚合占用内存过高。
解决方案:
- 严格服从堆内存 ≤ 32G 规范
- 优化深分页(用 search_after 替代 from+size)、大聚合查询
- 增加数据节点分散压力
坑 5:分片热点,节点负载不均
征象:促销时个别分片写入 QPS 极高,节点 CPU 100%。
根因:分片数不敷,或路由策略导致数据倾斜。
解决方案:
- 提前用 _split API 将热点索引分片数从 3 扩到 6,分摊压力
- 对商品 ID 取模定制路由,避免数据倾斜
- 开启分片均衡感知策略
坑 6:长 GC 导致 Master 失联
征象:节点突然从集群中消失,集群状态反复 Yellow/Red 切换。
根因:GC 时间 > 30s,节点被集群判定为失联,触发重新选主。
解决方案:
- 堆内存严格 30G 以内(压缩指针生效区间)
- 使用 G1GC 并调优 -XX:MaxGCPauseMillis=200
- 分离主节点脚色,数据节点的查询压力不影响主节点稳固性
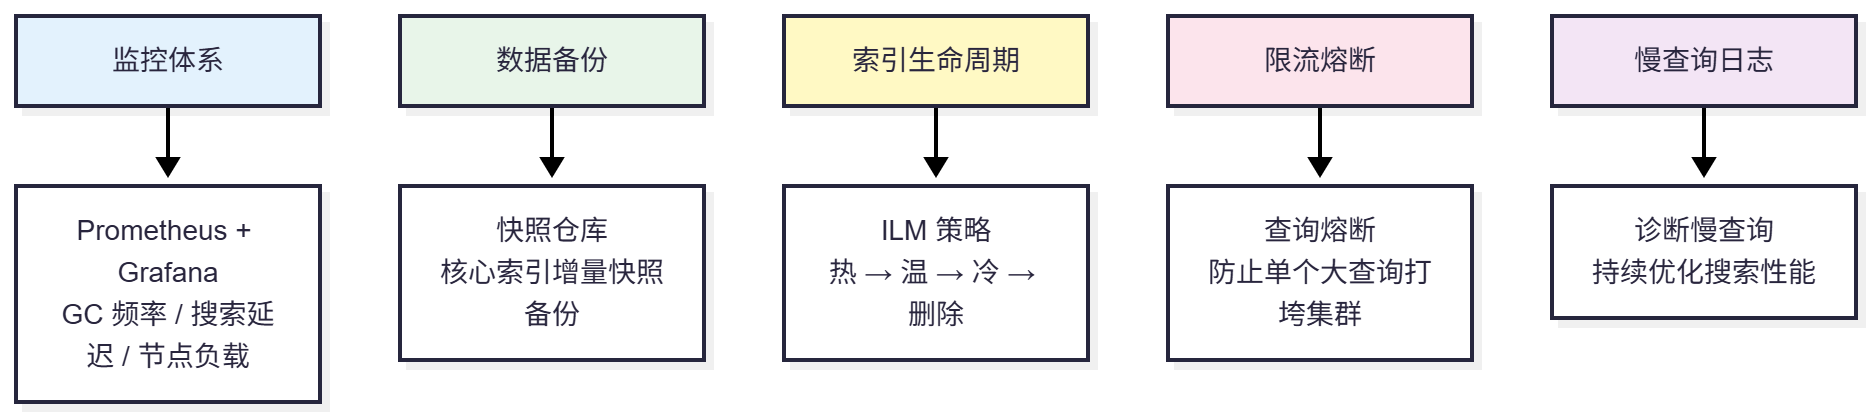
十、上线后的持续保障
集群跑起来只是开始,长期稳固还必要这些能力:
总结
Elasticsearch 从 0 到 1 的部署,绝不是 docker run 一下就完事。它是一条完整的工程链路:
每一个环节都有坑,但每一个坑都有解法。把这篇文章里的配置、代码、踩坑经验吃透,不管是面试照旧实际落地,你都能交出一份漂亮的答卷。
末了说一句:技能博客千千万,能动手跑通的才算自己的。建议读者照着文中的步骤实操一遍,比看十篇文章都管用。
假如本文对你有资助,欢迎关注我的公众号【Rain的Java大神之路】。
专注 Java 面试、源码、高并发实战,回复“Java”领取《大厂面试手册》,持续更新。
免责声明:如果侵犯了您的权益,请联系站长及时删除侵权内容,谢谢合作!qidao123.com:ToB企服之家,中国第一个企服评测及软件市场,开放入驻,技术点评得现金. |







 发表于