








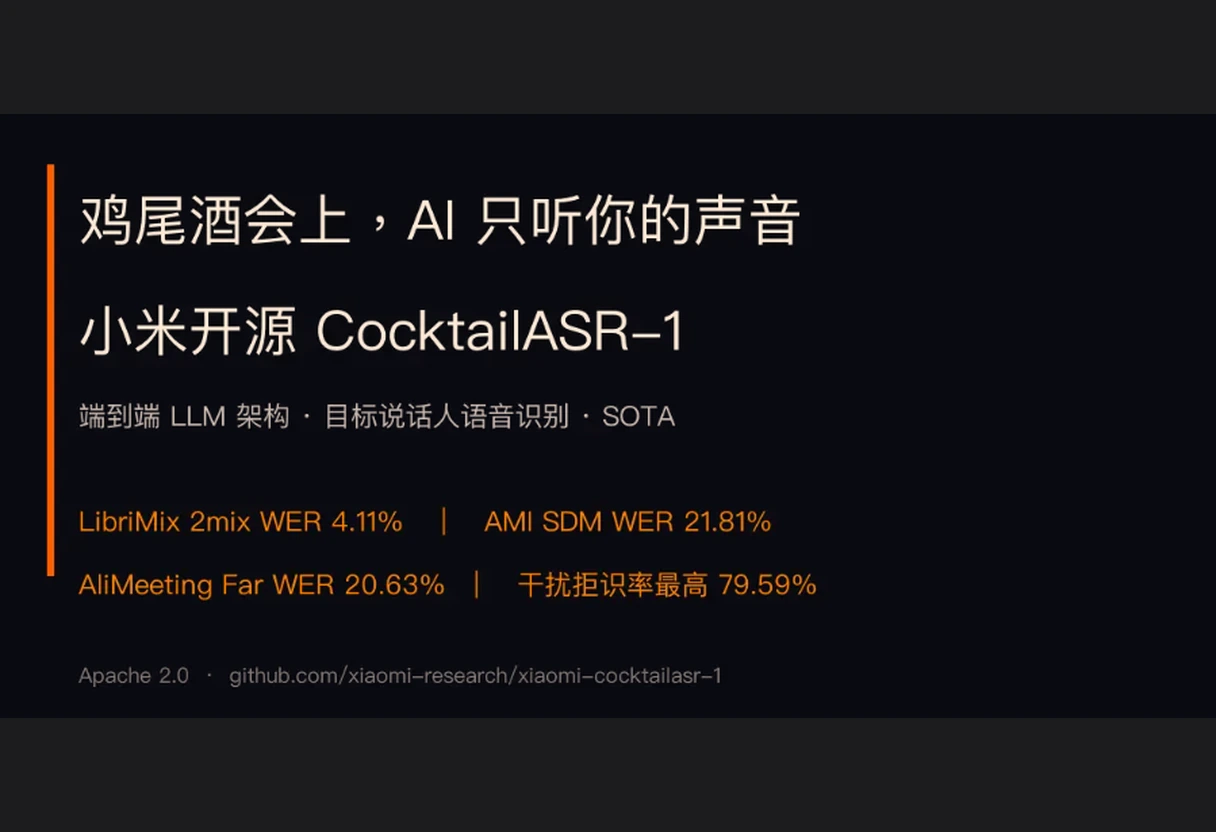
小米开源工业级目标说话人语音识别大模型Xiaomi-CocktailASR-1:端到端LLM架构,专攻"鸡尾酒会"多人混说难题
9月11日,小米正式发布并开源工业级目标说话人语音识别大模型Xiaomi-CocktailASR-1,旨在解决语音识别领域长期存在的"鸡尾酒会"难题——多人同时讲话场景下识别率急剧下降问题。模型采用端到端大语言模型架构,由D2V2音频编码器、Adapter与大模型解码器串联组成,输入为参考音频与目标单声道音频拼接、中间插入1秒静音作为分隔,所有权重整合在单一检查点。多人混说测试集LibriMix3mix上WER仅12.29%,竞品多在76%—121%;真实会议场景AMI SDM、AliMeeting Far亦大幅领先。同时支持强大的负样本拒识能力,目标不在场时输出空文本,避免智能音箱与车载语音助手误触发;并支持思维链推理模式,可解释识别过程。代码与权重以Apache 2.0协议开源,GitHub仓库xiaomi-research/xiaomi-cocktailasr-1,HuggingFace仓库Ease3/Xiaomi-CocktailASR-1,依赖极简。
【新闻原文】
9 月 11 日,小米正式发布并开源工业级目标说话人语音识别大模型 Xiaomi-CocktailASR-1,旨在解决语音识别领域长期存在的"鸡尾酒会"难题——多人同时讲话场景下的识别率急剧下降问题。模型权重与推理代码已开源,GitHub 仓库采用 Apache 2.0 协议发布。
传统自动语音识别(ASR)模型的任务输入是单一音频流,无论说话者是谁都尝试转录所有声音,因此当多个人同时讲话时,识别率会急剧降低。Xiaomi-CocktailASR-1 彻底改变了这种输入方式,采用基于参考声纹的目标说话人识别机制:用户只需提供一段目标说话人的参考音频作为声纹提示,模型便利用声纹嵌入精准定位目标说话人,在多人混合音频中只转录该特定人物的语音,而其他人说话的内容、混响以及背景噪声均会被自动过滤,将复杂的混合音频任务转化为高效的目标说话人识别。
在底层架构上,CocktailASR-1 采用端到端大语言模型架构,由 D2V2 音频编码器、Adapter 以及大模型解码器串联组成,所有权重整合在同一个检查点中。在实际使用时,输入格式为将参考音频与目标单声道音频进行拼接,中间插入一秒静音作为分隔。这种设计让模型具备极高的通用性——无论是单人还是复杂的多元场景,无需切换模型即可一气呵成。
多项基准测试验证了模型的强悍实力。在模拟多说话人测试中,模型在 LibriMix2mix 和 LibriSpeechMix2mix 数据集上的字错率(WER)分别压低至 4.11% 和 2.90%;相比之下,同赛道多款知名模型在混合场景下表现普遍欠佳,例如在 LibriMix3mix 测试中部分竞品字错率高达 76% 到 121% 不等,而 CocktailASR-1 的字错率仅为 12.29%。即便是面对更具挑战的真实会议录制场景,如 AMI SDM 和 AliMeeting Far,模型也大幅领先现有各类解决方案。而在单人场景下,模型在 LibriSpeech、WenetSpeech 以及 CommonVoice-zh 等数据集上也实现了全面超越。
除突破性的识别精度外,模型还具备两大工程亮点。其一是强大的负样本拒识能力:当参考音频对应的人并不参与当前对话时,模型能够直接输出空文本,从而有效防止智能音箱、车载语音助手等智能设备被旁人的声音误触发,测试显示其在多个数据集上的负样本拒识率表现优异。其二是支持思维链推理模式:模型可以显示其通过特定标签识别说话人的过程,再输出最终答案,可解释性大幅增强,便于系统调试和场景适配。
当前 Xiaomi-CocktailASR-1 相关代码已开源在 GitHub(仓库地址:xiaomi-research/xiaomi-cocktailasr-1),权重已同步至 HuggingFace(Ease3/Xiaomi-CocktailASR-1)。项目依赖环境极简,仅需 torch、torchaudio、transformers、soundfile 等基础库即可从 HuggingFace 加载部署。
小米此次开源被业内视为语音技术基础逻辑的转变:语音识别从传统的"捕捉所有声音"迈入"锁定某一个人的声音"的新阶段,对智能会议、智能家居、可穿戴设备、车载语音等多人混说场景具有直接的工程价值。
【企服观察】
小米这条消息在舆论场上的位置很有意思:技术圈的人会觉得这是一个非常硬核的工程突破,但市场圈的人可能会问"这和我有什么关系"。把这件事放到企业 IT 和企服行业的视角来看,它的价值可能比模型本身显得更重要——它真正回答的是"AI 在嘈杂的真实办公场景里到底能不能用"这个长期困扰行业的问题。
先看技术突破的实际意义。"鸡尾酒会问题"在语音识别领域是个老问题,多人同时说话时传统 ASR 模型的识别率会从 95% 以上直接掉到 30%—40% 甚至更低。这个问题在企业日常办公里几乎无处不在:会议室里三四个人讨论、开放办公区的临时讨论、视频会议里背景里孩子的哭声、电话会议里同事的插话。过去的解决方案要么堆叠多个麦克风做波束成形,要么写一堆规则做 VAD(语音活动检测),但效果都有限,因为本质上都是在"试图识别所有声音"。小米这条技术路线换了一个思路:不识别所有声音,而是先回答"我要听谁",然后只识别那个人的声音。这是范式层面的变化。
对企业应用而言,这相当于把"识别所有声音"的难题转成了"提供一段参考音频"的简单输入。这意味着几个具体的业务场景会立刻变得更可行:
第一是会议场景的纪要自动化。目前几乎所有 AI 会议纪要产品都面临同一个尴尬:当多人同时发言时,输出的内容会变得混乱,分不清谁说了什么。目标说话人 ASR 可以做到"专门转录项目经理 A 的发言""专门整理客户 B 的反馈",这就把会议纪要从"事后重写"变成"实时按人分发"。当一个跨国团队需要在不同时区协作时,先把美国团队负责人和欧洲团队负责人的参考音频喂进去,就能各自拿到一份定制化的内容摘要。
第二是客服与电销场景。呼叫中心每天产生海量通话录音,过去做质检时必须把每条录音完整听完,目标说话人 ASR 可以做到"专门提取客户那一端的语音""专门提取坐席的违规话术"。这种"按声道、按角色"提取的能力,对质检、合规、培训三大业务都有直接的效率提升。某大型保险公司一年光客服录音的质检成本就是几百万,如果能把这块的成本砍掉一半,价值相当可观。
第三是车载与可穿戴场景。智能音箱和车载语音助手最让人头疼的就是"误触发"——家里电视里有人说了一句类似的话,音箱就自己开始播放音乐。负样本拒识能力相当于给设备加了一道"这个人不是我"的判断,参考音频对应的人不在场时直接输出空文本,等于让 AI 学会"闭嘴"。这个特性对消费电子厂商尤其有价值,因为它直接关系到用户体验和品牌形象。
第四是媒体与内容生产场景。播客剪辑、采访整理、视频字幕生成,这些工作的痛点同样集中在多人混说。一个三小时的对谈节目,传统方式要花五六个小时做听打整理,目标说话人 ASR 可以让剪辑师"先提取主持人的发言""再提取嘉宾的关键观点",整个流程的效率会提升一个数量级。
从更宏观的视角看,Xiaomi-CocktailASR-1 的开源代表了大模型时代语音技术发展的一个重要方向:在通用 ASR 接近成熟(单词错误率在 4% 以下已经"够用")之后,竞争焦点从"能不能识别"转向"在复杂场景里能不能可靠识别"。这是技术从"实验室指标"走向"生产可用"的典型阶段——和应用层 Agent 越来越关注真实任务成功率是一个逻辑。
对企服从业者的启示有几条。第一,关注"垂直能力"型开源项目,而不是只看通用大模型。目标说话人 ASR、目标说话人 TTS、文档抽取、表格理解这些"小而美"的能力,在企业场景里的实用价值往往高于另一个通用 LLM 的百分点级提升。第二,看到大厂开源不要只看热闹,要看它的工程化程度——这个项目依赖环境极简、Apache 2.0 协议、HuggingFace 一键加载,这些都是可以立刻用到生产环境的成熟度信号。如果它在你的业务场景里能替代一个 10 万级别的第三方 API,每年就能省下一笔不小的预算。第三,提前规划"声音"作为新交互入口的布局。从智能音箱到 AI 眼镜、从会议设备到车载系统,语音入口正在爆发式增长。具备"在多人场景下精准识别"的能力,等于具备了接入这些新入口的门票。这个门票今天是免费的,因为小米开源了,但它不会永远是免费的——要么趁现在把这个能力集成进自己的产品里,要么等别人先用这个能力把客户抢走。
评论
请评价真实、客观、有价值的内容请回复有价值的信息,无意义的评论将很快被删除,账号将被禁止发言。