滴普科技的DIPU实时数据智能平台(DIPU Real-time Data Intelligence Platform,简称DIPU RDI)是一款面向企业级场景的一体化数据智能平台,旨在帮助企业实现从实时数据接入、处理、存储、治理到智能分析与业务决策的全链路能力闭环。平台以实时性为核心,融合湖仓一体架构、全链路数据治理与AI深度赋能,解决企业在数字化转型中面临的实时数据处理效率低、数据孤岛严重、治理能力薄弱、智能应用落地难等痛点,为零售、金融、制造、物流等多行业提供数据驱动的业务创新支撑。
一、核心定位与整体架构
DIPU RDI的核心理念是“实时驱动、湖仓一体、智能融合、全链路治理”。与传统数据平台相比,它打破了流批分离的壁垒,实现数据处理的实时化与一体化,同时通过内置的治理能力和智能工具,降低企业数据应用的技术门槛,加速数据价值转化。
- 实时驱动:以毫秒级实时数据处理为基础,支持从数据接入到决策输出的端到端低延迟,满足企业对实时业务(如实时推荐、反欺诈)的需求;
- 湖仓一体:统一存储结构化、半结构化、非结构化数据,融合数据湖的灵活性与数据仓库的分析能力,避免数据冗余与孤岛;
- 智能融合:内置AI建模与分析工具,将机器学习能力嵌入数据处理全流程,实现从数据到智能决策的无缝衔接;
- 全链路治理:覆盖数据从产生到消费的全生命周期治理,确保数据质量、安全与合规,为数据应用提供可靠基础。
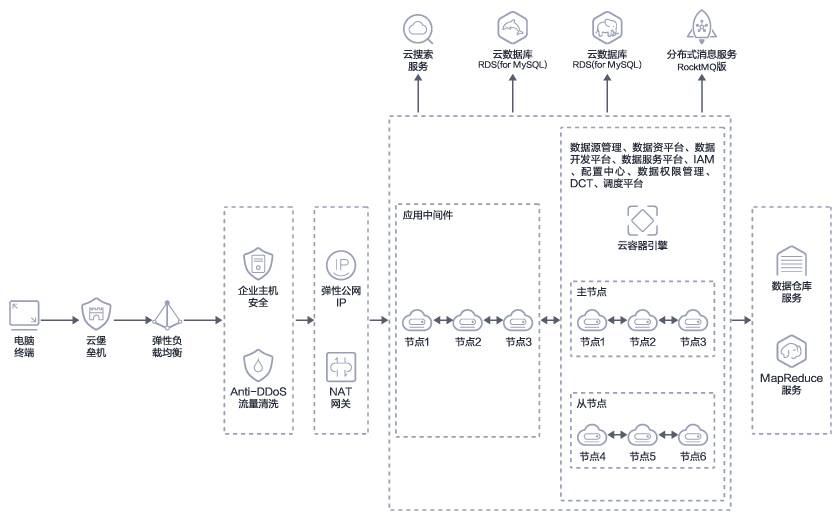
平台的逻辑架构分为七层,各层协同实现数据的全链路流转与价值输出:
- 数据源层:对接企业内外部各类数据源,包括结构化数据库、非结构化文件、消息队列、IoT设备、云服务等;
- 实时接入层:提供多模式数据接入能力,支持CDC变更捕获、实时流接入、批量导入等,保障数据实时性与一致性;
- 实时计算层:基于流批一体引擎,实现实时ETL、窗口计算、复杂事件处理等,支撑毫秒级数据加工;
- 湖仓存储层:集成Iceberg、Hudi等表格式,构建统一数据湖仓,支持ACID事务、Schema演进、时间旅行等特性;
- 数据治理层:提供元数据管理、数据血缘、质量监控、安全管控等功能,确保数据可信、可用、合规;
- 智能应用层:包含BI可视化、AI建模、数据服务等模块,支持业务人员快速构建数据应用与智能决策系统;
- 运维管控层:覆盖集群监控、作业管理、告警通知、多租户隔离等,保障平台稳定高效运行。
二、核心功能模块详解
1. 实时数据接入模块
作为数据进入平台的“第一公里”,该模块支持多源异构数据的实时与批量接入,确保数据的完整性与时效性。
- 多源异构支持:覆盖结构化数据源(MySQL、Oracle、PostgreSQL、SQL Server、达梦、人大金仓等)、半结构化数据源(JSON、XML、CSV、Parquet等)、非结构化数据源(日志文件、图片、视频、音频)、消息队列(Kafka、RocketMQ、RabbitMQ)、IoT设备(MQTT协议、传感器数据、智能终端)、云服务(AWS S3、阿里云OSS、腾讯云COS、华为云OBS)等;
- 多模式接入能力:
- CDC变更捕获:基于Debezium深度优化,支持全量+增量同步,捕获数据库表的插入、更新、删除操作,实现数据实时同步,断点续传与数据一致性校验机制保障同步过程可靠;
- 实时流接入:支持Kafka等消息队列的高并发消费,支持Exactly-Once语义,确保数据不丢不重;
- 批量导入:支持从本地文件、云存储批量导入数据,支持并行处理与压缩传输,提升导入效率;
- API拉取:通过HTTP/HTTPS接口定期拉取外部系统数据,支持自定义拉取频率与参数;
- 可视化配置:提供拖拽式界面配置接入任务,支持数据源连接测试、字段映射、转换规则定义,无需编写代码即可完成数据接入;
- 监控与告警:实时监控接入任务状态、数据量、延迟,异常时通过邮件、短信、钉钉、企业微信等渠道告警,支持任务自动重试与故障恢复。
2. 实时计算引擎模块
该模块是平台的核心处理引擎,基于Apache Flink深度优化,实现流批一体的数据处理,支持多种计算模式,满足企业不同业务场景的需求。
- 流批一体架构:统一流计算与批计算引擎,支持用同一套代码处理实时流与历史批数据,避免流批分离带来的集成成本;
- 核心计算能力:
- 实时ETL:支持数据清洗、转换、过滤、聚合等操作,实时生成干净的业务数据;
- 窗口计算:支持滑动窗口(如每5分钟统计过去10分钟订单量)、滚动窗口(如每小时统计订单总量)、会话窗口(如用户连续操作间隔不超过30秒的会话分析)、全局窗口等,满足实时统计需求;
- 复杂事件处理(CEP):支持模式匹配(如连续三次失败登录、异常交易序列),实时检测业务异常;
- 流表关联:支持流与流关联(如订单流与支付流关联)、流与静态表关联(如实时订单与商品维度表关联)、流与动态表关联(如实时订单与用户画像表关联);
- 状态管理:自研状态优化机制,支持状态持久化(RocksDB)、状态快照、状态恢复,减少内存占用,提升任务稳定性;
- 性能优化:
- 算子链优化:自动合并相邻算子,减少数据传输开销;
- 动态资源调整:基于任务负载自动扩缩容计算资源,提升资源利用率;
- 低延迟处理:通过异步IO、批量处理等技术,实现端到端延迟小于1秒;
- Exactly-Once语义:支持分布式事务,确保数据处理的准确性;
- 开发支持:提供SQL、Java/Scala、Python三种开发方式,支持Flink SQL扩展语法,内置常用函数库(如JSON解析、时间转换),可视化SQL编辑器支持语法高亮、自动补全、调试功能。
3. 湖仓一体存储模块
该模块构建统一的数据湖仓,实现数据的集中存储与高效访问,融合数据湖的灵活性与数据仓库的分析能力。
- 统一存储架构:基于分布式文件系统(HDFS)与对象存储(OSS/S3)构建,支持PB级数据存储,数据多副本(默认3副本)保障可靠性;
- 表格式支持:集成Apache Iceberg、Apache Hudi、Delta Lake等开源表格式,支持:
- ACID事务:确保多任务并发操作数据的一致性;
- Schema演进:支持字段新增、删除、类型变更,无需重写历史数据;
- 时间旅行:支持查询历史版本数据,便于数据回溯与故障排查;
- 分区与索引:支持按时间、地域等维度分区,内置布隆过滤器、Z-Order索引,提升查询性能;
- 数据分层存储:支持热数据(最近7天数据)存储在SSD,温数据(7天-30天数据)存储在HDD,冷数据(30天以上数据)归档到低成本对象存储,降低存储成本;
- 多引擎访问:支持Flink、Spark、Presto、Impala、Hive等多种计算引擎访问,统一元数据管理,避免数据孤岛;
- 数据压缩与加密:支持Snappy、Gzip、LZ4等压缩算法,减少存储占用;支持传输加密(TLS 1.2+)与存储加密(AES-256),保障数据安全。
4. 数据治理中心模块
该模块覆盖数据全生命周期治理,确保数据质量、安全、合规,为数据应用提供可信基础。
- 元数据管理:
- 自动采集:实时采集数据源、表结构、字段类型、存储位置、访问频率、任务依赖等技术元数据,以及数据字典、业务术语、数据owner、数据血缘等业务元数据;
- 数据资产目录:构建企业级数据资产目录,支持全文检索、按标签筛选、数据详情查看,帮助用户快速找到所需数据;
- 元数据版本管理:记录元数据变更历史,支持版本回溯与对比;
- 数据血缘管理:
- 端到端血缘追踪:从数据源到数据应用(报表、API)的全链路血缘关系,图形化展示节点-边关系,支持缩放、拖拽、钻取;
- 影响分析:当上游数据变更时,快速识别下游受影响的任务、报表、API,辅助变更评估;
- 溯源分析:当数据出现错误时,追溯到上游数据源或处理环节,快速定位问题;
- 数据质量管理:
- 规则定义:支持完整性(如字段非空)、准确性(如数值范围)、一致性(如跨表字段一致)、唯一性(如主键不重复)、及时性(如数据延迟不超过5分钟)等规则,支持自定义SQL规则;
- 监控与告警:定时或实时执行质量检查,异常时触发告警,支持按规则 severity 分级告警;
- 质量报告:生成数据质量评分、异常统计、趋势分析报告,帮助用户了解数据质量状况;
- 数据修复:支持自动修复(如缺失值填充)与手动修复,记录修复历史;
- 数据安全管理:
- 身份认证:支持LDAP、OAuth2.0、SSO单点登录,保障用户身份可信;
- 权限控制:基于RBAC模型,支持细粒度权限(库、表、列、行级权限),如限制某用户只能访问特定区域的订单数据;
- 数据脱敏:支持静态脱敏(存储时脱敏)与动态脱敏(查询时脱敏),如手机号隐藏中间四位、身份证号隐藏部分字段;
- 访问审计:记录所有用户的操作日志(登录、查询、修改),支持日志检索与导出,满足合规要求;
- 数据水印:支持为敏感数据添加水印,防止数据泄露;
- 合规管理:支持GDPR、等保2.0、PCI DSS等合规标准,提供合规检查工具与报告,帮助企业满足监管要求。
5. 智能分析与建模模块
该模块将AI能力嵌入数据平台,支持业务人员快速构建智能应用,实现数据到决策的转化。
- BI可视化分析:
- 拖拽式报表设计:支持柱状图、折线图、饼图、地图、热力图、漏斗图、雷达图等20+可视化图表,无需编码即可构建报表;
- 多维度分析:支持切片、钻取、旋转、筛选等操作,深入分析数据背后的规律;
- 实时可视化:支持实时数据刷新(秒级更新),展示实时业务指标(如实时销售额、订单量);
- 仪表板:支持自定义仪表板,整合多个报表,直观展示业务全景;
- 分享与协作:支持报表/仪表板分享给团队成员,设置查看权限,支持评论与反馈;
- AI建模平台:
- 低代码/无代码开发:拖拽式界面完成数据预处理、特征工程、模型训练、部署全流程;
- 数据预处理:支持缺失值填充、异常值处理、数据标准化、特征编码(One-Hot、Label Encoding)等;
- 特征工程:支持特征选择(相关性分析、PCA)、特征构造(滑动窗口统计、时间特征提取);
- 模型训练:集成TensorFlow、PyTorch、Scikit-learn等框架,支持分类(逻辑回归、随机森林、XGBoost)、回归(线性回归、LSTM)、聚类(K-Means)、时间序列预测(ARIMA、Prophet)等算法;
- 自动机器学习(AutoML):支持自动特征选择、模型选择、超参数调优,降低AI门槛;
- 模型部署:支持将模型部署为在线服务(RESTful API)或批量服务,支持模型版本管理;
- 模型监控:实时监控模型性能(准确率、召回率、F1值)、漂移检测(数据漂移、概念漂移),异常时告警;
- 预测分析应用:内置常用预测模板,如销量预测、客户流失预测、设备故障预测、 fraud detection等,用户可快速复用模板构建应用。
6. 数据服务与API网关模块
该模块解决数据“最后一公里”问题,将数据转化为可复用的服务,支撑业务系统快速调用。
- 数据服务封装:支持将表、视图、SQL查询、实时数据流、AI模型结果封装为RESTful API、GraphQL API、WebSocket API;
- RESTful API:支持GET/POST/PUT/DELETE方法,支持参数传递与响应格式自定义;
- GraphQL API:支持按需查询数据,减少网络传输量;
- WebSocket API:支持实时数据推送(如实时订单通知、设备状态更新);
- API生命周期管理:
- 创建与测试:可视化配置API参数、响应格式,支持在线测试;
- 发布与版本控制:支持API发布到测试/生产环境,版本管理避免影响现有服务;
- 下线与归档:支持API下线,归档历史版本;
- API网关:
- 路由转发:统一入口管理所有API,支持负载均衡;
- 限流与熔断:支持QPS限制、并发数限制,防止服务过载;支持熔断机制,避免故障扩散;
- 认证授权:支持API Key、OAuth2.0、JWT等认证方式,确保API安全;
- 监控与统计:实时监控API调用量、响应时间、错误率,生成统计报表;
- 数据共享:支持跨部门、跨企业的数据安全共享,通过数据沙箱(隔离敏感数据)、脱敏后共享、API授权等方式,实现数据价值最大化。
7. 可视化开发与运维模块
该模块降低平台使用与运维门槛,提升开发效率与平台稳定性。
- 可视化开发平台:
- 拖拽式任务编排:支持流任务、批任务、混合任务的可视化编排,定义任务依赖关系;
- 任务调度:支持定时调度(如每天凌晨1点执行)、事件触发(如数据到达触发)、依赖触发(如上游任务完成触发);
- 版本管理:支持任务版本控制,可回滚到历史版本;
- 调试与日志:支持任务在线调试,实时查看执行日志,快速定位问题;
- 运维监控中心:
- 集群监控:实时监控集群节点的CPU、内存、磁盘、网络、IOPS等指标,支持阈值告警;
- 引擎监控:监控Flink、Spark等计算引擎的任务状态、资源占用、延迟、吞吐量等;
- 存储监控:监控存储容量、使用率、读写速度等;
- 作业监控:实时查看作业执行进度、成功/失败次数、耗时等,支持作业重试与终止;
- 告警中心:
- 自定义告警规则:支持按指标(如CPU使用率>80%)、事件(如作业失败)设置规则;
- 多渠道通知:支持邮件、短信、钉钉、企业微信、Slack等渠道;
- 告警聚合与升级:支持告警聚合(如同一节点多次告警合并)、告警升级(如10分钟未处理升级到上级);
- 多租户管理:
- 租户隔离:支持数据隔离(每个租户有独立的数据库/表空间)、资源隔离(CPU、内存、存储配额)、权限隔离;
- 资源配额:按租户分配计算与存储资源,支持动态调整;
- 租户计量:统计租户资源使用情况,生成计费报表;
- 日志管理:
- 集中式日志收集:基于ELK Stack(Elasticsearch、Logstash、Kibana)收集平台所有日志;
- 日志检索:支持按关键词、时间范围、模块检索日志;
- 日志分析:生成日志统计报表,帮助定位系统瓶颈;
三、技术特点与优势
- 极致实时性:端到端数据处理延迟小于1秒,支持毫秒级实时计算,满足实时业务场景需求;
- 湖仓一体架构:统一存储与分析能力,避免数据冗余,降低存储成本,提升数据访问效率;
- 全链路数据治理:覆盖数据从接入到应用的全生命周期治理,确保数据质量、安全与合规;
- 低代码/无代码开发:拖拽式界面降低技术门槛,业务人员可快速构建数据应用与AI模型;
- 高扩展性:分布式架构支持线性扩展,可处理PB级数据,支持上万并发任务;
- 高可靠性:数据多副本存储、任务自动重试、状态持久化,确保系统7x24小时稳定运行;
- 开放兼容:兼容开源生态(Flink、Spark、Iceberg等),支持与第三方工具(Tableau、Power BI、Superset)集成;
- 国产化适配:支持国产芯片(鲲鹏、飞腾)、国产操作系统(麒麟、统信UOS)、国产数据库(达梦、人大金仓、OceanBase),满足信创要求;
- 灵活部署:支持私有云、公有云(阿里云、AWS、腾讯云)、混合云部署,适应不同企业IT环境;
- AI深度融合:内置AI建模工具,将机器学习能力嵌入数据流程,加速智能应用落地。
四、典型应用场景
- 零售行业-实时个性化推荐:通过实时采集用户浏览、点击、购买行为数据,实时更新用户画像,基于AI模型生成个性化推荐结果,通过API推送到电商平台,提升用户转化率;
- 金融行业-实时反欺诈:实时采集用户交易数据、登录数据、设备数据,通过CEP引擎检测异常行为(如异地登录+大额转账),实时触发告警并拦截交易,降低欺诈风险;
- 制造行业-设备预测性维护:实时采集设备传感器数据(温度、振动、压力),通过AI模型分析设备健康状态,预测故障发生时间,提前安排维护,减少停机时间;
- 物流行业-实时轨迹追踪:实时采集物流车辆GPS数据,通过地图可视化展示车辆位置,结合交通数据优化配送路径,实时通知客户配送进度;
- 互联网行业-实时运营监控:实时统计DAU、MAU、PV/UV、订单量等核心指标,通过仪表板展示运营状态,异常时触发告警,快速响应业务变化;
- 政府行业-城市交通实时监控:实时采集交通信号灯数据、摄像头数据、车辆GPS数据,分析交通流量,动态调整信号灯时长,缓解交通拥堵。
五、总结
DIPU实时数据智能平台(DIPU RDI)通过实时驱动、湖仓一体、智能融合与全链路治理的核心能力,为企业提供了一套完整的数据智能解决方案。它不仅解决了企业实时数据处理的痛点,还通过内置的治理与智能工具,降低了数据应用的技术门槛,加速了数据价值的转化。无论是零售、金融、制造还是政府等行业,DIPU RDI都能帮助企业构建数据驱动的业务体系,实现数字化转型的目标。
了解更多产品详情,请访问滴普科技官网:
登录后查看
https://www.deepexi.com/" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0, null, null, null, null, null, 9, null, 0, 0, null, 0, null, 0, null, 0, 0, null, 0);">https://www.deepexi.com/




 微信订阅号
 微信服务号
 微信客服(加群)
 H5
 小程序