








阿里云(Alibaba Cloud,全称阿里云计算有限公司)创立于 2009 年,总部位于中国杭州,是阿里巴巴集团旗下的云计算与人工智能科技旗舰,
阿里数据湖
68.03条评价745次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
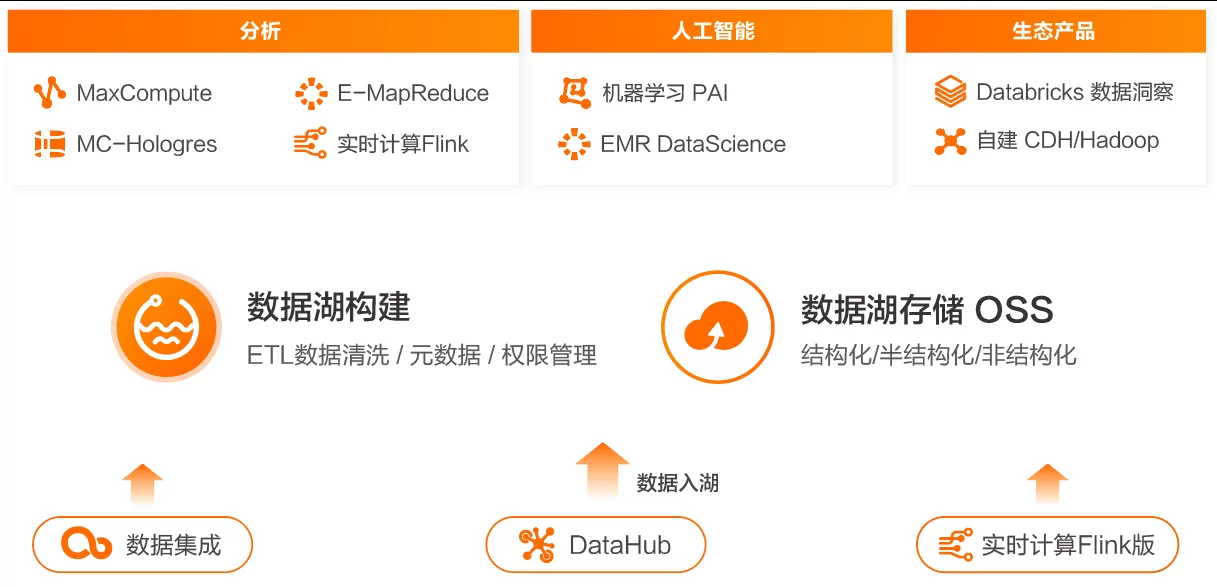
阿里云数据湖是一款面向企业级应用的一站式、一体化数据湖平台。其核心目标是帮助企业客户构建统一、高效、安全的数据资产中心,实现多源异构数据的集成、存储、计算、治理与服务化,从而挖掘数据价值,驱动业务创新。该平台并非单一工具,而是融合了数据集成、统一存储、多引擎计算、数据治理、开发运维、数据服务等能力的综合性产品套件,覆盖数据从产生到价值变现的全生命周期。
一、核心定位与整体架构
阿里云数据湖的核心理念是“统一化”与“企业级”。与传统数据湖依赖开源组件堆砌的方式不同,它通过一体化平台设计,降低技术门槛与运维复杂度,同时提供企业级所需的可靠性、安全性、弹性扩展与合规性。
- 统一化:提供从数据接入、存储、计算到治理、服务的全链路能力,用户可在统一平台完成绝大多数数据工作,避免跨工具切换的集成成本与协作壁垒。
- 企业级:基于阿里云云原生技术栈(如OSS、DataWorks、DLA等),结合开源生态(Spark、Flink、Iceberg等)的深度优化,强化稳定性、安全性、多租户管控与可视化运维,满足金融、政府、零售等行业的严苛要求。
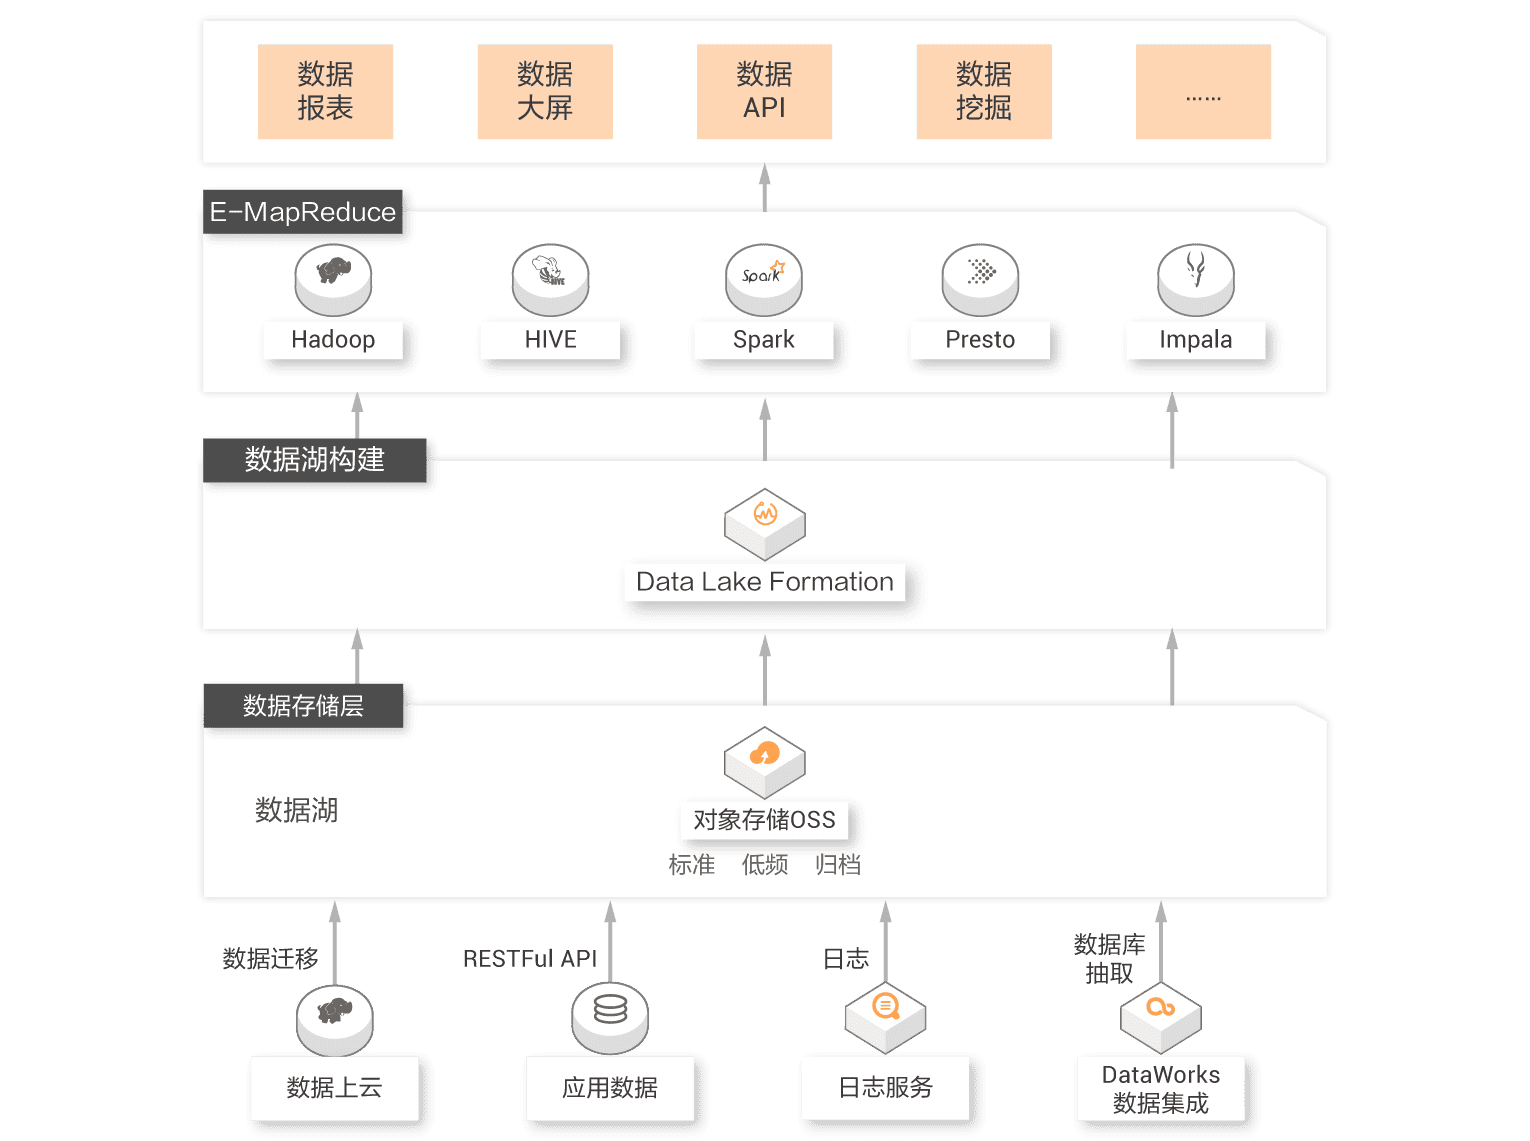
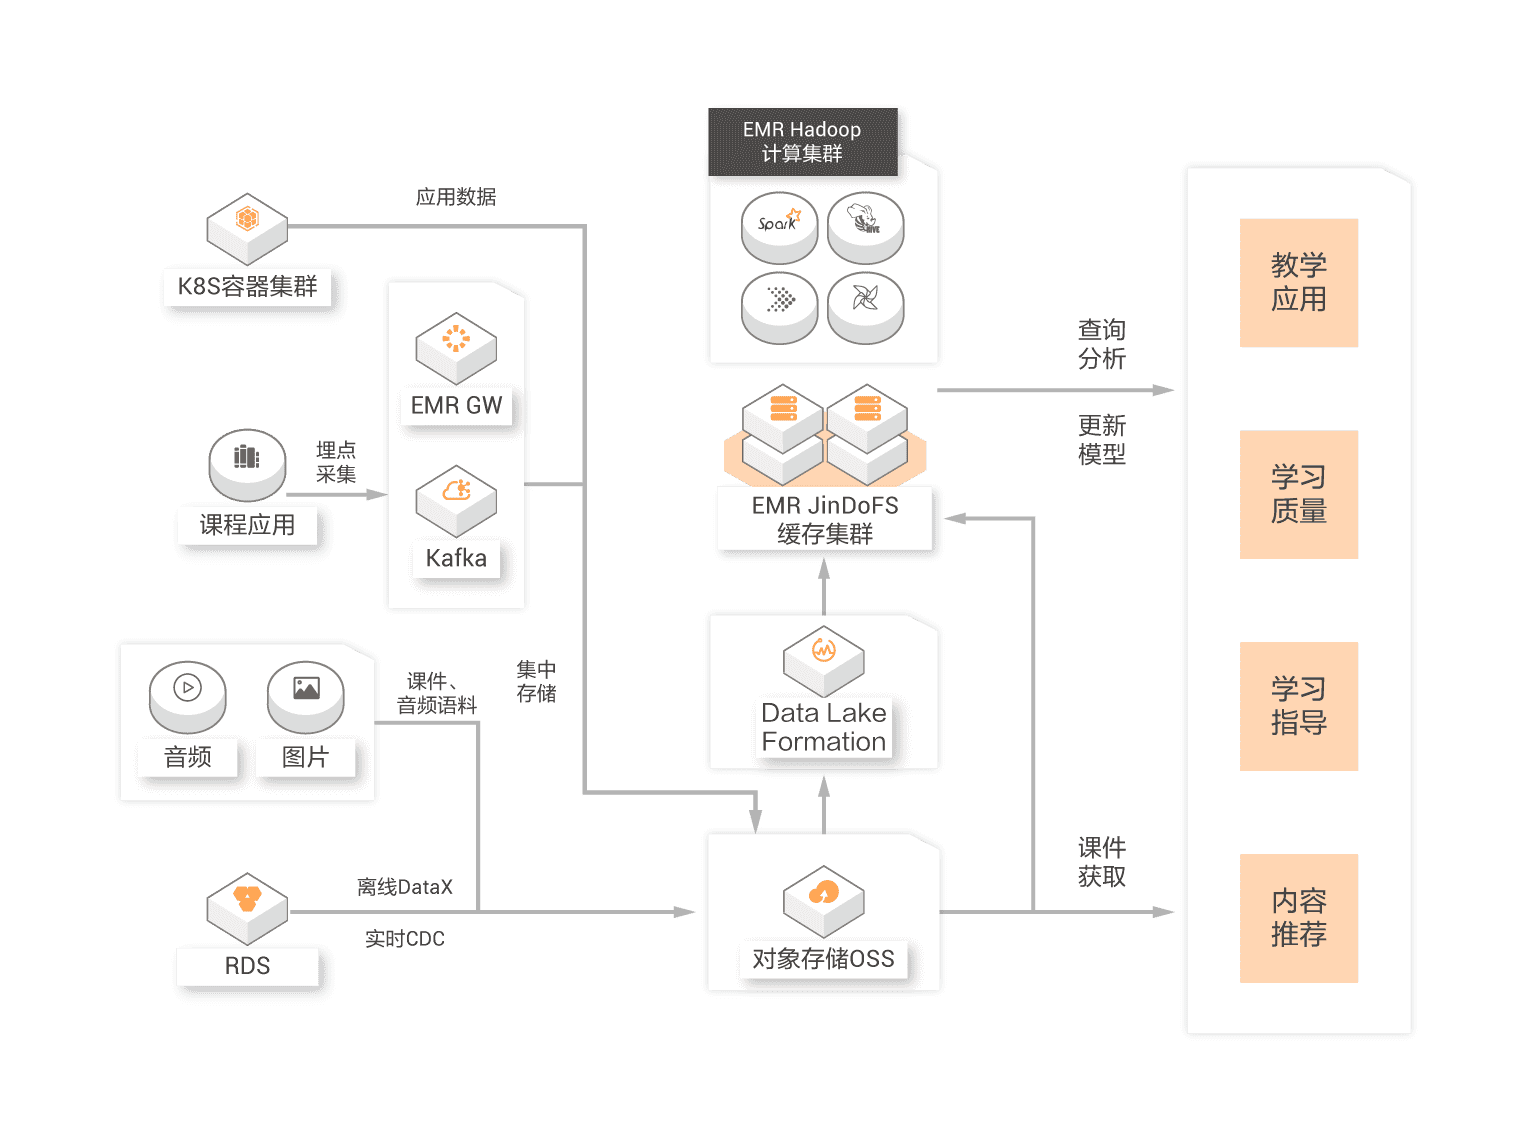
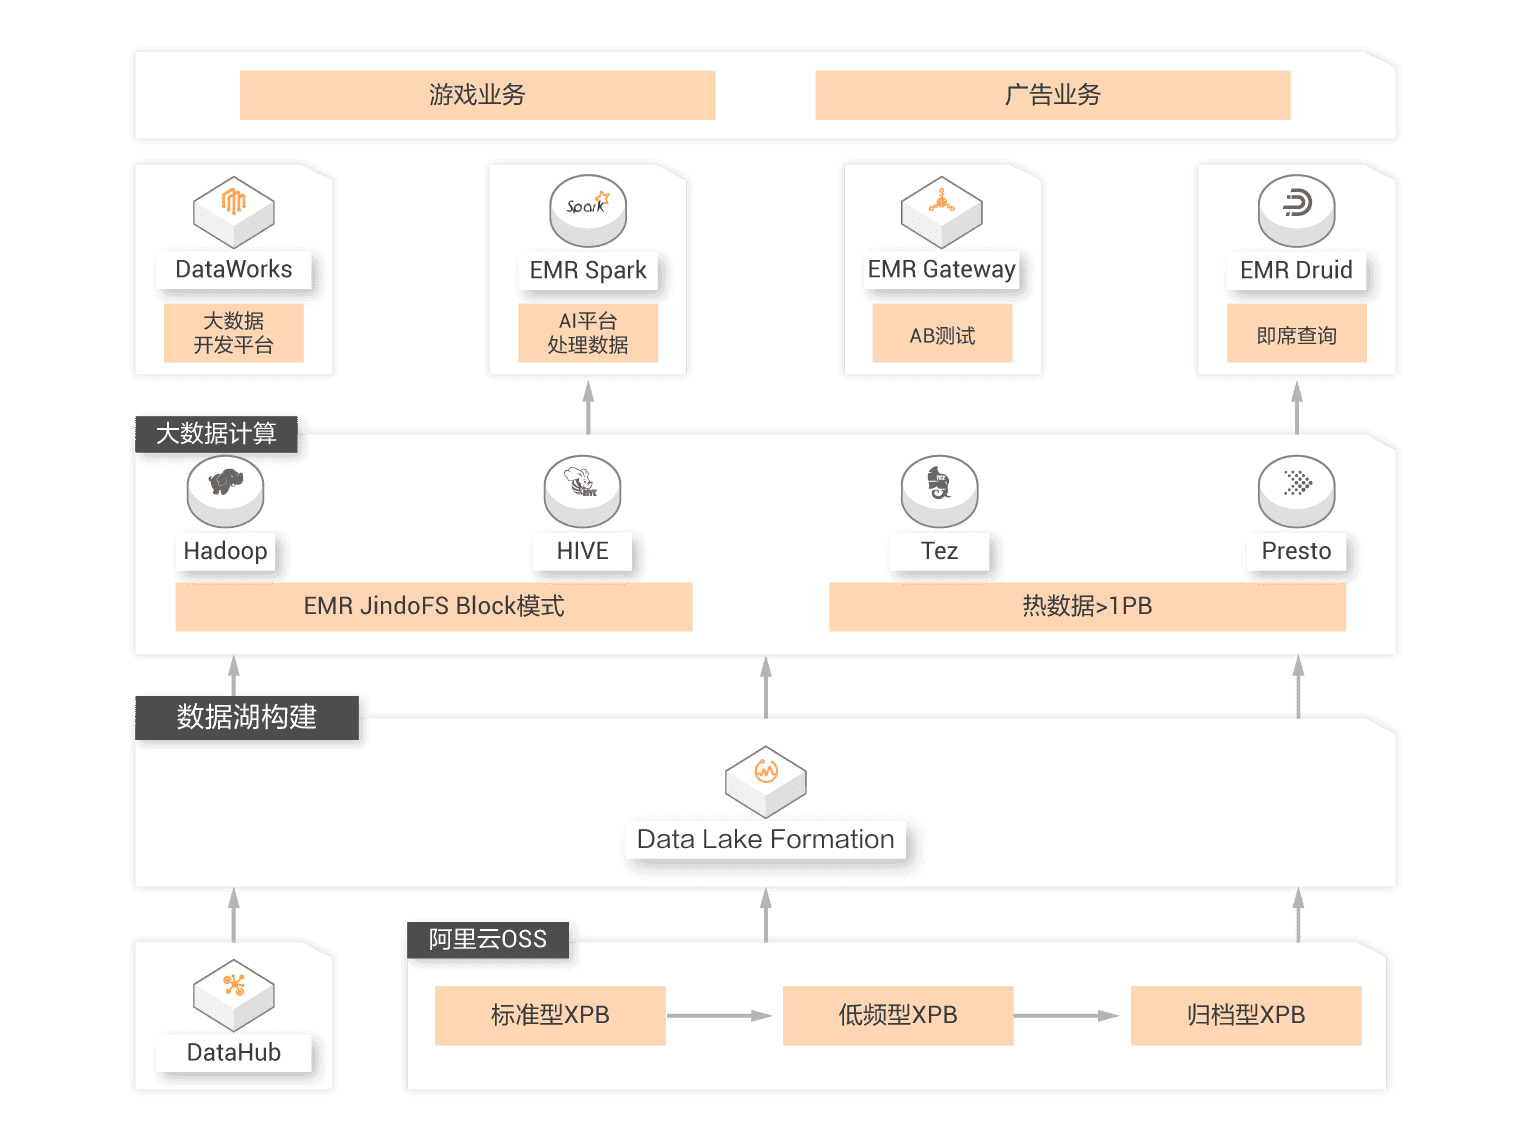
平台的逻辑架构分为以下七层:
- 数据源层:对接各类结构化、半结构化与非结构化数据源,包括关系型数据库、NoSQL、大数据组件、消息队列、日志系统、云服务等。
- 数据集成层:提供离线/实时数据同步能力,支持全量、增量(CDC)与流同步,实现数据向数据湖的高效导入。
- 统一存储层:基于OSS构建低成本、高可靠的存储底座,支持多种数据格式与事务型表格式(Iceberg/Hudi),实现湖仓一体存储。
- 计算引擎层:集成Serverless与分布式计算引擎,支持批处理、流计算、交互式查询等多种计算模式,引擎间协同工作。
- 数据治理层:提供元数据管理、数据血缘、数据质量、数据安全等功能,保障数据资产的可见性、可靠性与合规性。
- 服务与应用层:封装数据服务API,支持BI分析、AI建模、业务系统集成等应用场景,实现数据价值的最终交付。
- 运维监控层:全方位监控平台资源、作业状态与数据质量,提供告警与日志分析,确保平台稳定运行。
二、核心功能模块详解
1. 数据集成模块
数据集成是数据入湖的“第一公里”,阿里云数据湖提供强大、灵活的多源数据同步能力,支持离线与实时场景,简化数据接入流程。
- 多源异构数据支持:覆盖主流数据源类型,包括:
- 关系型数据库:MySQL、Oracle、SQL Server、PostgreSQL、DB2等;
- NoSQL数据库:MongoDB、Redis、Cassandra、HBase等;
- 大数据组件:HDFS、Hive、Spark、Flink、Kafka、RocketMQ等;
- 云服务:阿里云RDS、OSS、MaxCompute、SLS(日志服务)、CDN日志等;
- 文件与API:CSV、JSON、Parquet、ORC等格式文件,RESTful API、SOAP API等。
- 多种同步模式:
- 全量同步:一次性导入数据源中的所有数据,适用于初始化数据湖场景;
- 增量同步:基于CDC(变更数据捕获)技术,捕获数据源的新增、修改、删除数据,支持MySQL binlog、Oracle redo log、MongoDB oplog等,实现数据准实时更新;
- 实时流同步:对接Kafka、RocketMQ等消息队列,实时消费流数据并写入数据湖,延迟低至毫秒级;
- 定时同步:按自定义周期(天、小时、分钟)执行同步任务,适用于离线批量场景。
- 可视化配置与自动化:
- 通过DataWorks数据集成界面,拖拽式配置同步任务,无需编写代码;
- 自动生成同步脚本,支持自定义SQL过滤数据;
- 设置容错机制:断点续传(针对大文件同步)、重试策略(失败后自动重试)、脏数据处理(丢弃、写入错误表、告警);
- 任务依赖管理:支持多个同步任务的顺序执行或并行执行,满足复杂业务流程。
2. 统一存储模块
统一存储是数据湖的基础,阿里云数据湖基于对象存储OSS构建,提供低成本、高可靠、弹性扩展的存储能力,支持湖仓一体架构。
- 低成本高可靠存储底座:
- 基于阿里云OSS,提供99.995%的服务可用性与11个9的数据持久性;
- 支持冷热分层存储:标准存储(高频访问)、低频访问存储(低频访问)、归档存储(长期归档),自动或手动切换存储类型,降低成本;
- 弹性扩展:存储容量无上限,按需扩容,无需提前规划。
- 多格式数据支持:
- 支持结构化数据(CSV、JSON、Parquet、ORC、Avro等)、半结构化数据(XML、日志文件)、非结构化数据(图片、视频、文档等)的混合存储;
- 兼容开源数据格式,无需转换即可直接访问,保护用户现有投资。
- 事务型表格式支持:
- 集成Apache Iceberg与Apache Hudi,实现数据湖的事务能力,支持:
- ACID事务:确保多并发操作的数据一致性;
- 版本管理与回滚:保留数据历史版本,可回滚到任意版本,支持数据审计与恢复;
- Schema Evolution:允许表结构的新增、修改、删除字段,无需重新导入数据;
- 增量数据处理:高效读取新增数据,降低计算成本。
- 集成Apache Iceberg与Apache Hudi,实现数据湖的事务能力,支持:
- 湖仓一体集成:
- 支持数据湖与数据仓(如MaxCompute)的无缝集成,数据湖中的数据可直接被MaxCompute查询,MaxCompute的数据也可写入数据湖;
- 消除数据湖与数据仓之间的数据移动,提高数据处理效率,降低存储成本。
3. 计算引擎模块
计算引擎是数据湖的核心动力,阿里云数据湖提供多种计算引擎,支持批处理、流计算、交互式查询等场景,引擎间协同工作,满足不同业务需求。
- Serverless交互式查询引擎(DLA):
- Serverless架构:无需部署集群,按需启动,自动扩缩容,按使用量付费;
- 兼容ANSI SQL:支持查询OSS上的Parquet、ORC、CSV等格式数据,以及Iceberg、Hudi表;
- 高性能:基于MPP架构,支持PB级数据的秒级查询;
- 多数据源查询:可同时查询OSS数据湖、RDS、MaxCompute等数据源,实现跨源分析;
- BI工具集成:支持Tableau、Power BI、FineBI等主流BI工具,直接连接DLA进行可视化分析。
- 分布式批处理引擎(Spark on OSS):
- 基于Apache Spark优化,支持大规模离线数据处理;
- 直接读取OSS上的数据,无需将数据移动到Spark集群;
- 支持Spark SQL、DataFrame API、MLlib等,适用于ETL、数据清洗、机器学习等场景;
- 与DataWorks集成,可视化开发Spark作业,简化开发流程。
- 实时流计算引擎(Flink on OSS):
- 基于Apache Flink优化,支持低延迟、高吞吐的实时数据处理;
- 实时消费Kafka、RocketMQ等流数据,写入OSS数据湖的Iceberg/Hudi表,实现Exactly-Once语义;
- 支持流批一体:同一作业可处理流数据与批数据,简化开发;
- 适用于实时监控、实时推荐、实时风控等场景。
- 引擎协同能力:
- 多种引擎共享同一数据湖存储,避免数据冗余;
- 支持引擎间的数据流转:比如Flink实时写入Iceberg表,Spark进行离线批处理,DLA进行交互式查询;
- 统一元数据管理:通过DLF(数据湖元数据服务)共享元数据,确保不同引擎看到的数据一致。
4. 数据治理模块
数据治理是确保数据湖数据质量与价值的关键,阿里云数据湖提供全面的数据治理能力,帮助企业构建可信的数据资产中心。
- 元数据管理(DLF):
- 统一元数据存储:管理数据湖中的表结构、分区信息、数据位置、字段注释等元数据;
- 自动元数据采集:发现OSS上的数据文件,自动生成表结构,支持手动注册元数据;
- 跨引擎元数据共享:DLA、Spark、Flink等引擎共享同一元数据,确保数据一致性;
- 数据资产目录:可视化展示数据资产,支持按主题、标签、数据源等维度检索,实现数据资产的可见性。
- 数据血缘分析:
- 全链路数据血缘:追踪数据从来源到消费的完整加工链路,包括数据源、同步任务、计算作业、输出表等;
- 图形化展示:通过血缘图谱直观查看数据流转路径,支持向上溯源(数据来自哪里)与向下影响分析(数据影响哪些下游);
- 应用场景:数据质量问题定位、变更影响评估、合规审计等。
- 数据质量监控:
- 规则定义:支持自定义数据质量规则,包括完整性(非空检查)、准确性(格式检查)、一致性(跨表字段一致)、唯一性(主键唯一)、范围(数值在指定范围)等;
- 定时检查:按自定义周期执行数据质量检查,生成质量报告;
- 异常告警:当数据质量不达标时,通过短信、邮件、钉钉等方式通知相关人员;
- 数据质量仪表盘:可视化展示数据质量得分、异常趋势、规则通过率等指标。
- 数据安全与合规:
- 身份认证:基于阿里云RAM(资源访问管理),支持多因素认证,确保用户身份安全;
- 权限控制:RBAC(基于角色的访问控制),支持库、表、列级权限,以及行级过滤(比如不同用户只能看到自己部门的数据);
- 数据脱敏:对敏感数据(如手机号、身份证号)进行脱敏处理,比如隐藏中间四位、替换为星号;
- 加密:传输加密(HTTPS)、存储加密(OSS服务端加密、客户端加密);
- 访问审计:通过ActionTrail记录所有数据湖操作,包括用户登录、数据查询、作业执行等,满足合规要求(如等保2.0、GDPR)。
5. 数据开发模块
数据开发模块简化数据湖的开发流程,提供可视化工具,降低技术门槛,提高开发效率。
- 可视化作业开发:
- 基于DataWorks平台,提供拖拽式作业编排界面,支持同步任务、Spark作业、Flink作业、SQL查询等组件;
- 作业依赖管理:设置作业之间的先后顺序,比如同步任务完成后执行Spark ETL作业;
- 版本控制:保存作业的历史版本,支持回滚到任意版本,便于协作与调试。
- 多引擎代码开发:
- 支持SQL、Scala、Python等语言,开发Spark、Flink作业;
- 代码编辑器:提供语法高亮、自动补全、错误提示等功能;
- 调试与测试:支持本地调试与云端测试,查看作业日志与运行结果。
- 调度与监控:
- 自定义调度周期:按天、小时、分钟执行作业,支持 cron 表达式;
- 作业监控:实时查看作业执行状态、进度、资源消耗;
- 失败重试:作业失败后自动重试,设置重试次数与间隔;
- 告警通知:作业失败或超时后发送告警。
6. 数据服务模块
数据服务模块实现数据湖数据的服务化,将数据转化为API,方便业务系统调用,实现数据价值的最终交付。
- 数据服务封装:
- 将数据湖中的表、SQL查询结果或预处理数据封装为RESTful API;
- 支持自定义API参数:比如按日期范围查询数据;
- 响应格式:支持JSON、XML等格式。
- API生命周期管理:
- API发布:将API发布到阿里云API网关,设置访问路径;
- 权限控制:设置API的访问权限,比如只允许特定应用或用户访问;
- 限流与熔断:设置API的调用频率限制,避免过载;当API异常时自动熔断,保护后端服务;
- 版本管理:支持API的多版本,平滑升级,避免影响现有业务。
- 服务监控与分析:
- 监控API的调用量、响应时间、错误率等指标;
- 生成API调用报表,分析业务使用情况;
- 告警通知:当API响应时间过长或错误率过高时发送告警。
- 业务系统集成:
- 支持与CRM、ERP、OA等业务系统集成,提供实时数据支持;
- 与函数计算、逻辑流等云服务集成,实现自动化业务流程。
7. 运维监控模块
运维监控模块确保数据湖平台的稳定运行,提供全方位的监控与告警能力。
- 集群与资源监控:
- 监控OSS存储用量、DLA CU(计算单元)使用量、Spark/Flink集群资源(CPU、内存、磁盘);
- 通过CloudMonitor查看资源使用趋势,提前预警资源不足。
- 作业监控:
- 实时查看同步任务、Spark/Flink作业、DLA查询的执行状态;
- 查看作业日志:通过SLS收集作业日志,支持日志检索与分析;
- 作业性能分析:查看作业的执行时间、资源消耗,优化作业性能。
- 告警中心:
- 自定义告警规则:比如作业失败次数超过3次、DLA查询响应时间超过10秒、数据质量不达标等;
- 多渠道通知:短信、邮件、钉钉、企业微信等;
- 告警聚合:将重复告警聚合,避免信息轰炸。
- 多租户管理:
- 支持多租户隔离:不同租户的数据与资源相互独立,互不干扰;
- 资源配额管理:为每个租户分配存储与计算资源配额,避免资源滥用;
- 租户权限管理:每个租户只能访问自己的数据与资源。
三、技术特点与优势
阿里云数据湖凭借云原生技术与开源生态的深度整合,具备以下核心优势:
- 云原生Serverless架构:无需运维集群,按需使用,弹性扩展,降低运维成本与门槛;按使用量付费,避免资源浪费。
- 湖仓一体架构:统一存储底座,多种计算引擎协同,消除数据湖与数据仓之间的数据移动,提高效率,降低存储成本。
- 开放兼容生态:支持开源数据格式(Parquet、ORC、Iceberg、Hudi)与计算引擎(Spark、Flink、Presto),保护用户现有投资,避免厂商锁定。
- 高可靠与高可用:基于OSS的多副本存储,确保数据不丢失;计算引擎容错机制,作业失败自动重试;关键组件高可用部署,保障服务不中断。
- 全面数据治理能力:元数据管理、数据血缘、数据质量、数据安全等功能,确保数据资产的可信性与合规性。
- 低成本:OSS存储成本低,Serverless计算按需付费,整体TCO(总拥有成本)远低于传统大数据平台。
- 易用性:可视化开发界面,拖拽式作业编排,简化开发流程;与DataWorks深度集成,提供一站式数据开发体验。
四、典型应用场景
阿里云数据湖适用于各类行业与场景,以下是几个典型案例:
- 企业数据中台建设:
- 整合企业内部各业务系统(CRM、ERP、OA等)的数据,构建统一的数据资产中心;
- 通过数据治理确保数据质量,提供可信的数据服务;
- 支持业务部门的自助分析与决策,驱动业务创新。
- 实时数据分析与监控:
- 对接电商平台的用户行为数据与交易数据,通过Flink实时处理,写入Iceberg表;
- 用DLA进行实时查询,生成实时销售报表、用户画像;
- 实时监控系统运行状态,发现异常及时告警。
- 离线批量数据处理:
- 处理PB级的日志数据,通过Spark进行ETL清洗、聚合;
- 生成离线报表,用于业务分析与决策;
- 支持机器学习模型训练,比如用户推荐模型、风控模型。
- 自助分析与BI可视化:
- 业务人员通过Tableau、Power BI连接DLA,直接查询数据湖中的数据;
- 生成可视化报表与仪表盘,快速获取业务 insights;
- 无需依赖IT部门,实现自助分析。
- 金融风控与合规:
- 实时处理交易数据,通过Flink进行风控规则检查,识别异常交易;
- 数据血缘与访问审计,满足金融行业的合规要求;
- 数据脱敏处理,保护用户隐私。
- 零售用户画像与精准营销:
- 整合用户的线上行为、线下消费、社交数据等,构建360度用户画像;
- 通过数据湖分析用户偏好,实现精准营销;
- 实时推荐商品,提高转化率。
总结
阿里云数据湖是一款面向企业级的一站式数据湖平台,整合了数据集成、统一存储、多引擎计算、数据治理、开发运维、数据服务等全链路能力。它基于云原生Serverless架构,支持湖仓一体,开放兼容开源生态,具备高可靠、低成本、易用性等优势。通过阿里云数据湖,企业可以打破数据孤岛,构建统一的数据资产中心,挖掘数据价值,驱动业务创新。无论是实时数据分析、离线批量处理、自助BI还是数据中台建设,阿里云数据湖都能提供高效、安全的解决方案,帮助企业加速数字化转型。
了解更多产品详情,请访问阿里云数据湖官方网站:
登录后查看
https://www.aliyun.com/product/bigdata击链" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0);">https://www.aliyun.com/product/bigdata


展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
68.0分项目
评分
同类平均分
综合
68
70
兼容性
66
70
稳定性
70
74
易用性
66
68
性能
74
76
市场占有率
64
70
功能
74
72
扩展性
60
66
美观度
64
70
技术服务
70
70
性价比
66
68
时间排序↓
最新
精华
3 条评论

向我咨询

发表评论