








Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者在网站中的所有动作流数据。
Kafka
65.06条评价764次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
Apache Kafka是一款开源的分布式事件流平台,旨在为企业提供高吞吐、低延迟、高可靠的事件发布/订阅、存储与流处理能力。它支持无界事件流的实时处理,连接各类系统与应用,帮助企业构建事件驱动架构、实时数据管道与流分析系统,是现代数据基础设施的核心组件之一。
一、核心定位与整体架构
Kafka的核心定位是企业级分布式事件流平台,其设计目标是处理海量、持续生成的事件数据,同时保证系统的可扩展性、可用性与性能。它不仅是消息队列,更是集事件存储、流处理、数据集成于一体的完整解决方案。
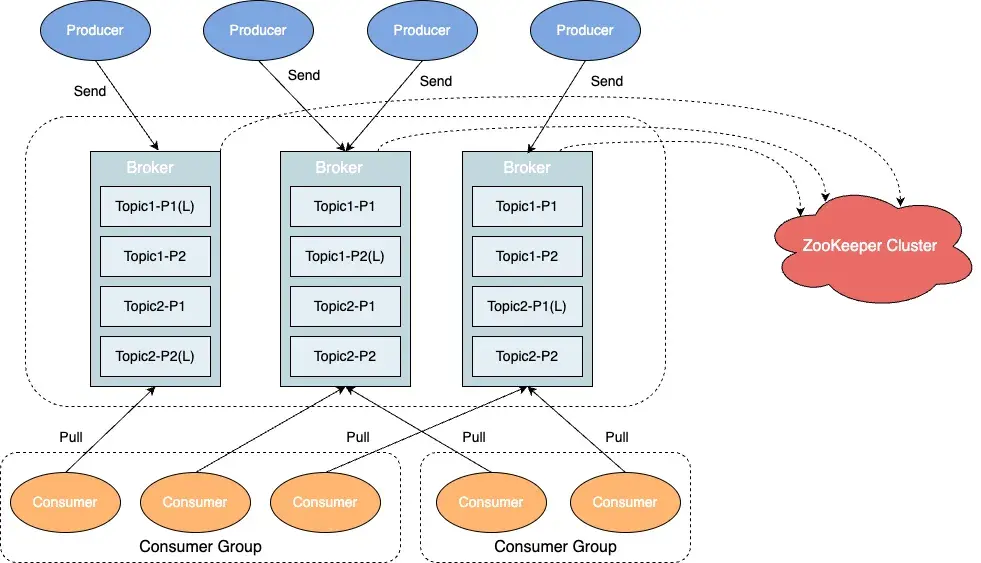
Kafka的整体架构遵循分布式设计原则,主要包含以下核心组件:
- Producer(生产者):负责向Kafka集群发送事件数据,支持批量发送、压缩、分区路由等特性。
- Broker(代理节点):Kafka集群的核心节点,负责存储事件数据、处理生产者与消费者的请求,支持水平扩展。
- Consumer(消费者):从Kafka集群读取事件数据,支持消费组、位移管理、再平衡等机制,实现并行消费。
- Kafka Connect:用于连接外部系统(如数据库、文件系统、搜索引擎)与Kafka,实现数据的批量导入/导出。
- Kafka Streams:轻量级流处理框架,嵌入应用内部,支持实时事件处理、聚合、连接等操作。
- KRaft Controller(控制器):在KRaft模式下,负责管理集群元数据(如Topic配置、分区状态),替代传统的ZooKeeper依赖。
Kafka的逻辑架构可分为以下几层:
- 事件生产层:包含各类Producer客户端,支持多语言接入,将事件数据发送至Broker集群。
- 消息存储层:由Broker节点组成,通过Topic与Partition机制存储事件数据,保证高可用与持久性。
- 消费处理层:包含Consumer客户端与消费组,实现事件数据的并行读取与处理。
- 数据集成层:通过Kafka Connect连接外部系统,实现数据的双向流动。
- 流处理层:基于Kafka Streams实现实时事件分析与转换。
- 监控管理层:提供Metrics指标、安全控制、集群管理等功能,保障系统稳定运行。
二、核心功能模块详解
1. 事件生产与消费模块
事件生产与消费是Kafka的基础功能,负责事件数据的输入与输出,支持高吞吐、低延迟的传输。
- Producer特性:
- 批量发送:Producer将多个事件数据批量打包发送,减少网络请求次数,提升吞吐量。可通过
batch.size与linger.ms配置批量大小与等待时间。 - 数据压缩:支持GZIP、Snappy、LZ4等压缩算法,减少数据传输与存储成本。压缩后的数据包在Broker端存储,Consumer端自动解压。
- 分区策略:Producer根据Key或自定义规则将事件分配到Topic的不同Partition,实现负载均衡与并行处理。默认策略为按Key哈希,若无Key则轮询。
- 幂等性与事务:支持幂等Producer(通过
enable.idempotence=true),保证同一事件不会被重复写入;事务支持(通过transactional.id)实现跨Topic/Partition的原子操作,满足Exactly Once语义。 - 重试机制:当发送失败时,Producer自动重试(可配置
retries次数),并通过max.in.flight.requests.per.connection控制并发请求数,避免消息乱序。
- 批量发送:Producer将多个事件数据批量打包发送,减少网络请求次数,提升吞吐量。可通过
- Consumer特性:
- 消费组:多个Consumer组成消费组,共同消费一个Topic的所有Partition,每个Partition仅被消费组内一个Consumer处理,实现并行消费。
- 位移管理:Consumer记录已消费事件的位移(Offset),支持自动提交(
enable.auto.commit=true)与手动提交。手动提交可保证消费与处理的原子性。 - 再平衡机制:当消费组内Consumer数量变化(如新增/移除节点)时,Kafka自动重新分配Partition给Consumer,保证负载均衡。可通过
partition.assignment.strategy配置分配策略(如Range、RoundRobin)。 - 批量消费:Consumer一次读取多个事件数据,提升消费效率。可通过
max.poll.records配置批量大小。 - Exactly Once消费:结合事务Producer与位移事务,实现端到端的Exactly Once语义,保证事件仅被处理一次。
2. 分布式消息存储模块(Broker集群)
Broker集群是Kafka的存储核心,负责事件数据的持久化与高可用管理,支持水平扩展与海量数据存储。
- Topic与Partition设计:
- Topic:事件数据的逻辑分类,类似消息队列的队列名。Producer向Topic发送事件,Consumer从Topic读取事件。
- Partition:Topic的物理分片,每个Topic可分为多个Partition。Partition内的事件按时间顺序存储,支持并行读写。Partition数量决定了Topic的最大并行处理能力。
- 分区键(Key):事件的Key用于决定其所属的Partition,相同Key的事件会被分配到同一Partition,保证事件的顺序性。
- 副本机制与数据一致性:
- 副本(Replica):每个Partition可配置多个副本(如3个),其中一个为Leader副本,其余为Follower副本。Leader负责处理读写请求,Follower同步Leader的数据。
- ISR(In-Sync Replicas):与Leader保持同步的Follower副本集合。只有ISR中的副本才能参与Leader选举。当Leader故障时,Kafka从ISR中选举新的Leader,保证数据不丢失。
- 数据写入流程:Producer发送事件到Leader副本,Leader写入本地日志后,同步到ISR中的Follower副本。当所有ISR副本确认写入后,Leader向Producer返回成功响应(可通过
acks配置确认级别:0=无需确认,1=Leader确认,all=ISR确认)。
- 日志存储结构:
- 分段日志(Segment Log):每个Partition的日志分为多个Segment文件(默认大小1GB),便于日志清理与索引。每个Segment包含日志文件(.log)、索引文件(.index)与时间索引文件(.timeindex)。
- 索引文件:索引文件存储事件偏移量与物理文件位置的映射,加速事件的随机读取。时间索引文件存储事件时间戳与偏移量的映射,支持按时间范围查询。
- 日志清理策略:
- 时间保留策略:根据事件的存储时间删除旧日志(可通过
log.retention.hours配置)。 - 大小保留策略:当Partition日志大小超过阈值时删除旧日志(可通过
log.retention.bytes配置)。 - 日志压缩策略:保留每个Key的最新事件,删除旧版本事件(适用于变更数据捕获场景)。可通过
log.cleanup.policy=compact启用。
- 时间保留策略:根据事件的存储时间删除旧日志(可通过
- KRaft模式:
- 替代ZooKeeper:传统Kafka依赖ZooKeeper管理集群元数据(如Topic配置、Partition状态),KRaft模式将元数据管理集成到Kafka内部,简化架构,减少外部依赖。
- Controller节点:KRaft集群包含Controller节点与Broker节点。Controller节点负责管理元数据,选举Leader副本,处理集群配置变更。Controller节点支持高可用(如3个节点),通过Raft协议保证元数据一致性。
- 性能提升:KRaft模式减少了ZooKeeper的通信开销,提升了集群的吞吐量与稳定性,支持更大规模的Topic与Partition数量。
3. Kafka Connect模块
Kafka Connect是Kafka的官方数据集成工具,用于连接外部系统与Kafka集群,实现数据的批量导入/导出,无需编写自定义代码。
- 核心概念:
- Connector(连接器):定义数据集成的方向与规则,分为Source Connector(从外部系统导入数据到Kafka)与Sink Connector(从Kafka导出数据到外部系统)。
- Task(任务):Connector将数据集成任务拆分为多个Task,并行执行,提升效率。Task数量可根据数据量动态调整。
- Worker(工作节点):运行Connector与Task的进程,支持分布式模式(多个Worker节点组成集群,实现高可用与负载均衡)。
- 常用连接器:
- JDBC Connector:支持从关系型数据库(如MySQL、PostgreSQL)导入数据到Kafka(Source),或从Kafka导出数据到数据库(Sink)。
- Elasticsearch Connector:将Kafka事件数据导出到Elasticsearch,用于全文检索与分析。
- HDFS Connector:将Kafka事件数据导出到HDFS,用于离线分析。
- Kafka Connect File Pulse:从文件系统(如本地文件、S3)导入数据到Kafka,支持CSV、JSON等格式。
- CDC Connector:支持变更数据捕获(如Debezium),从数据库(如MySQL、PostgreSQL)实时捕获数据变更,发送到Kafka。
- 特性:
- 分布式模式:多个Worker节点组成集群,自动分配Task,实现高可用与负载均衡。
- 容错机制:Worker节点故障时,其他节点自动接管Task,保证数据集成任务不中断。
- 配置化管理:通过REST API配置Connector与Task,支持动态更新与监控。
- 增量快照:最新版本支持增量快照,减少初始数据导入的时间与资源消耗。
4. Kafka Streams模块
Kafka Streams是Kafka的轻量级流处理框架,嵌入应用内部,无需独立的流处理集群,支持实时事件分析与转换。
- 核心概念:
- 流(Stream):无界的事件序列,按时间顺序生成。Kafka Streams中的流对应Kafka的Topic。
- 表(Table):流的物化视图,存储事件的最新状态。例如,用户的最新余额可通过表来表示。
- KStream/KTable/KGlobalTable:
- KStream:代表无界流,每个事件独立处理。
- KTable:代表表,每个事件对应一个键的更新。
- KGlobalTable:全局表,所有流处理任务共享同一表数据,适用于小数据集(如字典表)。
- 状态存储:Kafka Streams使用本地状态存储(如RocksDB)保存中间结果(如聚合值、连接状态),支持持久化与恢复。
- 流处理操作:
- 过滤(Filter):根据条件筛选事件,保留符合条件的事件。
- 映射(Map):转换事件的键或值,生成新的事件。
- 聚合(Aggregate):对事件进行统计(如求和、计数、平均值),支持窗口聚合。
- 连接(Join):将两个流或表连接起来,生成新的事件。支持内连接、左连接、外连接。
- 窗口(Window):将事件按时间分组,进行窗口内的聚合操作。常见窗口类型:
- 时间窗口(Tumbling Window):固定大小、不重叠的窗口(如每5分钟一个窗口)。
- 滑动窗口(Sliding Window):固定大小、重叠的窗口(如每1分钟滑动一次,窗口大小5分钟)。
- 会话窗口(Session Window):根据事件间隔分组,间隔超过阈值则创建新窗口(如用户会话分析)。
- 特性:
- Exactly Once语义:通过事务支持,保证流处理的精确一次语义,避免事件重复处理或丢失。
- 水平扩展:流处理任务可拆分为多个子任务,运行在多个节点上,实现并行处理。
- 状态恢复:当节点故障时,Kafka Streams自动从Kafka Topic恢复状态存储,保证处理不中断。
- 轻量级:嵌入应用内部,无需独立集群,降低运维成本。
5. 监控与管理模块
监控与管理模块是Kafka稳定运行的保障,提供集群监控、安全控制、配置管理等功能。
- Metrics指标:
- JMX指标:Kafka内置JMX指标,涵盖Producer、Consumer、Broker、Kafka Connect、Kafka Streams等组件的性能与状态(如消息速率、延迟、分区状态、消费滞后量)。
- Prometheus集成:通过Kafka Exporter将JMX指标转换为Prometheus格式,结合Grafana实现可视化监控。
- 关键指标:Broker的
messages-in-per-sec(消息入站速率)、messages-out-per-sec(消息出站速率)、Consumer的consumer-lag(消费滞后量)、Partition的under-replicated-partitions(副本不足的分区)等。
- 安全特性:
- SSL/TLS加密:对Producer、Consumer与Broker之间的通信进行加密,防止数据泄露。
- SASL认证:支持多种认证机制,如PLAIN(用户名/密码)、SCRAM(加盐哈希认证)、Kerberos(企业级认证)。
- ACL权限控制:通过访问控制列表(ACL)限制用户对Topic、Consumer Group的读写权限,保证数据安全。例如,使用
kafka-acls.sh命令为用户分配特定Topic的写权限。
- 集群管理工具:
- 命令行工具:Kafka提供一系列命令行工具,如
kafka-topics.sh(创建/删除/描述Topic)、kafka-consumer-groups.sh(查看/重置消费组位移)、kafka-configs.sh(修改Broker/Topic配置)等。 - KRaft管理工具:在KRaft模式下,使用
kafka-metadata-quorum.sh管理Controller集群状态,kafka-metadata-shell.sh查看元数据信息。 - 第三方UI工具:如Kafka Eagle、AKHQ等,提供可视化的集群管理界面,支持Topic监控、消费组管理、消息查询与日志分析。
- 命令行工具:Kafka提供一系列命令行工具,如
- 多租户支持:
- Topic前缀隔离:为不同租户分配唯一的Topic前缀(如
tenant_001_order),避免资源冲突。 - ACL权限隔离:通过ACL限制租户只能访问自身前缀的Topic与消费组,保证数据隔离。
- 资源配额:配置Broker的资源配额(如CPU、内存、网络带宽),限制租户的资源使用,防止资源滥用。
- Topic前缀隔离:为不同租户分配唯一的Topic前缀(如
三、技术特点与优势
Kafka的核心优势在于其高吞吐、低延迟、高可用的分布式设计,以及丰富的生态系统,使其成为企业构建实时数据平台的首选。
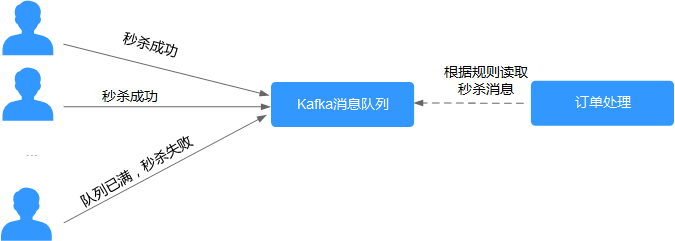
- 高吞吐:通过批量发送、压缩、分区并行处理等机制,Kafka可支持百万级消息/秒的吞吐量,满足海量数据传输需求。例如,大型电商平台可通过Kafka处理峰值时段的订单事件流。
- 低延迟:消息从Producer发送到Consumer的延迟可控制在毫秒级,支持实时数据处理场景。例如,金融机构的实时反欺诈系统需要毫秒级的事件响应。
- 高可用:通过副本机制与Leader选举,Kafka保证集群在节点故障时仍能正常运行,数据不丢失。例如,Broker节点故障时,ISR中的Follower自动升级为Leader,业务无感知。
- 高扩展性:Broker节点支持水平扩展,增加节点即可提升存储与处理能力;Topic的Partition数量可动态调整,适应业务增长。例如,当Topic的消息量增加时,可增加Partition数量提升并行处理能力。
- 持久性:事件数据持久化到磁盘,支持长期存储,可用于离线分析与数据回溯。例如,企业可通过Kafka存储历史事件数据,用于业务审计与趋势分析。
- Exactly Once语义:通过事务支持,实现端到端的精确一次语义,保证数据处理的准确性。例如,金融交易系统需要确保每笔交易仅被处理一次。
- KRaft模式优势:简化架构,减少外部依赖,提升集群性能与稳定性,支持更大规模的部署。例如,KRaft模式可支持上万级别的Topic与Partition数量。
- 生态丰富:与Spark、Flink、Hadoop等大数据工具无缝集成,支持多语言客户端(Java、Python、Go、C++等)。例如,企业可使用Flink结合Kafka实现复杂的流处理任务。
- 事件驱动架构支持:Kafka是事件驱动架构的核心组件,帮助企业实现系统的松耦合与高响应性。例如,微服务架构中,各服务通过Kafka事件实现异步通信。
四、典型应用场景
Kafka的应用场景覆盖实时数据管道、流处理、事件驱动架构等多个领域,以下是常见的应用场景:
- 事件驱动架构(EDA):
在微服务架构中,各个微服务通过Kafka发送与接收事件,实现松耦合的通信。例如,用户服务在用户注册成功后发送
user-registered事件,订单服务监听该事件并创建初始订单,营销服务监听该事件并发送欢迎邮件。Kafka保证事件的可靠传输与顺序性,提升系统的可扩展性与可维护性。 - 实时数据管道:
构建实时数据管道,将数据从源系统(如数据库、日志文件)导入到目标系统(如数据仓库、搜索引擎)。例如,使用Kafka Connect从MySQL导入数据到Kafka,通过Kafka Streams进行数据清洗与转换,再通过Kafka Connect导出到Elasticsearch或Snowflake。实时数据管道支持业务实时分析与决策。
- 流处理与实时分析:
使用Kafka Streams或Flink处理实时事件数据,实现实时监控、报表与告警。例如,电商平台实时分析用户行为事件,计算实时销售额、热门商品排名;金融机构实时分析交易事件,检测欺诈行为并触发告警;物联网平台实时分析传感器数据,监控设备状态并预测故障。
- 日志聚合:
收集分布式系统的日志数据,统一存储与分析。例如,使用Filebeat收集应用服务器的日志,发送到Kafka,再通过Logstash导入到Elasticsearch,最后通过Kibana可视化分析日志。日志聚合帮助运维人员快速定位系统故障,提升运维效率。
- 变更数据捕获(CDC):
实时捕获数据库的变更数据(如插入、更新、删除),发送到Kafka,用于数据同步、缓存更新或实时分析。例如,使用Debezium捕获MySQL的变更数据,发送到Kafka,再同步到Redis缓存或数据仓库,保证数据的一致性与实时性。
- 物联网(IoT)数据处理:
处理物联网设备产生的海量时序数据。例如,智能电表每15分钟发送一次用电数据到Kafka,通过Kafka Streams计算用户的实时用电量与电费,再发送到用户APP显示。Kafka的高吞吐与低延迟特性适合处理物联网数据的实时传输与分析。
- 金融交易处理:
处理金融机构的实时交易数据,支持实时清算、反欺诈与风险控制。例如,银行的交易系统将每笔交易事件发送到Kafka,通过流处理系统实时分析交易模式,检测异常交易并立即冻结账户,保障资金安全。
总结
Apache Kafka作为一款分布式事件流平台,以其高吞吐、低延迟、高可用的特性,成为现代数据基础设施的核心组件。它不仅支持事件的发布/订阅与存储,还提供数据集成(Kafka Connect)与流处理(Kafka Streams)能力,帮助企业构建事件驱动架构、实时数据管道与流分析系统。最新的KRaft模式进一步简化了架构,提升了集群性能与稳定性,使其能够应对更大规模的业务需求。无论是微服务通信、实时数据处理还是物联网数据管理,Kafka都能提供可靠的解决方案,助力企业实现数字化转型与业务创新。
点击链接,了解更多产品详情:
登录后查看
http://kafka.apache.org/" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0);">http://kafka.apache.org/


展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
65.0分项目
评分
同类平均分
综合
65
68
兼容性
74
74
稳定性
74
72
易用性
68
66
性能
62
66
市场占有率
58
66
功能
76
70
扩展性
56
68
美观度
58
64
技术服务
66
66
性价比
54
66
时间排序↓
最新
精华
5 条评论

向我咨询

发表评论