Google Cloud Spanner是一款全球分布式、强一致性的关系型数据库服务,它结合了传统关系型数据库的ACID事务特性与分布式系统的水平扩展性,旨在为全球业务提供高可用、低延迟、可扩展的数据存储解决方案。Spanner无需用户手动管理分片、副本或一致性协议,通过自动化运维降低技术门槛,同时支持标准SQL和丰富的企业级功能,适用于需要全球分布、强一致事务和大规模数据处理的场景。
一、核心定位与整体架构
Spanner的核心定位是“全球分布式关系型数据库”,其设计目标是解决传统关系型数据库在扩展性上的瓶颈,同时克服NoSQL数据库在一致性和事务支持上的不足。它的整体架构基于Google多年的分布式系统研发经验,包含以下关键组件和设计理念:
- 分布式分片与Paxos组:Spanner将数据自动拆分为多个分片(Split),每个分片对应一个Paxos一致性组。每个Paxos组包含3-5个副本,分布在不同的区域或可用区(AZ),确保数据的高可用性和容灾能力。Paxos组的leader副本负责处理读写请求,follower副本同步数据并参与一致性投票。
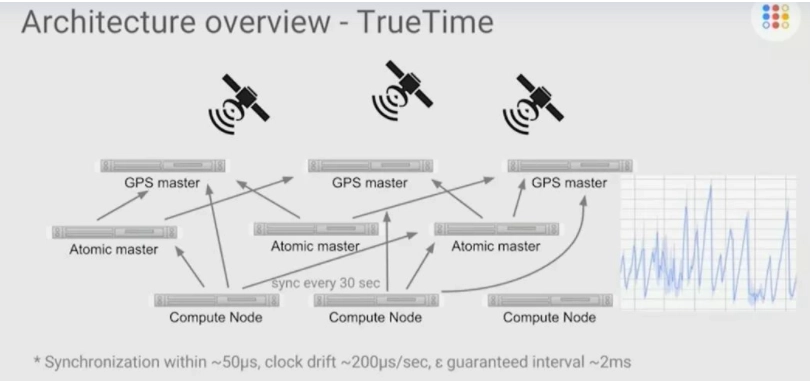
- TrueTime API:这是Spanner实现外部一致性的核心技术。TrueTime基于GPS和原子钟提供高精度的时间服务,返回一个时间区间[earliest, latest],保证真实时间在该区间内。Spanner利用TrueTime确定事务的提交时间,确保分布式事务的顺序与实际发生顺序一致,避免了传统分布式系统中的时钟偏移问题。
- 自动扩缩容与分片管理:Spanner会根据数据量和负载自动调整分片大小,当分片超过阈值时自动拆分,负载降低时合并分片。用户可通过调整节点数量(Spanner Node)实现存储和计算能力的线性扩展,无需停机或手动干预。
- 多区域部署模型:支持单区域、多区域和全球部署三种模式。多区域部署将副本分布在多个地理区域,全球部署则覆盖六大洲的多个区域,确保全球用户的低延迟访问和跨区域灾备。
二、核心功能模块详解
1. 数据模型与SQL支持
Spanner采用传统关系型数据模型,支持表、行、列、主键和索引,同时兼容ANSI SQL 2011标准,降低现有应用的迁移成本。
- 关系型数据模型:支持创建表(CREATE TABLE)、定义列类型(如INT64、STRING、DATE、TIMESTAMP、JSON、GEOGRAPHY等)、主键约束(复合主键允许多个列组合)、外键约束(需注意分布式场景下的性能影响)。
- 标准SQL特性:支持DML操作(INSERT、UPDATE、DELETE)、DDL操作(ALTER TABLE、CREATE INDEX等)、复杂查询(JOIN、子查询、窗口函数、公共表表达式CTE)、JSON数据处理(JSON_VALUE、JSON_QUERY、JSON_ARRAY等函数)、地理空间数据处理(ST_DISTANCE、ST_INTERSECTS等函数)。
- 索引支持:支持二级索引(包括唯一索引、复合索引、局部索引),索引自动同步数据变化,无需手动维护。局部索引适用于分片键相关的查询,可提升查询性能。
2. 全球分布与高可用性
Spanner的全球分布能力是其核心优势之一,确保数据在全球范围内的低延迟访问和高可用性。
- 部署选项:
- 单区域部署:数据副本分布在同一区域的多个可用区,适用于本地业务场景,提供低延迟和高可用性。
- 多区域部署:副本分布在多个相邻区域(如美国东部、美国中部),适用于跨区域灾备需求,确保区域级故障时服务不中断。
- 全球部署:副本分布在全球多个大洲的区域,适用于全球用户访问的业务,如跨境电商、社交网络。
- 副本策略:用户可自定义每个分片的副本数量(3-7个)和分布区域,Spanner自动管理副本的同步和故障转移。默认采用“3副本跨可用区”策略,满足99.999%的SLA要求。
- 自动故障转移:当leader副本或区域发生故障时,Spanner会在秒级内选举新的leader副本,确保服务连续性。用户无需手动干预故障恢复。
3. 事务支持与一致性
Spanner提供完整的ACID事务支持,包括分布式事务,同时通过TrueTime实现外部一致性(即事务的提交顺序与实际发生顺序一致)。
- 事务类型:
- 读写事务:支持更新数据,使用Paxos协议保证一致性,适用于需要修改数据的场景(如订单创建、账户转账)。
- 快照事务:只读事务,使用快照隔离(Snapshot Isolation),无需锁,性能更高。用户可指定时间戳或使用当前时间,支持历史数据查询。
- 只读事务的时间旅行:允许查询过去任意时间点的数据状态(最长保留7天),适用于数据审计、故障恢复或历史数据分析。
- 一致性级别:默认提供强一致性(Strong Consistency),确保所有用户看到相同的数据状态。用户也可选择会话一致性(Session Consistency)或最终一致性(Eventual Consistency)以优化性能,但需权衡一致性需求。
4. 存储与备份恢复
Spanner的存储系统基于Google分布式存储技术,提供持久化、高可靠的数据存储能力。
- 数据持久化:数据以多副本形式存储,每个副本保存在不同的物理设备上,确保数据不丢失。静态数据采用AES-256加密,传输中数据采用TLS 1.2+加密。
- 自动备份:用户可配置自动备份策略(如每日备份),备份数据保存在Google Cloud Storage中,支持跨区域存储。备份过程不影响业务性能。
- 恢复功能:支持从备份恢复到原数据库或新数据库,也可通过时间旅行查询恢复特定时间点的数据。恢复时间取决于数据量,但通常在分钟级完成。
- 数据压缩:自动对数据进行压缩(如字典压缩、前缀压缩),减少存储成本,压缩比可达3-5倍。
5. 安全与合规
Spanner提供企业级安全特性,满足严格的合规要求,适用于金融、医疗等敏感行业。
- IAM权限控制:细粒度的权限管理,支持对数据库实例、数据库、表、行的读写权限控制。用户可通过角色(如Spanner Admin、Spanner Reader)分配权限,确保最小权限原则。
- 审计日志:记录所有访问和操作日志(如查询、修改、备份),日志保存在Cloud Logging中,可用于合规检查和故障排查。
- 合规认证:支持GDPR、HIPAA、PCI DSS、SOC 1/2/3、ISO 27001等多种合规标准,确保数据处理符合行业监管要求。
- 网络安全:支持VPC专用网络(VPC Service Controls),限制数据库访问范围;支持IP白名单,仅允许指定IP地址访问数据库。
6. 运维与监控
Spanner提供自动化运维工具,减少用户的运维负担,同时提供丰富的监控指标和告警功能。
- 自动运维:负责数据库的日常运维,包括补丁更新、硬件维护、分片调整等,用户无需关心底层基础设施。
- 监控指标:通过Cloud Monitoring提供关键指标,如延迟(读写延迟、查询延迟)、吞吐量(QPS、TPS)、错误率(事务失败率、连接错误率)、节点利用率(CPU、内存、存储)等。
- 告警配置:用户可设置告警规则,当指标超过阈值时,通过邮件、短信、Slack等方式通知运维人员。
- 性能优化工具:提供查询分析工具(如Query Plan Explorer),显示查询的执行计划,帮助用户优化慢查询;支持索引建议,自动推荐缺失的索引以提升查询性能。
7. 集成能力
Spanner与Google Cloud生态系统深度集成,同时支持多种客户端SDK和标准协议,方便应用集成。
- GCP服务集成:
- BigQuery:支持直接从Spanner导出数据到BigQuery,实现实时分析;也可通过BigQuery联邦查询直接访问Spanner数据。
- Dataflow:用于数据ETL,支持将Spanner数据同步到其他存储系统(如Cloud Storage、Bigtable)。
- Cloud Functions:通过事件驱动的方式处理Spanner数据变化(如插入、更新事件)。
- Cloud SQL Migration:提供工具从MySQL、PostgreSQL迁移到Spanner,支持schema转换和数据同步。
- 客户端SDK支持:提供Java、Python、Go、Node.js、C#、PHP等多种语言的SDK,方便开发者快速集成。
- 标准协议支持:支持JDBC、ODBC驱动,兼容现有的关系型数据库应用,降低迁移成本。
二、技术特点与优势
- 外部一致性:基于TrueTime API,确保分布式事务的提交顺序与实际发生顺序一致,解决了传统分布式系统中的时钟偏移问题。
- 全球分布与低延迟:数据分布在全球多个区域,用户可就近访问,降低延迟;多区域副本策略确保跨区域灾备。
- 无缝扩展:支持水平扩展,增加节点即可提升存储和计算能力,无需修改应用代码或手动分片。
- ACID事务:结合了关系型数据库的ACID特性和分布式系统的扩展性,适用于需要强一致事务的场景。
- 标准SQL支持:兼容ANSI SQL,降低迁移成本,现有应用可快速适配。
- 高可用性:99.999%的SLA,确保服务几乎不中断;自动故障转移和多副本策略提升容灾能力。
- 自动化运维:减少用户的运维负担,专注于业务逻辑而非数据库管理。
三、典型应用场景
- 全球电商平台:需要全球分布的数据存储,支持多区域用户访问,强一致的订单处理(避免超卖),低延迟的商品查询。Spanner的全球部署和ACID事务可满足这些需求。
- 金融交易系统:需要ACID事务保证交易的准确性,多区域部署确保灾备,合规支持满足金融监管要求。例如,银行的跨境转账系统、证券交易系统。
- 社交网络:用户数据分布在全球,需要低延迟的实时更新和查询,支持复杂的关系型查询(如好友关系、动态流)。Spanner的扩展性和SQL支持可满足这些需求。
- 实时分析与事务混合负载:需要同时处理事务型负载(如用户操作)和分析型负载(如实时报表)。Spanner支持混合负载,无需分离存储系统。
- 多区域灾备系统:企业需要确保数据在区域级灾难发生时不丢失,服务不中断。Spanner的多区域部署和自动故障转移可满足灾备需求。
- 大规模企业应用:如ERP、CRM系统,需要处理大量的关系型数据,支持复杂的查询和事务,Spanner的扩展性和性能可满足这些需求。
四、总结
Google Cloud Spanner是一款面向全球业务的分布式关系型数据库服务,它融合了传统关系型数据库的可靠性和NoSQL的扩展性,通过TrueTime API实现了全球分布下的强一致性事务。Spanner提供了丰富的功能,包括标准SQL支持、全球部署、自动扩缩容、高可用性、安全合规等,适用于各种需要全球分布、强一致、高扩展的应用场景。无论是全球电商、金融交易还是大规模企业应用,Spanner都能帮助企业快速构建稳定、高效的数据库系统,降低运维成本,加速业务创新。
了解更多产品详情,请访问:
登录后查看
https://cloud.google.com/spanner" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0, null, null, null, null, null, 9, null, 0, 0, null, 0, null, 0, null, 0, 0, null, 0);">https://cloud.google.com/spanner