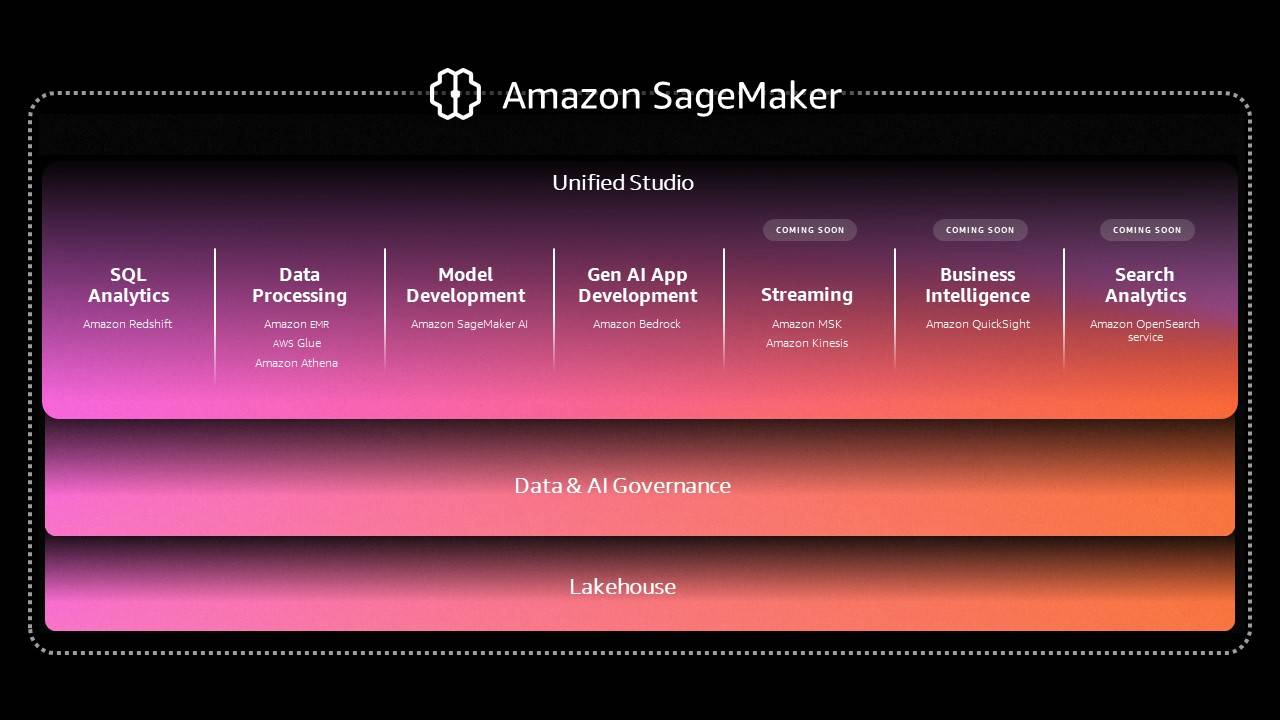
一、 Generative AI 产品系列
1. AWS Bedrock
AWS Bedrock 是亚马逊云科技推出的一项全托管服务,旨在为企业提供简单、安全的方式来构建和扩展生成式 AI 应用程序,无需管理底层基础设施。它通过统一的 API 接口,让用户能够访问来自亚马逊自身及第三方合作伙伴的领先基础模型(Foundation Models, FMs),同时支持模型定制、隐私保护和合规性要求。
核心定位
- 模型接入层:作为生成式 AI 的"应用商店",Bedrock 聚合了多种顶尖 FM,包括亚马逊自研的 Titan 系列模型(如 Titan Text、Titan Image),以及第三方模型如 Anthropic Claude、Meta Llama 2、Stability AI Stable Diffusion 等,用户无需切换平台即可按需选择模型。
- 企业级安全与隐私:所有通过 Bedrock 处理的数据(包括输入提示和输出结果)均不会被用于训练基础模型,确保用户数据的隐私性;同时支持 VPC 私有端点部署,避免数据通过公网传输。
- 低代码/无代码定制:提供两种模型定制方式——基于少量样本的"微调"(Fine-tuning)和基于提示模板的"提示工程"(Prompt Engineering),无需深厚的机器学习背景即可优化模型输出。
关键功能
- 统一模型 API:无论选择哪种基础模型,用户都可以使用相同的 API 结构调用,减少了集成不同模型的开发成本。例如,调用文本生成模型时,输入参数包括"prompt"、"max_tokens"、"temperature"等通用字段,输出格式一致。
- 模型微调与评估:支持上传自定义数据集(如 CSV、JSON 格式)对模型进行微调,Bedrock 会自动处理数据预处理、模型训练和部署流程;同时提供内置的评估工具,可对比不同模型或微调版本的性能(如准确性、相关性、流畅度)。
- 提示管理与版本控制:允许用户创建、保存和版本化提示模板,方便团队协作和迭代优化。例如,客服场景中可保存针对常见问题的最佳提示模板,确保回复的一致性。
- 集成与扩展:无缝集成 AWS 其他服务,如 Amazon S3(存储训练数据和模型输出)、Amazon CloudWatch(监控模型调用 metrics)、AWS Identity and Access Management(IAM)(权限控制)等;同时支持通过 AWS Lambda 触发模型调用,实现自动化工作流。
技术架构
Bedrock 的架构分为三层:
- 模型层:包含亚马逊自研和第三方合作的基础模型,部署在 AWS 高可用集群上,确保模型的稳定性和低延迟。
- 服务层:提供统一 API 网关、模型微调引擎、提示管理系统和安全控制模块。API 网关负责请求路由和负载均衡;微调引擎基于 AWS SageMaker 构建,优化训练效率;安全控制模块包括数据加密、访问审计和隐私保护机制。
- 用户层:通过 Bedrock 控制台(Web UI)或 SDK(如 Python、Java)与服务层交互,用户可在控制台中浏览模型、创建微调任务、管理提示模板等。
典型应用场景
- 智能客服:使用 Anthropic Claude 模型构建多轮对话机器人,处理复杂的客户咨询,如订单查询、故障排除等;通过微调模型加入企业特定的产品知识,提升回复准确性。
- 内容生成:利用 Titan Text 或 Llama 2 生成营销文案、产品描述、新闻摘要等;使用 Stability AI 模型生成产品图片或广告素材。
- 代码辅助:结合 Amazon CodeWhisperer(通过 Bedrock 集成)生成代码片段、注释或调试建议,提高开发效率。
- 数据分析与报告:使用 Titan Text 模型将结构化数据(如 CSV 格式的销售数据)转换为自然语言报告,或回答基于数据的自然语言问题(如"2023年第三季度哪个地区的销售额增长最快?")。
2. Amazon Q
Amazon Q 是 AWS 推出的企业级生成式 AI 助手,专为工作场景设计,可帮助员工提高生产力、获取知识和解决问题。它集成了企业内部数据和 AWS 服务知识,提供个性化的对话式交互体验。
核心定位
- 企业知识助手:连接企业内部文档、知识库、CRM 系统和 AWS 资源,回答员工关于业务流程、产品信息、技术文档的问题。
- AWS 专家助手:针对 AWS 用户,提供实时的服务咨询、故障排查和最佳实践建议,如"如何优化 Lambda 函数的冷启动时间?"或"Amazon S3 的跨区域复制如何配置?"。
- 工作流自动化助手:支持通过自然语言指令触发企业内部工作流,如创建 Jira 工单、发送 Slack 消息或生成会议纪要。
关键功能
- 企业数据连接:支持连接多种企业数据源,包括 Amazon S3(存储文档)、Confluence(知识库)、Salesforce(CRM)、Jira(项目管理)、Microsoft 365(Office 文档)等;通过 AWS Glue 或 Amazon Kendra 进行数据索引和检索,确保回答的准确性和时效性。
- AWS 服务集成:深度集成 AWS 控制台和 CLI,可直接在 Q 中查询 AWS 资源状态(如"我的 EC2 实例有多少个运行中?")、生成 CloudFormation 模板、或执行常见操作(如"重启 my-ecs-cluster 中的所有任务")。
- 对话记忆与上下文理解:能够记住对话历史,理解上下文关联的问题。例如,用户先问"如何创建 S3 存储桶?",接着问"如何设置私有访问权限?",Q 会自动关联前一个问题的上下文,给出针对 S3 存储桶的权限配置步骤。
- 安全与合规:遵循 AWS 安全最佳实践,所有数据传输和存储均加密;支持 IAM 角色和权限策略,控制用户对不同数据源的访问权限;提供对话审计日志,记录所有交互内容,满足合规要求(如 GDPR、HIPAA)。
- 自定义技能:允许企业开发自定义技能(Skills),扩展 Q 的功能。例如,开发一个"报销审批"技能,用户可通过 Q 提交报销申请,Q 自动将申请发送给审批人,并更新申请状态。自定义技能可通过 AWS Lambda 实现,使用 Bedrock 模型处理自然语言请求。
技术架构
Amazon Q 的架构基于以下核心组件:
- 对话引擎:负责处理用户输入,理解意图和上下文,生成回答。对话引擎使用 Bedrock 中的基础模型(如 Titan Text)进行自然语言处理。
- 知识检索器:连接企业数据源和 AWS 服务 API,检索相关信息。对于企业数据,使用 Amazon Kendra 进行语义搜索;对于 AWS 服务,调用 AWS API 获取实时数据。
- 技能平台:提供技能开发框架和运行时环境,支持自定义技能的部署和管理。技能平台集成 AWS Lambda 和 Bedrock,允许开发者快速构建技能。
- 安全层:包含身份认证、权限控制和数据加密模块,确保用户交互的安全性。
典型应用场景
- 员工自助服务:新员工通过 Q 查询公司政策(如考勤制度、福利)、IT 支持(如 VPN 设置、软件安装);市场团队查询竞品分析报告或营销素材。
- AWS 开发与运维:开发人员通过 Q 获取 AWS SDK 使用示例、调试错误信息;运维人员查询 CloudWatch 告警原因,或生成自动化运维脚本。
- 客户支持:客服人员使用 Q 快速检索产品手册和常见问题解答,为客户提供准确的回复;结合自定义技能,自动创建客户工单并分配给相应团队。
- 项目管理:项目经理通过 Q 查询 Jira 项目进度、生成项目周报;团队成员通过 Q 安排会议、发送会议提醒。
二、 Serverless 计算产品系列
1. AWS Lambda SnapStart
AWS Lambda SnapStart 是 Lambda 的一项性能优化功能,旨在减少 Java 函数的冷启动时间。它通过预启动函数实例并创建快照,在后续调用时快速恢复快照,从而将冷启动时间从几秒缩短到毫秒级别。
核心定位
- 冷启动优化:针对 Java 应用(尤其是 Spring Boot、Quarkus 等框架)的冷启动问题,提供无需代码修改的优化方案。
- 成本效益:通过减少冷启动时间,提高函数的响应速度,同时不增加额外的成本(SnapStart 功能免费使用)。
- 兼容性:与现有 Lambda 函数兼容,支持所有 Lambda 运行时配置(如内存大小、超时时间)和集成服务(如 API Gateway、S3)。
关键功能
- 快照预启动:当启用 SnapStart 后,Lambda 会在函数部署时预启动一个或多个函数实例,执行初始化代码(如类加载、依赖注入),然后创建实例的内存和磁盘状态快照。快照存储在 AWS 高可用存储中,确保快速访问。
- 快速恢复:当函数收到新的调用请求时,Lambda 会从快照中快速恢复一个实例(通常在 100-300 毫秒内),而无需重新执行初始化代码。恢复后的实例直接处理请求,显著减少冷启动时间。
- 自动扩展:SnapStart 与 Lambda 的自动扩展机制无缝集成。当请求量增加时,Lambda 会从快照中恢复更多实例,满足需求;当请求量减少时,实例会自动释放,避免资源浪费。
- 安全快照:快照加密存储(使用 AWS KMS 密钥),确保数据安全;恢复实例时,Lambda 会重新生成临时凭证和环境变量,避免敏感信息泄露。
技术原理
SnapStart 的工作流程分为三个阶段:
- 部署阶段:用户上传函数代码并启用 SnapStart。Lambda 构建函数镜像,启动一个实例,执行初始化逻辑(如 static 代码块、Spring Boot 的 @PostConstruct 方法),然后创建实例的快照。快照包含实例的内存状态、文件系统和网络配置。
- 快照存储阶段:快照被压缩并加密,存储在 AWS EBS 快照或类似的块存储服务中。快照的存储位置与函数的 AWS 区域一致,确保低延迟访问。
- 调用阶段:当函数被调用时,Lambda 从快照中恢复一个实例,替换实例的动态信息(如临时凭证、请求 ID),然后将请求转发给实例处理。恢复过程跳过初始化步骤,直接进入处理阶段。
典型应用场景
- Java 微服务 API:使用 Spring Boot 构建的 REST API,部署在 Lambda 上。启用 SnapStart 后,冷启动时间从 5-10 秒缩短到 200-500 毫秒,提升用户体验。
- 批处理任务:定期执行的 Java 批处理任务(如数据清洗、报表生成)。SnapStart 减少任务启动时间,提高批处理效率。
- 事件驱动应用:响应 S3 事件或 API Gateway 请求的 Java 函数。SnapStart 确保函数在首次调用时快速响应,避免请求超时。
2. Amazon EventBridge Pipes
Amazon EventBridge Pipes 是一项无代码/低代码服务,用于连接不同的 AWS 和第三方服务,构建事件驱动的工作流。它简化了事件源、过滤、转换和目标服务的集成过程,无需编写复杂的集成代码。
核心定位
- 事件集成枢纽:连接多种事件源(如 SQS、Kinesis、DynamoDB Streams、API Gateway)和目标服务(如 Lambda、Step Functions、SNS、ECS),实现事件的无缝流转。
- 低代码工作流:通过可视化界面配置事件过滤、转换和路由规则,无需编写代码即可构建复杂的事件驱动工作流。
- 高可用与可扩展:基于 EventBridge 的高可用架构,支持自动扩展,处理高吞吐量的事件流。
关键功能
- 多源支持:支持 15+ 事件源,包括 AWS 服务(如 SQS 队列、Kinesis 数据流、DynamoDB 变更流、S3 事件通知)和第三方服务(如 Shopify、Zendesk、Salesforce 等,通过 EventBridge Partners 集成)。
- 事件过滤:使用 JSON Path 表达式过滤事件,只将符合条件的事件发送到目标服务。例如,过滤 S3 事件中"对象键以 .pdf 结尾"的事件。
- 事件转换:支持使用 AWS AppSync 模板或 JSONata 表达式转换事件格式。例如,将 SQS 消息中的 JSON 数据转换为 Lambda 函数所需的输入格式。
- 目标路由:将过滤和转换后的事件发送到一个或多个目标服务。支持 20+ 目标服务,包括 Lambda、Step Functions、SNS 主题、ECS 任务、Kinesis Firehose 等。
- 错误处理:提供重试机制(支持指数退避)和死信队列(DLQ)配置。当事件处理失败时,可将事件发送到 DLQ 进行后续处理,避免数据丢失。
- 监控与日志:集成 Amazon CloudWatch,监控管道的事件吞吐量、成功率、延迟等指标;支持将日志发送到 CloudWatch Logs,方便故障排查。
技术架构
EventBridge Pipes 的架构由四个核心组件组成:
- 源连接器:负责从事件源读取事件。每个源连接器针对特定的服务(如 SQS 连接器、Kinesis 连接器),处理连接、身份验证和事件读取逻辑。
- 过滤器:对源事件进行过滤,只保留符合条件的事件。过滤器使用 JSON Path 表达式,支持多种比较运算符(如等于、包含、大于)。
- 转换器:将事件转换为目标服务所需的格式。转换器支持两种模式:1)传递模式(直接发送原始事件);2)转换模式(使用模板或表达式修改事件)。
- 目标连接器:将转换后的事件发送到目标服务。每个目标连接器处理目标服务的连接、身份验证和事件写入逻辑。
典型应用场景
- 订单处理工作流:当 Shopify 生成新订单事件时,EventBridge Pipes 过滤"已支付"的订单,转换事件格式,然后发送到 Lambda 函数处理订单(如更新库存、发送确认邮件)。
- 数据管道:将 S3 中的 CSV 文件事件转换为 JSON 格式,发送到 Kinesis Firehose,再加载到 Amazon Redshift 进行分析。
- 微服务集成:将 DynamoDB 表的变更事件(如新增用户)发送到 Step Functions 工作流,执行用户注册流程(如发送验证码、创建账户)。
- 监控告警:将 CloudWatch 告警事件过滤为"严重级别"的告警,发送到 SNS 主题,通知运维团队。
三、 Data Analytics 产品系列
1. Amazon OpenSearch Service Serverless
Amazon OpenSearch Service Serverless 是一项全托管的无服务器搜索和分析服务,基于开源 OpenSearch 引擎构建。它自动处理集群管理、扩展和维护,让用户专注于数据搜索和分析,无需关心底层基础设施。
核心定位
- 无服务器搜索:提供按需扩展的搜索能力,自动根据查询量和数据量调整资源,无需预配置集群大小。
- 实时分析:支持对结构化和非结构化数据的实时搜索和分析,适用于日志分析、应用监控、用户行为分析等场景。
- 低成本:按实际使用的计算和存储资源付费,无需为闲置资源付费。对于间歇性或不可预测的工作负载,成本优势明显。
关键功能
- 自动扩展:根据搜索查询量和数据写入量自动调整计算资源(以"计算单元"为单位)。计算单元分为两种:1)搜索单元(处理查询请求);2)索引单元(处理数据写入请求)。用户可设置最小和最大计算单元,控制成本和性能。
- 数据存储:自动管理数据存储,支持冷热数据分层。热数据存储在高性能 SSD 中,确保低延迟查询;冷数据自动迁移到低成本存储(如 S3),降低存储成本。用户可设置数据保留策略,自动删除过期数据。
- 安全与合规:支持 VPC 私有访问、IAM 权限控制、数据加密(静态和传输中)、细粒度访问控制(基于角色的访问控制 RBAC)。符合 GDPR、HIPAA、PCI DSS 等合规标准。
- 集成能力:无缝集成 AWS 服务,如 Amazon Kinesis Firehose(数据摄入)、Amazon S3(数据存储)、Amazon Lambda(触发搜索结果处理)、Amazon CloudWatch(监控)等。同时支持开源 OpenSearch API,兼容现有 OpenSearch 客户端和工具。
- 实时搜索与分析:支持全文搜索、地理空间搜索、聚合分析等功能。例如,使用 Kibana 仪表板实时监控应用日志,分析用户访问模式。
技术架构
OpenSearch Service Serverless 的架构分为三层:
- 控制平面:负责集群管理、资源调度和配置。控制平面自动监控工作负载,调整计算和存储资源;同时提供 API 和控制台,让用户管理索引、访问权限和策略。
- 数据平面:处理数据写入和查询请求。数据平面由多个计算单元组成,每个计算单元包含多个 OpenSearch 节点。计算单元动态扩展,确保性能和可用性。
- 存储平面:存储索引数据。存储平面使用 AWS S3 作为底层存储,支持数据冗余和高可用性。热数据缓存于计算单元的内存和 SSD 中,冷数据存储于 S3。
典型应用场景
- 日志分析:收集应用程序日志(如 Apache、Nginx、Lambda 日志),通过 Kinesis Firehose 写入 OpenSearch Service Serverless,使用 Kibana 分析日志,排查故障。
- 应用监控:实时监控应用性能指标(如响应时间、错误率),使用 OpenSearch 的聚合功能生成监控仪表板,及时发现问题。
- 用户行为分析:收集用户访问网站或应用的行为数据(如点击、浏览、购买),使用 OpenSearch 分析用户行为模式,优化产品体验。
- 电子商务搜索:为电子商务网站提供产品搜索功能,支持全文搜索、过滤(如价格范围、品牌)、排序(如销量、评分)等功能。
2. AWS Glue DataBrew
AWS Glue DataBrew 是一项可视化数据准备服务,旨在帮助数据分析师和业务用户快速清洗、转换和标准化数据,无需编写代码。它提供超过 250 种预构建的数据转换功能,支持多种数据源。
核心定位
- 低代码数据准备:通过可视化界面完成数据清洗和转换,减少数据准备时间(通常占数据分析工作的 60-80%)。
- 自助服务:让业务用户和分析师无需依赖数据工程师即可处理数据,提高工作效率。
- 集成与自动化:无缝集成 AWS 数据服务,支持将数据准备任务自动化,定期执行。
关键功能
- 可视化数据准备:提供拖拽式界面,用户可通过选择预构建的转换功能(如删除重复项、填充缺失值、转换数据类型、拆分列)处理数据。实时预览转换结果,确保正确性。
- 多源支持:支持多种数据源,包括 AWS 服务(如 S3、Redshift、Athena、Glue Data Catalog)和第三方服务(如 Snowflake、Salesforce、MySQL 等)。用户可直接连接数据源,无需数据迁移。
- 预构建转换:提供超过 250 种预构建转换,覆盖常见的数据清洗和转换场景。例如,"去除空格"、"日期格式转换"、"分类编码"、"异常值检测"等。
- 数据质量规则:允许用户定义数据质量规则(如"列值不能为空"、"数值范围在 0-100 之间"),自动检测数据质量问题。支持生成数据质量报告,显示不符合规则的记录数量和比例。
- 自动化任务:将数据准备任务保存为作业,支持定期执行(如每天、每周)或触发执行(如 S3 数据更新时)。作业执行结果可保存到 S3、Redshift 或其他目标服务。
- 集成能力:无缝集成 AWS Glue ETL、Amazon SageMaker、Amazon QuickSight 等服务。例如,使用 DataBrew 处理数据后,直接导入 SageMaker 进行模型训练;或导入 QuickSight 进行可视化分析。
典型应用场景
- 数据分析准备:业务分析师需要分析销售数据,使用 DataBrew 清洗数据(如删除重复订单、填充缺失的客户信息、转换日期格式),然后导入 QuickSight 生成销售报表。
- 机器学习数据准备:数据科学家需要准备训练数据,使用 DataBrew 处理原始数据(如编码分类变量、标准化数值变量、拆分训练集和测试集),然后导入 SageMaker 训练模型。
- 数据湖清洗:数据工程师需要清洗 S3 数据湖中的原始数据,使用 DataBrew 定义清洗规则,定期执行作业,将清洗后的数据保存到数据湖的干净区域。
- 合规数据处理:金融机构需要处理客户数据,确保符合 GDPR 要求。使用 DataBrew 脱敏敏感数据(如隐藏信用卡号的中间数字),然后导出到合规系统。
四、 Security & Compliance 产品系列
1. AWS Clean Rooms
AWS Clean Rooms 是一项全托管服务,允许企业与合作伙伴安全地共享和分析数据,而无需暴露原始数据。它通过隐私保护技术(如差分隐私、数据屏蔽、查询限制)确保数据安全,同时支持联合分析。
核心定位
- 安全数据共享:在不暴露原始数据的前提下,与合作伙伴共享数据进行联合分析。例如,广告主和媒体平台共享用户数据,分析广告效果,而不泄露用户隐私。
- 隐私合规:遵循数据隐私法规(如 GDPR、CCPA),确保数据共享过程符合合规要求。支持细粒度的访问控制和审计日志。
- 易用性:通过可视化界面创建和管理 Clean Rooms,无需编写复杂的隐私保护代码。
关键功能
- 数据接入:支持从 AWS S3、Amazon Redshift、Amazon Athena 等数据源接入数据。用户可选择要共享的数据表或列,设置访问权限。
- 隐私保护技术:
- 差分隐私:在查询结果中添加噪声,保护个体数据隐私,同时保持统计准确性。
- 数据屏蔽:隐藏或替换敏感数据(如姓名、邮箱),只显示非敏感部分。
- 查询限制:限制查询结果的行数、聚合粒度(如只能查询分组统计结果,不能查询单个记录)。
- 输出控制:控制查询结果的输出格式和内容,防止敏感信息泄露。
- 联合分析:支持多个参与方共同分析数据。例如,广告主和媒体平台在 Clean Rooms 中联合分析广告点击数据和用户购买数据,计算广告 ROI。
- 审计与监控:提供详细的审计日志,记录所有数据访问和查询操作。支持集成 Amazon CloudWatch,监控 Clean Rooms 的活动和性能。
- 集成能力:无缝集成 AWS 服务,如 Amazon Redshift(数据存储)、Amazon Athena(查询)、AWS IAM(权限控制)等。同时支持第三方工具,如 Tableau、Power BI,通过 ODBC/JDBC 连接 Clean Rooms 进行分析。
典型应用场景
- 广告效果分析:广告主与媒体平台共享数据,分析广告点击与用户购买行为的关联,计算广告转化率。使用差分隐私和查询限制,保护用户隐私。
- 零售联合分析:零售商与供应商共享销售数据和库存数据,联合分析产品销售趋势,优化库存管理。
- 医疗研究:医疗机构与研究机构共享匿名化的患者数据,联合研究疾病模式和治疗效果,符合 HIPAA 要求。
- 金融风险评估:银行与信用机构共享客户数据,联合评估信用风险,同时保护客户隐私。
总结
以上介绍的 AWS 最新软件产品覆盖了生成式 AI、Serverless 计算、数据 analytics、安全合规等多个核心领域,旨在帮助企业简化技术复杂度、提升运营效率、降低成本并确保数据安全。这些产品均采用全托管模式,自动处理基础设施管理、扩展和维护,让企业团队能够专注于业务创新和价值创造。无论是构建智能客服系统、处理事件驱动工作流、分析海量数据,还是安全共享数据资产,AWS 都提供了端到端的产品支持和灵活的集成能力。
了解更多 AWS 产品详情,请访问 AWS 官方网站:
登录后查看
https://aws.amazon.com/cn/big-data/" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0, null, null, null, null, null, 9, null, 0, 0, null, 0, null, 0, null, 0, 0, null, 0);">https://aws.amazon.com/cn/big-data/