








influxdb是一个开源分布式时序、时间和指标数据库,使用 Go 语言编写,无需外部依赖。其设计目标是实现分布式和水平伸缩扩展,是 InfluxData 的核心产品。应用:性能监控,应用程序指标,物联网传感器数据和实时分析等的后端存储。
InfluxDB
0.00条评价830次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
InfluxDB 3.0是InfluxData公司推出的新一代高性能时序数据库产品,专为处理海量时间戳数据设计,能够高效支撑实时数据写入、低延迟查询、复杂时序分析等场景。其核心目标是解决传统数据库在时序数据处理中面临的高写入压力、低查询效率、难以扩展等痛点,为物联网(IoT)、IT基础设施监控、应用性能监控(APM)、工业互联网(IIoT)等领域提供稳定、高效的数据存储与分析能力。InfluxDB 3.0并非单一工具,而是融合了数据写入、存储、查询、分析、集成与管理的全链路时序数据平台,其架构设计围绕时序数据的特性进行深度优化,兼顾性能、扩展性与易用性。
一、核心定位与整体架构
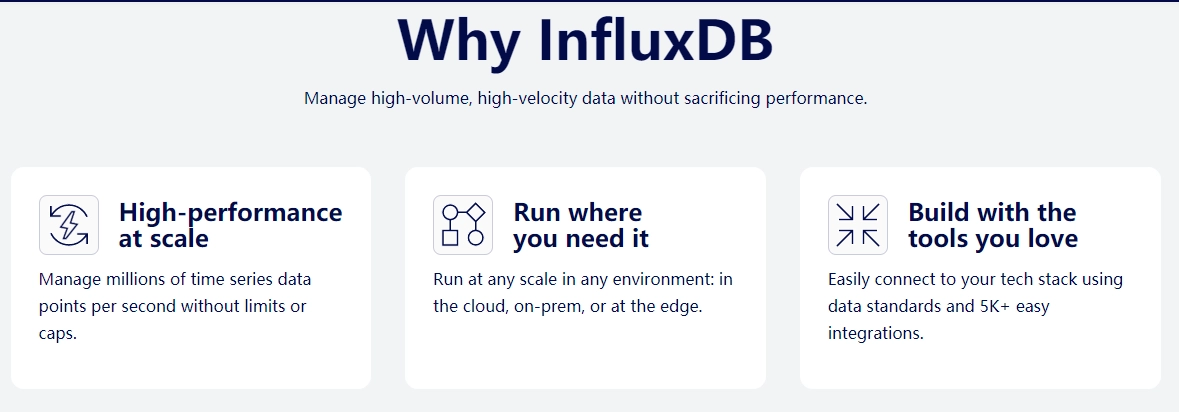
InfluxDB 3.0的核心理念是“时序优先”与“云原生”。与通用数据库不同,它针对时序数据的时间有序性、高写入速率、查询多为时间范围过滤等特性进行了专项优化,同时采用云原生架构支持弹性扩展与按需使用。
- 时序优先:从数据模型到存储引擎、查询引擎,均以时序数据为核心设计目标。支持基于时间的分区、索引与聚合操作,能够高效处理百万级每秒写入与亚秒级查询延迟。
- 云原生:采用微服务架构,支持Kubernetes部署与管理,提供Serverless、Dedicated等多种云服务形态,用户可根据业务需求灵活选择部署方式,无需关注底层基础设施维护。
平台的逻辑架构分为以下五层:
- 数据写入层(Ingestion Layer):负责接收来自各类数据源的时序数据,支持多种协议与工具,提供高吞吐量、低延迟的写入能力,并支持数据预处理与转换。
- 存储引擎层(Storage Engine Layer):基于列式存储与分层存储设计,实现高效数据压缩、冷热数据分离与自动生命周期管理,平衡性能与成本。
- 查询引擎层(Query Engine Layer):支持SQL、InfluxQL、Flux等多种查询语言,采用向量化执行与并行计算技术,提供低延迟的复杂时序分析能力。
- 集成与服务层(Integration & Service Layer):提供丰富的生态连接器、SDK与API,支持与可视化工具、流处理平台、大数据框架等集成,方便数据消费与应用开发。
- 管理与可观测性层(Management & Observability Layer):负责集群管理、监控告警、安全控制、备份恢复等运维功能,确保平台稳定运行与数据安全。
二、核心功能模块详解
1. 数据写入模块
数据写入是时序数据库的“入口”,InfluxDB 3.0提供了灵活、高效的写入能力,支持多种数据源与场景。
- 多协议与工具支持:
- Telegraf:官方数据采集代理,提供超过300种插件,支持从服务器、网络设备、数据库、IoT设备等各类数据源采集数据,并直接写入InfluxDB。例如,通过CPU插件采集服务器CPU使用率,通过MQTT插件接收IoT设备消息,通过MySQL插件采集数据库性能指标。
- InfluxDB Line Protocol(ILP):轻量级、高效的时序数据传输协议,格式简洁(如“sensor_data,device_id=dev001 location=room1 temperature=25.5,humidity=45.2 1718000000000”),支持高吞吐量写入。ILP采用文本格式,易于调试,同时支持二进制编码以进一步提升传输效率。
- MQTT:直接集成MQTT协议,可接收来自MQTT broker(如Mosquitto、EMQX)的IoT设备数据,无需额外转换。支持QoS 0/1/2级别,确保数据传输的可靠性。
- Kafka:支持从Kafka主题读取数据,适用于高并发、分布式的数据写入场景,例如日志数据的批量导入或流数据的实时处理。用户可配置Kafka消费者组,实现数据的分布式消费与写入。
- REST API:通过HTTP/HTTPS接口写入数据,支持JSON与ILP格式,方便应用程序直接集成。例如,Web应用可通过REST API将用户行为数据写入InfluxDB。
- 高吞吐量与低延迟:采用异步写入、批量处理与分布式架构,单节点可支持百万级每秒写入(points per second,PPS),写入延迟控制在毫秒级。例如,对于100万IoT设备,每10秒发送一次数据,InfluxDB 3.0单节点即可轻松支撑(100万/10=10万PPS)。在分布式集群中,写入能力可随节点数量线性扩展,满足超大规模数据写入需求。
- 数据预处理与转换:
- 过滤与清洗:支持在写入前过滤无效数据(如温度值超出-20~100°C范围的数据),清洗脏数据(如缺失device_id标签的数据),避免无效数据占用存储资源。
- 标签与字段转换:可动态添加、修改或删除数据的标签(tag)与字段(field)。例如,将设备ID从字符串“dev001”转换为整数1,或添加地理位置标签“region=asia”。标签用于高基数过滤,字段用于数值型数据存储,合理的转换可提升查询效率。
- 降采样:对于高频数据,可在写入时进行降采样处理(如将1秒分辨率数据聚合为5秒平均值),减少存储占用与查询压力。例如,工业设备每秒发送一次振动数据,通过降采样可将数据量减少80%,同时保留关键趋势信息。
- 去重:支持基于时间戳、标签的自动去重,避免重复数据写入。例如,同一设备在同一时间戳发送的重复数据会被自动过滤,确保数据的唯一性。
- 可靠性保障:
- 数据持久化:写入数据先写入内存缓冲区,再异步刷盘至持久化存储(如SSD),确保数据不丢失。同时,支持 WAL(Write-Ahead Log)机制,在系统崩溃时可通过WAL恢复未刷盘的数据。
- 重试机制:对于写入失败的请求,支持自动重试(可配置重试次数与间隔),保证数据完整性。例如,网络波动导致写入失败时,客户端会自动重试直至成功或达到最大重试次数。
- 集群复制:在分布式集群中,数据会复制到多个节点(可配置复制因子,如3),避免单点故障导致数据丢失。当某个节点故障时,其他节点可继续提供服务,确保系统高可用。
2. 存储引擎模块
存储引擎是InfluxDB 3.0的核心,负责时序数据的高效存储与管理,平衡性能、成本与扩展性。
- 列式存储设计:采用列式存储格式(基于Apache Parquet优化),与时序数据的查询特性高度匹配。时序查询通常只访问少数字段(如温度、湿度),列式存储可只读取所需字段,减少I/O开销。例如,查询某设备过去24小时的温度数据时,列式存储只需读取温度字段列,而无需读取其他无关字段(如湿度、压力)。
- 高效数据压缩:集成多种压缩算法(如Snappy、Zstandard、LZ4),并根据数据类型自适应选择最优算法。例如,时间戳字段采用差值编码+Zstandard压缩,可达到100:1的压缩比;数值型字段采用行程编码(RLE)+Snappy压缩,压缩比可达50:1。高效的压缩不仅减少存储占用,还提升查询速度(因为需要读取的数据量更少)。
- 分层存储(Tiered Storage):支持热、温、冷三层存储,自动管理数据生命周期,平衡性能与成本:
- 热存储:采用SSD存储最近的数据(如过去7天),提供最快的读写性能,适用于实时监控与高频查询场景。
- 温存储:采用HDD存储较旧但仍需频繁访问的数据(如过去7天至30天),性能适中,成本低于SSD。
- 冷存储:采用对象存储(如AWS S3、阿里云OSS)存储归档数据(如30天以上),成本极低,适用于偶尔查询或合规要求的场景。
- 时间分区与索引:
- 时间分区:数据按时间分区(如每小时、每天)存储,查询时只需扫描相关时间分区,减少查询范围。例如,查询过去1小时的数据时,只需访问最近1个小时的分区,而无需扫描整个数据集。
- 标签索引:对标签字段(如device_id、location)建立倒排索引,支持高基数过滤。例如,查询“location=room1的所有设备数据”时,标签索引可快速定位到相关数据分区,提升查询效率。
- 字段统计信息:存储字段的统计信息(如最小值、最大值、平均值),对于聚合查询(如求平均温度)可直接使用统计信息,无需扫描所有数据,进一步提升查询速度。
- 数据生命周期管理:支持自动删除过期数据,根据retention policy设置的数据保留期限,自动删除超过期限的数据。例如,设置数据保留30天,则30天后的数据会被自动删除,释放存储资源。
3. 查询引擎模块
查询引擎是InfluxDB 3.0的“大脑”,负责处理用户的查询请求,提供低延迟、高并发的时序分析能力。
- 多查询语言支持:
- SQL兼容性:InfluxDB 3.0全面支持SQL查询,兼容ANSI SQL标准,降低用户学习门槛。数据分析师可使用熟悉的SQL语句进行时序分析,例如:
SELECT mean(temperature) AS avg_temp, max(humidity) AS max_hum FROM sensor_data WHERE time >= NOW() - INTERVAL '1 day' GROUP BY device_id, time(1 hour)
该查询计算过去24小时内每个设备每小时的平均温度与最大湿度。 - InfluxQL:保留对InfluxQL的支持,方便现有InfluxDB 1.x/2.x用户迁移。例如:
SELECT mean(temperature) FROM sensor_data WHERE time > now() - 1d GROUP BY device_id, time(1h) - Flux:支持Flux查询语言,适用于复杂时序分析场景(如跨测量集连接、自定义函数、多数据源联合查询)。例如,Flux可实现不同设备数据的对比分析,或与外部数据源(如CSV文件)的集成。
- SQL兼容性:InfluxDB 3.0全面支持SQL查询,兼容ANSI SQL标准,降低用户学习门槛。数据分析师可使用熟悉的SQL语句进行时序分析,例如:
- 高性能查询优化:
- 向量化执行:采用向量化执行引擎(基于Apache DataFusion),将数据作为向量批量处理,而非单条记录处理,提升CPU利用率与查询速度。例如,计算100万条记录的平均值时,向量化执行可将处理时间从秒级缩短到毫秒级。
- 并行查询:在分布式集群中,查询会被拆分为多个子查询,并行执行于不同节点,最后合并结果。例如,查询过去1个月的数据时,查询会被拆分为30个每日子查询,并行处理后汇总结果,大幅提升查询效率。
- 查询缓存:对频繁执行的查询结果进行缓存,下次查询时直接返回缓存结果,减少重复计算。例如,每小时执行一次的报表查询,缓存结果可直接用于后续请求,提升响应速度。
- 谓词下推:将查询中的过滤条件(如time范围、标签过滤)下推到存储层,减少数据读取量。例如,查询“device_id=dev001且time>now()-1h”的数据时,谓词下推会让存储层只返回符合条件的数据,而非整个数据集。
- 时序分析函数:提供丰富的时序分析函数,满足各类业务需求:
- 聚合函数:mean(平均值)、sum(总和)、min(最小值)、max(最大值)、count(计数)等,支持按时间窗口(如1h、5m)聚合。
- 窗口函数:time()函数用于按时间窗口分组,如time(10m)表示每10分钟为一个窗口。
- 趋势分析:holt_winters(指数平滑)、derivative(导数,计算变化率)、difference(差值)等,用于分析数据趋势。
- 异常检测:stddev(标准差)、zscore(Z值)等,用于检测异常数据点。
- 地理空间函数:支持地理坐标数据的查询与分析,如计算两点之间的距离、查找特定区域内的设备。
- 实时查询支持:支持亚秒级实时查询,适用于实时监控场景。例如,查询某设备当前的温度值,响应时间可控制在100毫秒以内。
4. 实时分析与告警模块
实时分析与告警是InfluxDB 3.0的重要功能,帮助用户及时发现数据异常与业务问题。
- 连续查询(Continuous Queries,CQs):定义持续运行的查询,将结果存储到新的测量集,用于实时聚合与降采样。例如,设置连续查询每5分钟计算一次所有设备的平均温度,并存储到“sensor_avg”测量集,方便后续快速查询。
- 告警规则:支持基于阈值、异常、趋势的告警规则:
- 阈值告警:当数据超过预设阈值时触发告警,例如“温度>90°C持续5分钟”。
- 异常告警:基于统计方法(如标准差、Z值)检测异常数据,例如“温度值偏离平均值3个标准差”。
- 趋势告警:基于数据趋势变化触发告警,例如“温度每小时上升超过5°C”。
- 告警通知:支持多种通知方式,包括:
- 邮件通知
- 短信通知(通过第三方服务如Twilio)
- 即时通讯工具(如Slack、钉钉、企业微信)
- 监控系统集成(如PagerDuty、Prometheus Alertmanager)
- 实时仪表盘:集成可视化工具(如Grafana、InfluxDB UI),支持实时更新的仪表盘。用户可创建自定义仪表盘,展示关键指标(如设备数量、平均温度、告警数量),并设置自动刷新(如每5秒刷新一次)。
5. 集成与生态模块
InfluxDB 3.0提供丰富的集成能力,与主流工具与框架无缝对接,构建完整的时序数据生态。
- 可视化工具集成:
- Grafana:官方支持Grafana插件,用户可直接在Grafana中连接InfluxDB 3.0,创建自定义仪表盘。Grafana提供丰富的图表类型(如折线图、柱状图、热力图),适用于监控与分析场景。
- InfluxDB UI:内置Web UI,支持数据探索、查询编辑、仪表盘创建与告警管理。用户无需安装额外工具,即可完成基本的数据分析与运维操作。
- Tableau/Power BI:通过SQL接口集成Tableau与Power BI,支持时序数据的可视化与报表生成,适用于业务分析场景。
- 流处理平台集成:
- Apache Flink:通过SQL或Flink Connector连接InfluxDB 3.0,实现实时流处理。例如,Flink可读取Kafka中的流数据,进行实时转换后写入InfluxDB 3.0。
- Apache Spark:通过Spark Connector连接InfluxDB 3.0,实现批量数据处理与分析。例如,Spark可读取InfluxDB中的历史数据,进行机器学习模型训练。
- SDK与API:提供多种编程语言的SDK,方便应用程序集成:
- Python SDK:支持数据写入、查询与管理,集成pandas库,方便数据分析。
- Java SDK:适用于企业级应用开发,支持高并发写入与查询。
- Go SDK:轻量级SDK,适用于高性能应用场景。
- JavaScript SDK:适用于Web应用与Node.js服务。
- REST API:提供完整的API接口,支持所有功能操作,方便第三方工具集成。
- IoT平台集成:支持与主流IoT平台(如AWS IoT、Azure IoT、Google Cloud IoT)集成,接收IoT设备数据并写入InfluxDB 3.0。例如,AWS IoT Core可将设备数据转发到InfluxDB 3.0,实现实时监控与分析。
6. 管理与可观测性模块
管理与可观测性模块确保InfluxDB 3.0的稳定运行与数据安全,降低运维成本。
- 集群管理:
- 弹性扩展:支持横向扩展(添加节点)与纵向扩展(升级节点配置),写入与查询能力随节点数量线性增长。例如,从3节点扩展到6节点,写入能力可提升一倍。
- 节点管理:支持节点的添加、删除与替换,无需停机。当节点故障时,系统会自动将数据迁移到其他节点,确保服务连续性。
- 负载均衡:自动平衡集群节点的负载,避免单点过载。例如,写入请求会均匀分布到所有数据节点,查询请求会根据数据分布路由到相关节点。
- 监控与告警:
- 自身监控:InfluxDB 3.0会监控自身的运行状态,包括CPU使用率、内存占用、磁盘空间、写入速率、查询延迟等指标,并将这些指标存储到内部测量集。
- 告警规则:支持对自身指标设置告警规则,例如“磁盘空间使用率>80%”或“查询延迟>500ms”,确保及时发现系统异常。
- 日志管理:提供详细的日志记录,包括写入日志、查询日志、集群日志等,方便故障排查。日志可导出到外部系统(如Elasticsearch、Splunk)进行集中管理。
- 安全控制:
- 身份认证:支持多种认证方式,包括用户名/密码、API令牌、OAuth2.0、LDAP/Active Directory集成,确保只有授权用户可访问系统。
- 权限管理:基于RBAC(Role-Based Access Control)的权限模型,支持角色创建与权限分配。例如,创建“只读用户”角色,授予查询权限但禁止写入与管理操作。
- 数据加密:支持数据传输加密(TLS 1.2/1.3)与数据静态加密(AES-256),确保数据在传输与存储过程中的安全性。
- 审计日志:记录所有用户操作(如登录、写入、查询、管理),用于合规审计与安全追溯。
- 备份与恢复:
- 自动备份:支持定时自动备份,可配置备份频率(如每日)与备份保留期限(如7天)。备份数据可存储到本地或对象存储。
- 手动备份:支持手动触发备份,适用于重要操作前的备份需求。
- 恢复功能:支持从备份数据恢复系统,可选择恢复到指定时间点,确保数据可恢复性。
三、技术特点与优势
InfluxDB 3.0的技术特点与优势使其在时序数据库领域脱颖而出:
- 极致性能:单节点百万级每秒写入,亚秒级查询延迟,满足超大规模时序数据处理需求。
- 弹性扩展:分布式架构支持线性扩展,节点数量可根据业务需求灵活调整,无需停机。
- 成本优化:分层存储与高效压缩大幅降低存储成本,云原生Serverless形态按需付费,进一步降低运维成本。
- 易用性高:全面支持SQL查询,降低学习门槛;丰富的生态集成与可视化工具,简化数据处理与分析流程。
- 高可靠性:数据多副本存储,自动故障转移,确保系统7×24小时稳定运行;备份与恢复功能保障数据安全。
- 开放生态:支持多种协议、工具与框架集成,避免厂商锁定,方便用户构建自定义解决方案。
四、典型应用场景
InfluxDB 3.0适用于各类时序数据场景,以下是几个典型案例:
- IoT设备监控:
某智能家电公司拥有100万+智能 thermostat 设备,每10秒发送一次温度、湿度与能耗数据。使用InfluxDB 3.0存储这些数据,通过Telegraf采集设备数据,Grafana创建实时仪表盘监控设备状态,设置告警规则当温度超过阈值时通知用户。InfluxDB 3.0的高写入性能支撑了10万PPS的写入需求,分层存储降低了长期数据的存储成本,SQL查询方便数据分析师进行用户行为分析。
- IT基础设施监控:
某互联网公司监控500+服务器、200+网络设备与100+应用服务,使用Telegraf采集CPU、内存、磁盘、网络流量等指标,写入InfluxDB 3.0。通过Grafana创建基础设施仪表盘,实时监控系统状态;设置告警规则当服务器CPU使用率>90%或应用响应时间>2秒时通知运维团队。InfluxDB 3.0的低延迟查询确保运维团队能及时获取系统状态,并行查询能力支持快速分析历史数据以定位问题。
- 工业互联网(IIoT):
某汽车制造企业监控100+生产设备,每1秒发送一次振动、温度、压力等数据。使用InfluxDB 3.0存储这些数据,通过连续查询计算设备的健康指标,设置异常告警当振动值偏离正常范围时通知维护团队。InfluxDB 3.0的实时分析能力帮助企业实现预测性维护,减少设备 downtime 30%以上;高效压缩降低了存储成本,分层存储确保历史数据可随时查询。
- 应用性能监控(APM):
某电商平台监控核心应用的请求延迟、错误率、吞吐量等指标,使用APM工具(如New Relic)采集数据并写入InfluxDB 3.0。通过Grafana创建APM仪表盘,实时监控应用性能;设置告警规则当错误率>1%或请求延迟>500ms时通知开发团队。InfluxDB 3.0的高并发查询能力支持开发团队快速分析性能瓶颈,SQL查询方便与业务数据结合进行根因分析。
- 金融市场数据分析:
某金融机构采集股票、期货等市场数据,每1毫秒发送一次价格与成交量数据。使用InfluxDB 3.0存储这些高频数据,通过SQL查询计算移动平均线、成交量指标等,支持交易策略开发。InfluxDB 3.0的低延迟查询确保交易策略能及时响应市场变化,列式存储与压缩能力支撑了PB级市场数据的存储需求。
总结而言,InfluxDB 3.0作为新一代时序数据库产品,通过时序优先的架构设计、高效的存储与查询引擎、丰富的生态集成与云原生特性,为用户提供了一站式时序数据解决方案。它不仅解决了传统数据库在时序数据处理中的性能瓶颈,还降低了用户的使用门槛与运维成本,是物联网、监控、工业互联网等领域构建数据驱动应用的理想选择。
点击链接,了解更多产品详情:
登录后查看
https://www.influxdata.com/" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0, null, null, null, null, null, 9, null, 0, 0, null, 0, null, 0, null, 0, 0, null, 0);">https://www.influxdata.com/ 展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
0.0分项目
评分
同类平均分
综合
0
76
兼容性
0
76
稳定性
0
74
易用性
0
74
性能
0
74
市场占有率
0
76
功能
0
76
扩展性
0
76
美观度
0
76
技术服务
0
76
性价比
0
76
时间排序↓
最新
精华
0 条评论

向我咨询

发表评论