








Druid 是一种时序数据库,按照一定的时间粒度对数据进行聚合,以加快分析查询。
Druid
0.00条评价712次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
Druid是一款由Imply公司推出的高性能、实时分析型数据库产品,专为大规模数据集的实时查询与分析场景设计。其核心目标是帮助企业快速处理PB级别的结构化与半结构化数据,提供亚秒级的查询响应速度,支撑实时监控、多维分析、用户行为洞察等关键业务需求。Druid并非传统的事务型数据库,而是聚焦于OLAP(在线分析处理)领域,通过融合列式存储、分布式架构、实时数据摄入与优化查询引擎等技术,实现了高效的实时数据分析能力。
一、核心定位与整体架构
Druid的核心理念是“实时性”与“可扩展性”,旨在解决传统分析型数据库在处理大规模实时数据时的性能瓶颈。与传统数据仓库相比,Druid放弃了对事务ACID的严格支持,转而优化数据摄入的实时性和查询的响应速度,使其能够满足现代企业对实时数据价值挖掘的迫切需求。
- 实时性优先:Druid支持实时数据摄入与查询,数据从产生到可查询的延迟可控制在毫秒级,确保业务人员能够及时获取最新数据 insights。
- 大规模可扩展:采用分布式集群架构,存储与计算能力可通过增加节点线性扩展,轻松应对PB级数据量的增长。
- 多维分析友好:原生支持多维分析操作,如GroupBy、TopN、Timeseries等,能够快速生成多维度的聚合结果,满足业务人员的复杂分析需求。
- 企业级可靠性:提供高可用性配置、数据备份恢复、高级安全等特性,确保在生产环境中的稳定运行。
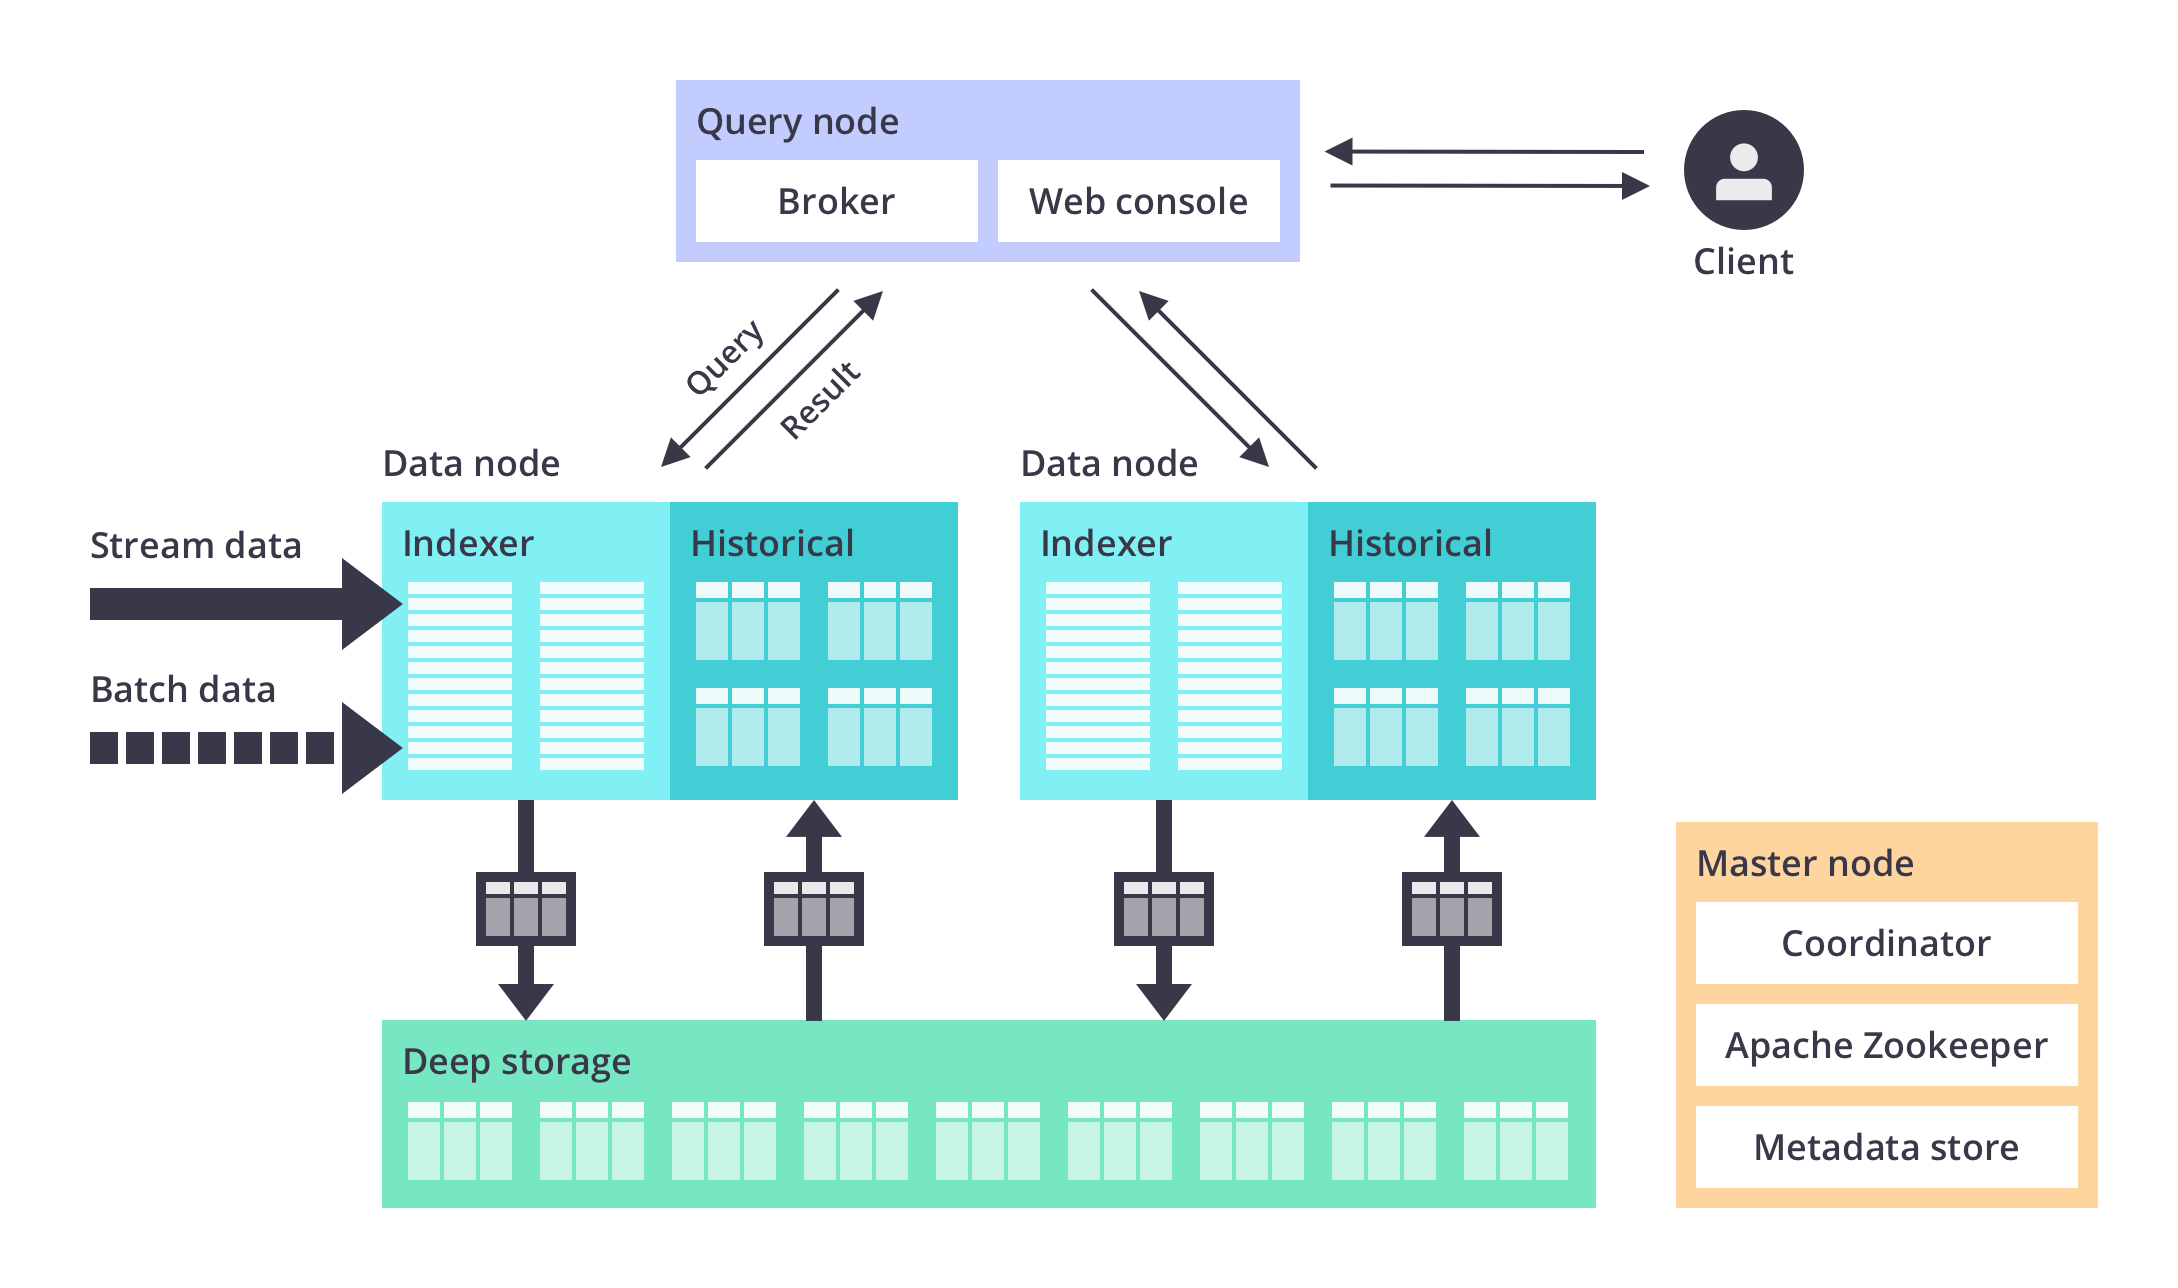
Druid的整体架构采用分层设计,主要包含以下核心组件:
- 数据源接入层:负责接收实时与批量数据,支持Kafka、Kinesis、HDFS、S3、HTTP等多种数据源。
- 摄入层(Ingestion Layer):处理数据摄入请求,包括数据清洗、转换、分区与索引生成,生成不可变的Segments文件。核心组件包括Overlord(任务调度)、MiddleManager(任务执行)。
- 存储层(Storage Layer):存储Segments文件,采用列式存储与压缩技术,确保高效存储与快速查询。核心组件包括Historical(存储历史数据)、Real-time(存储实时数据)。
- 查询层(Query Layer):处理用户查询请求,将查询分发到相关节点并聚合结果。核心组件包括Broker(查询路由与聚合)、Coordinator(集群管理与Segments分配)。
- 元数据层(Metadata Layer):存储集群元数据,如Datasources、Segments、Tasks等信息,依赖PostgreSQL或MySQL数据库。
- 服务层(Service Layer):提供Web控制台、API接口、可视化集成等功能,方便用户操作与管理。
二、核心功能模块详解
1. 数据摄入模块
数据摄入是Druid处理数据的第一步,支持实时与批量两种模式,覆盖多种数据源与数据格式,确保数据能够快速、准确地进入系统。
- 实时数据摄入:
- Kafka摄入:支持订阅Kafka主题,自动消费消息,支持Exactly-Once语义(通过Kafka的事务或Druid的幂等性写入)。用户可配置消费组、分区数、偏移量重置策略,支持JSON、Avro、Protobuf等格式。例如,电商平台可通过Kafka摄入实时订单数据,每秒处理10万+订单记录。
- Kinesis摄入:对接AWS Kinesis数据流,支持实时消费AWS上的日志、传感器数据等,适合云环境下的实时数据处理。
- HTTP摄入:通过REST API提交实时数据,适合小批量、低延迟的数据摄入场景,如用户行为事件的实时上报。
- 摄入转换:支持在摄入过程中进行数据清洗与转换,如字段映射(将“user_id”映射为“uid”)、过滤(排除无效数据)、计算新字段(从时间戳提取年/月/日)、维度值标准化(将“北京”统一为“北京市”)等,减少后续查询的计算量。
- 批量数据摄入:
- HDFS/S3摄入:支持从分布式存储读取批量数据,如Parquet、ORC、CSV、JSON文件。适合历史数据导入或定期批量数据处理,例如,每日导入前一天的用户行为日志到Druid中。
- 本地文件摄入:支持从本地磁盘读取文件,适合小规模批量数据导入,如测试数据或临时数据。
- 批量摄入工具:Druid提供Indexer工具,支持并行处理大规模批量数据,生成Segments文件。用户可配置并行度、分区策略、索引规则等,确保批量摄入的效率。
- 摄入监控与容错:支持监控摄入任务的状态、进度、错误信息,任务失败时可自动重试或手动重启。同时,支持数据一致性校验,确保摄入数据的准确性。
2. 数据存储模块
数据存储是Druid高效查询的基础,采用列式存储、分区管理、索引优化等技术,确保数据的高效存储与快速访问。
- 列式存储:Druid将每个字段单独存储为一列,查询时仅读取需要的列,大幅减少I/O开销。例如,查询“销售额>1000”时,仅需读取“销售额”列,无需读取其他无关列。
- Segments管理:数据按时间分区生成Segments文件,每个Segment包含一定时间范围的数据(如1小时或1天),且Segments是不可变的。这种设计简化了数据管理,删除数据时直接删除对应的Segments,写入数据时生成新的Segments,避免了复杂的事务处理。
- 索引结构:
- 倒排索引:用于字符串维度的快速过滤,如查询“地区=上海”的记录,倒排索引可快速定位所有符合条件的行。
- 位图索引:用于高基数维度(如用户ID)的过滤,位图索引将每个维度值映射为一个位图,通过位运算快速计算符合条件的记录数,性能远高于传统的B树索引。
- 数值索引:用于数值维度的范围查询,如“年龄>30”,数值索引采用排序结构,支持快速范围扫描。
- 数据压缩:支持LZ4、Snappy、ZSTD等多种压缩算法,压缩比可达10:1甚至更高,大幅降低存储成本。例如,原始数据为100GB,压缩后仅需10GB左右的存储空间。
- 数据保留策略:支持按时间自动删除旧数据(TTL),用户可配置不同的保留周期,如保留最近30天的详细数据,30天以上的数据自动聚合为按天的统计数据,既满足业务需求,又节省存储资源。
- 数据备份恢复:支持将Segments备份到S3或HDFS,在集群故障时可快速恢复数据。同时,支持Segments的复制,确保数据的高可用性。
3. 查询引擎模块
查询引擎是Druid的核心竞争力之一,支持SQL与原生查询,提供高效的聚合计算与多维分析能力,确保亚秒级的查询响应速度。
- SQL支持:Druid SQL基于Apache Calcite实现,兼容标准SQL语法,支持SELECT、FROM、WHERE、GROUP BY、JOIN(有限制)、ORDER BY、LIMIT等操作。用户无需学习新的查询语言,即可快速上手。例如,查询最近1小时的销售额按地区分组:
SELECT region, SUM(sales) AS total_sales FROM orders WHERE __time >= CURRENT_TIMESTAMP - INTERVAL '1' HOUR GROUP BY region ORDER BY total_sales DESC;
- 原生查询:Druid提供JSON格式的原生查询API,支持更灵活的查询操作,如TopN(获取维度的前N个值)、Timeseries(按时间序列聚合)、GroupBy(多维分组聚合)、Scan(全表扫描)等。原生查询更贴近Druid的内部机制,性能更高,适合高级用户。例如,TopN查询获取最近1小时销售额最高的前5个地区:
{ "queryType": "topN", "dataSource": "orders", "intervals": ["2024-05-01T00:00:00/2024-05-01T01:00:00"], "dimension": "region", "metric": "sales", "threshold": 5, "aggregations": [{"type": "longSum", "name": "total_sales", "fieldName": "sales"}] } - 聚合函数:
- 基本聚合:SUM、COUNT、AVG、MIN、MAX等,适用于小规模数据的精确计算。
- 近似聚合:HyperLogLog(基数统计,如计算独立用户数)、Theta Sketch(交集/并集/差集,如计算两个用户群体的重叠数)、Quantiles(分位数,如计算销售额的中位数)等。这些函数在大数据量下性能远高于精确聚合,且误差可控(通常在1%以内)。
- 多维分析:支持ROLLUP(预聚合)与CUBE(多维立方体)操作。ROLLUP在摄入时预计算聚合结果,减少查询时的计算量;CUBE生成多维度的聚合结果,支持快速的多维分析。例如,通过CUBE操作可同时获取按地区、按时间、按地区+时间的销售额统计结果。
- 查询优化:
- 预聚合:用户可在摄入时配置预聚合规则,生成聚合后的Segments,查询时直接使用预聚合结果,大幅提升查询速度。
- 缓存机制:支持查询结果缓存与分段缓存,相同查询可直接返回缓存结果,减少重复计算。缓存可配置过期时间,确保数据的新鲜度。
- 并行查询:查询请求被Broker分发到多个Historical或Real-time节点并行执行,每个节点处理部分数据,最后由Broker聚合结果,充分利用集群资源。
- 分区裁剪:查询时仅扫描与时间范围或维度条件相关的Segments,避免全表扫描,提高查询效率。
4. 数据管理模块
数据管理模块提供元数据管理、分区管理、数据更新等功能,确保数据的有序组织与高效维护。
- 元数据管理:Druid的元数据存储在PostgreSQL或MySQL数据库中,包括Datasources(数据源)、Segments(数据段)、Tasks(摄入任务)等信息。Coordinator组件负责管理元数据,确保集群状态的一致性。
- 分区管理:支持自动分区与手动分区。自动分区按时间维度划分Segments,用户可配置分区间隔(如1小时、1天);手动分区可按其他维度(如地区)划分Segments,适合特定业务场景。
- 数据更新:虽然Segments是不可变的,但Druid支持两种数据更新方式:Overwrite(覆盖旧数据)与Append(追加新数据)。例如,修正历史数据错误时,可通过Overwrite方式重新生成对应的Segments;添加新数据时,通过Append方式生成新的Segments。
- 数据归档:支持将旧Segments归档到低成本存储(如S3冰川),减少活跃存储的压力,同时保留历史数据的可查询性。
5. 可视化与集成模块
可视化与集成模块方便用户快速分析数据,生成直观的图表与仪表盘,并与现有系统无缝集成。
- Druid Console:内置的Web控制台,支持数据摄入配置、查询执行、Segments管理、集群监控等功能。用户可通过Console查看集群状态、执行SQL查询、生成图表,界面友好,操作简便。
- 第三方可视化工具集成:支持与Tableau、Superset、Looker、Grafana等主流可视化工具集成。通过JDBC驱动或REST API连接Druid,用户可利用熟悉的工具进行数据分析。例如,使用Grafana构建实时监控仪表盘,展示服务器的CPU使用率、内存占用等指标。
- Imply Pivot:Imply提供的可视化工具,专为Druid设计。支持拖拽式分析,用户可快速选择维度与指标,生成折线图、柱状图、饼图、热力图等图表,无需编写SQL。Pivot还支持仪表盘创建,实时更新数据,适合业务人员自助分析。
- API集成:提供REST API接口,支持数据摄入、查询、集群管理等操作,方便与其他系统集成。例如,企业可通过API将Druid的查询结果嵌入到自己的业务系统中,为用户提供实时数据服务。
6. 运维监控模块
运维监控模块确保集群的稳定运行,帮助管理员快速发现与解决问题。
- 集群监控:支持收集集群节点的Metrics(CPU、内存、磁盘、网络、I/O等),通过Prometheus、Grafana等工具展示。管理员可实时查看集群的资源使用情况,及时调整资源配置。
- 任务监控:监控数据摄入任务的状态(运行中、成功、失败)、进度、错误日志等信息。任务失败时,系统可自动重试或发送告警通知管理员。
- 告警系统:支持配置告警规则,如Segments缺失、查询延迟过高、节点故障、资源使用率超过阈值等。告警信息可通过邮件、Slack、钉钉等方式通知管理员,确保问题及时处理。
- 多租户支持:企业版Druid支持多租户隔离,不同租户的数据与资源相互独立。管理员可为每个租户分配独立的Datasources、计算资源、存储资源,确保数据安全与资源公平使用。
- 高可用性配置:关键组件(Coordinator、Overlord、Broker)支持多副本部署,故障自动转移。例如,Coordinator节点故障时,备用Coordinator节点自动接管,确保集群管理不中断。Segments采用多副本存储,节点故障时可从其他节点读取数据,确保数据的可用性。
- 安全管理:企业版Druid提供高级安全特性,包括:
- 身份认证:支持LDAP、Kerberos、OAuth2等认证方式,确保只有授权用户才能访问集群。
- 权限控制:基于RBAC(角色-based访问控制),为用户分配不同的角色(如管理员、分析师、只读用户),控制用户对数据与功能的访问权限。
- 数据加密:支持静态数据加密(Segments文件加密)与传输数据加密(SSL/TLS),确保数据在存储与传输过程中的安全。
- 审计日志:记录用户的操作日志,包括登录、查询、数据摄入等,便于审计与追溯。
三、技术特点与优势
Druid的技术特点与优势使其在实时分析领域脱颖而出,主要体现在以下几个方面:
- 亚秒级查询响应:通过列式存储、索引优化、预聚合等技术,Druid能够在PB级数据集中实现亚秒级的查询响应速度,满足实时分析的需求。
- 高吞吐数据摄入:支持百万级事件/秒的实时数据摄入速度,能够处理大规模的实时数据流,如电商订单、用户行为、传感器数据等。
- 线性可扩展性:分布式架构设计,增加节点即可线性提升存储与计算能力,无需重构系统,适应业务的快速增长。
- 高效存储:列式存储+压缩+预聚合,存储成本低,相同数据量下,Druid的存储需求仅为传统数据库的1/10到1/5。
- SQL友好:兼容标准SQL,降低用户学习成本,方便与现有系统集成,减少迁移成本。
- 灵活的数据模型:支持维度与指标的灵活定义,无需预先定义Schema(Schema-on-read),适应半结构化数据的处理需求。
- 企业级可靠性:高可用性配置、数据备份恢复、高级安全等特性,确保在生产环境中的稳定运行,满足企业级应用的需求。
四、典型应用场景
Druid广泛应用于实时监控、用户行为分析、日志分析、广告技术、物联网等领域,以下是几个典型场景:
- 实时销售监控:电商平台使用Druid实时摄入订单数据,按地区、商品类别、时间维度分析销售额、订单量、用户数等指标。业务人员可通过仪表盘实时查看销售情况,及时调整营销策略。例如,某电商平台每秒摄入10万+订单数据,Druid支持亚秒级查询响应,帮助平台实时监控“618”大促的销售趋势。
- 用户行为分析:互联网公司使用Druid分析用户的点击、浏览、购买、留存等行为。通过实时查询用户的行为路径,了解用户偏好,优化产品体验。例如,某短视频APP使用Druid分析用户的观看时长、点赞数、分享数等指标,实时调整推荐算法,提升用户粘性。
- 日志分析:IT运维团队使用Druid分析服务器日志、应用日志、网络日志等。通过实时查询日志数据,快速定位系统故障,优化系统性能。例如,某云计算公司使用Druid分析服务器的CPU使用率、内存占用、磁盘I/O等指标,实时检测异常情况,减少系统 downtime。
- 广告投放效果分析:广告平台使用Druid实时分析广告的点击率、转化率、曝光量等指标。按广告位、受众群体、时间维度统计效果,优化广告投放策略。例如,某广告平台使用Druid实时监控广告的投放效果,每秒处理百万级广告事件,帮助广告主实时调整投放预算。
- 物联网数据分析:工业企业使用Druid分析传感器数据,实时监控设备状态,预测设备故障。例如,某制造企业使用Druid分析生产线上的传感器数据,实时检测设备的温度、压力、振动等指标,提前预警设备故障,减少生产中断。
- 金融欺诈检测:银行使用Druid实时分析交易数据,检测异常交易行为。通过查询交易的金额、时间、地点、用户等维度,识别欺诈模式,防范金融风险。例如,某银行使用Druid实时监控交易数据,每秒处理10万+交易记录,亚秒级响应异常交易查询,有效降低欺诈损失。
五、总结
Druid作为一款高性能实时分析型数据库,通过融合列式存储、分布式架构、实时数据摄入与优化查询引擎等技术,为企业提供了高效的实时数据分析解决方案。其核心优势在于亚秒级查询响应、高吞吐数据摄入、线性可扩展性与企业级可靠性,能够满足现代企业对实时数据价值挖掘的迫切需求。无论是实时监控、用户行为分析还是日志分析,Druid都能提供快速、可靠的支持,帮助企业快速获取数据 insights,驱动业务决策。
了解更多Druid产品详情,请访问Imply官网:
登录后查看
https://druid.apache.org/" rel="noopener noreferrer" target="_blank" style="color: rgb(230, 0, 0, null, null, null, null, null, 9, null, 0, 0, null, 0, null, 0, null, 0, 0, null, 0);">https://druid.apache.org/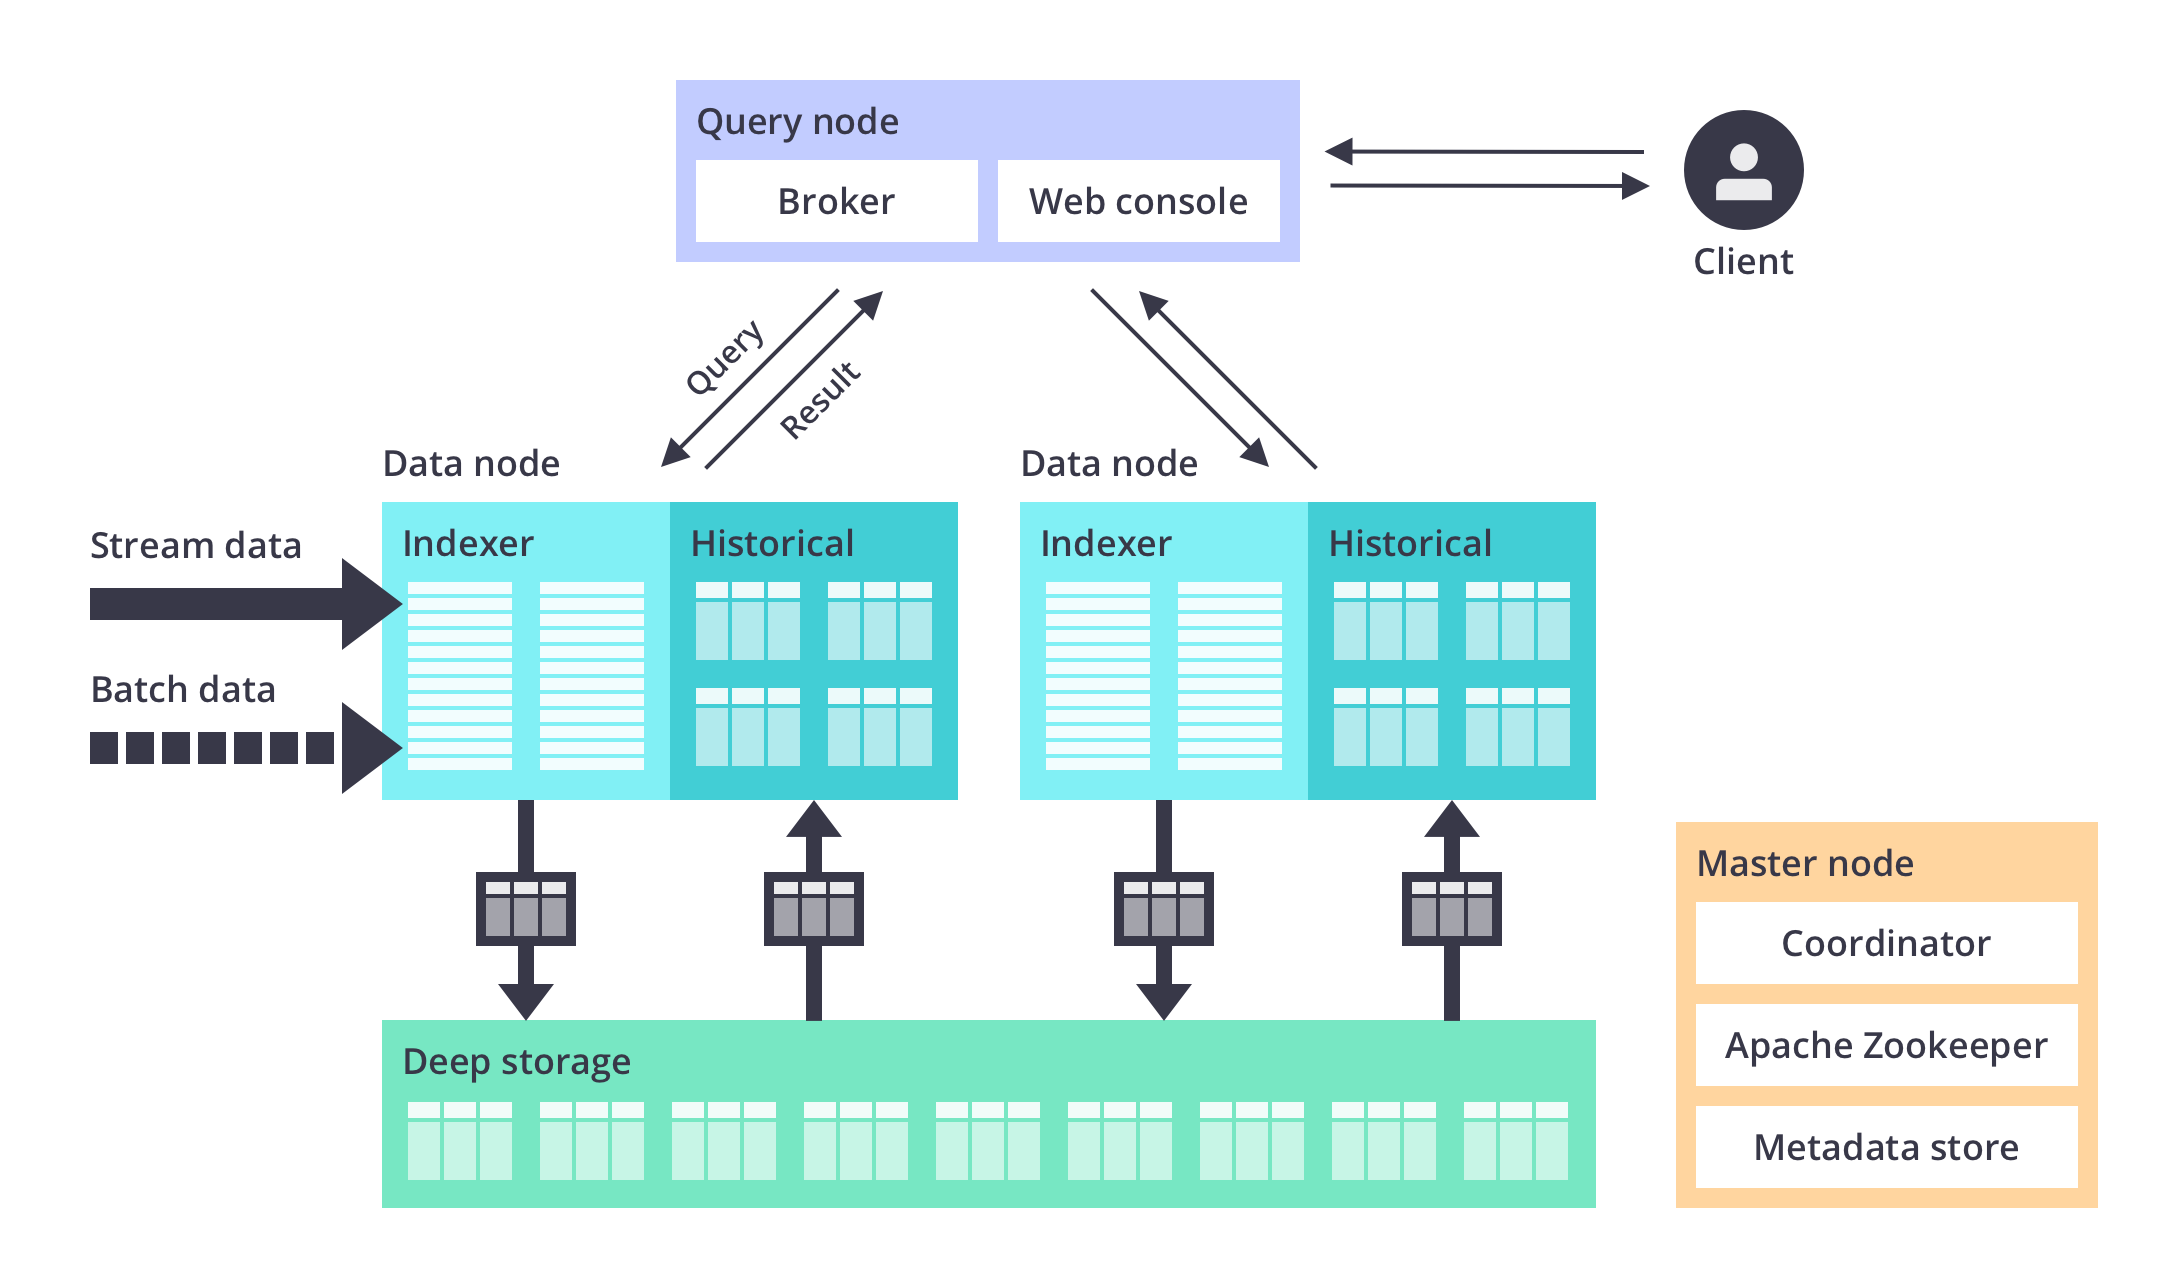
展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
0.0分项目
评分
同类平均分
综合
0
76
兼容性
0
76
稳定性
0
74
易用性
0
74
性能
0
74
市场占有率
0
76
功能
0
76
扩展性
0
76
美观度
0
76
技术服务
0
76
性价比
0
76
时间排序↓
最新
精华
0 条评论

向我咨询

发表评论