








JanusGraph是一个图形数据库引擎。其本身专注于紧凑图序列化、丰富图数据建模、高效的查询执行。另外,JanusGraph利用Hadoop进行图分析和批处理图处理。JanusGraph为数据持久性、数据索引、客户端访问实现了强大的模块化接口。JanusGraph的模块化体系结构使其可以与多种存储

JanusGraph
0.00条评价754次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
JanusGraph是一款开源分布式图数据库系统,旨在为企业级应用提供高效存储、查询和管理海量图数据的能力。它基于Apache TinkerPop图计算框架构建,支持属性图模型,能够处理包含数十亿顶点和数万亿边的大规模图数据,满足复杂关系型数据场景下的低延迟查询与深度分析需求。JanusGraph的核心设计目标是解决传统关系型数据库在处理高度关联数据时的性能瓶颈,同时提供分布式系统的高可用性、可扩展性和容错性。
一、核心定位与整体架构
JanusGraph作为分布式图数据库,其核心定位聚焦于以下三个方向:
- 海量图数据存储:通过分布式架构支持水平扩展,轻松应对PB级图数据的存储需求;
- 复杂关系查询:提供高效的图遍历、路径分析、邻接查询等操作,支持毫秒级响应复杂关系型查询;
- 企业级可靠性:具备高可用性、事务支持、故障恢复能力,满足企业级应用的严苛要求;
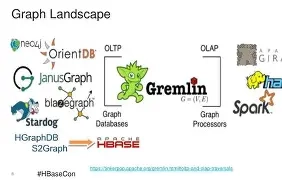
- 开放生态兼容:完全兼容Apache TinkerPop图计算框架,易于与现有大数据工具链集成。
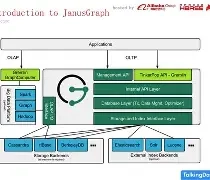
JanusGraph的整体架构采用分层设计,各组件职责清晰且可扩展,主要分为以下五层:
- 存储层:负责持久化图数据,支持Apache Cassandra、HBase、BerkeleyDB等多种后端存储引擎,提供分布式存储能力;
- 计算层:基于TinkerPop框架实现图遍历与计算逻辑,支持Gremlin查询语言和分布式图算法;
- 索引层:集成二级索引、全文索引、地理空间索引,加速复杂条件查询;
- 集成层:与Spark、Flink、Kafka等大数据工具集成,扩展图数据处理场景;
- API层:通过Gremlin Server提供REST/WebSocket API,支持多语言客户端调用。
二、核心功能模块详解
1. 属性图数据模型支持
JanusGraph采用属性图模型,直观表达实体与关系,其核心组成部分包括:
- 顶点(Vertex):代表实体(如用户、商品),具有唯一ID、标签(如User、Product)和属性(如name、age);
- 边(Edge):代表关系(如好友、购买),具有方向、标签(如Friend、Purchase)和属性(如timestamp、amount);
- 属性(Property):键值对数据,支持字符串、整数、浮点数、日期、地理坐标等10+数据类型;
- 标签(Label):分类顶点/边,帮助区分实体类型(如User vs Product)和关系类型(如Friend vs Follow);
- 索引(Index):支持二级索引、全文索引、地理空间索引,基于属性加速查询。
例如,一个用户顶点可定义为:g.addV("User").property("name", "Alice").property("age", 30).property("city", "Beijing"),一条购买边为:g.V().has("User", "name", "Alice").addE("Purchase").to(g.V().has("Product", "id", "P001")).property("amount", 999.0).property("time", LocalDateTime.now())。
2. 分布式存储与水平扩展
JanusGraph的分布式特性是其核心优势,支持通过增加节点实现线性扩展:
- 多后端存储:
- Apache Cassandra:高可用分布式存储,适合高吞吐量场景;
- Apache HBase:列存储数据库,适合超大规模数据集;
- BerkeleyDB:嵌入式存储,适合单机测试;
- ScyllaDB:兼容Cassandra,提供更低延迟。
- 水平扩展:数据分片存储在多个节点,新增节点自动平衡负载,无需停机;
- 多数据中心部署:支持跨地域数据同步,实现灾难恢复。
配置Cassandra作为后端存储的示例:
JanusGraph graph = JanusGraphFactory.build()
    .set("storage.backend", "cassandra")
    .set("storage.hostname", "cassandra-1,cassandra-2")
    .set("storage.cassandra.keyspace", "janusgraph")
    .open();
3. Gremlin查询语言与TinkerPop集成
JanusGraph完全兼容Apache TinkerPop,支持Gremlin查询语言,可表达复杂图逻辑:
- 基础遍历:查找Alice的所有好友:
g.V().has("User", "name", "Alice").out("Friend").values("name"); - 路径查找:Alice到Bob的最短路径:
g.V().has("name", "Alice").repeat(out("Friend")).until(has("name", "Bob")).path().limit(1); - 聚合分析:统计每个城市的用户数量:
g.V().hasLabel("User").groupCount().by("city"); - 实时更新:添加用户好友关系:
g.V().has("name", "Alice").addE("Friend").to(g.V().has("name", "Charlie"))。
Gremlin支持函数式编程风格,可通过链式调用组合复杂查询,同时兼容TinkerPop的Gremlin Server,提供远程查询能力。
4. 丰富的索引功能
JanusGraph提供多种索引类型,提升查询性能:
- 二级索引:基于属性的等值/范围查询,如创建用户年龄索引:
mgmt.buildIndex("userByAge", Vertex.class).addKey(mgmt.getPropertyKey("age")).build(); - 全文索引:与Elasticsearch/Solr集成,支持模糊查询,如商品描述索引:
mgmt.buildIndex("productByDesc", Vertex.class).addKey(mgmt.getPropertyKey("description"), Mapping.TEXT).build(); - 地理空间索引:与Elasticsearch集成,支持坐标查询,如查找北京周边POI:
g.V().has("location", geoWithin(Geoshape.circle(116.40, 39.90, 10))); - 复合索引:多属性组合查询,如用户年龄+城市索引:
mgmt.buildIndex("userByAgeCity", Vertex.class).addKey("age").addKey("city").build()。
索引支持动态创建/删除,无需重启服务,方便业务调整。
5. 事务支持与一致性保障
JanusGraph提供ACID事务支持,确保数据操作的可靠性:
- 原子性:事务内操作要么全部成功,要么全部回滚;
- 一致性:事务执行前后数据状态一致;
- 隔离性:乐观并发控制,避免冲突;
- 持久性:提交后数据永久保存。
分布式事务通过后端存储的一致性协议(如Cassandra的Paxos)保障,支持跨节点事务操作。
6. 高可用性与容错性
JanusGraph通过以下机制保障高可用:
- 多副本存储:后端存储(如Cassandra)默认3副本,节点故障不影响服务;
- 故障转移:Gremlin Server集群部署,请求自动路由到可用节点;
- 自动恢复:定期检测故障节点,自动重建数据副本;
- 无单点故障:所有组件集群化部署,无单点瓶颈。
7. 安全特性
JanusGraph提供企业级安全功能:
- 认证授权:支持LDAP/AD认证,RBAC角色权限控制;
- 数据加密:TLS/SSL传输加密,存储加密(依赖后端存储);
- 审计日志:记录所有操作日志,便于事后审计;
- ACL控制:细粒度访问控制,限制用户对特定顶点/边的操作。
8. 集成能力
JanusGraph与多种工具集成,扩展应用场景:
- 大数据生态:与Spark集成实现分布式图分析(如PageRank),与Flink集成实时图处理,与Kafka集成数据流导入;
- 可视化工具:与Gephi集成展示图结构,与Neo4j Browser兼容;
- 编程语言:支持Java、Python、Scala、Groovy等;
- REST API:Gremlin Server提供REST/WebSocket API,支持跨语言调用。
例如,Spark集成示例:
// 读取JanusGraph数据到Spark RDD
JavaPairRDD<Vertex, Iterable<Edge>> graphRDD = sparkContext.newAPIHadoopRDD(
    config.getInputFormatConfiguration(),
    JanusGraphInputFormat.class,
    Vertex.class,
    Iterable.class
);
// 运行PageRank算法
GraphFrame gf = GraphFrame.fromEdges(graphRDD.flatMapToPair(v -> {
    List<Tuple2<String, String>> edges = new ArrayList<>();
    v._2().forEach(e -> edges.add(new Tuple2<>(v._1().id().toString(), e.inVertex().id().toString())));
    return edges.iterator();
}).toDF("src", "dst"));
GraphFrame pageRank = gf.pageRank().resetProbability(0.15).maxIter(10).run();
pageRank.vertices().show();
9. 监控与运维
JanusGraph提供完善的运维工具:
- Metrics监控:集成Dropwizard Metrics,收集查询延迟、吞吐量、存储使用率等指标;
- 日志管理:详细记录查询、错误、系统日志,支持ELK stack集成;
- 命令行工具:JanusGraph Shell支持交互式查询与管理;
- 备份恢复:支持数据导出(GraphSON/GraphML)与导入,确保数据安全。
三、技术特点与优势
- 分布式线性扩展:通过增加节点实现存储/计算能力线性增长,支持数十亿顶点;
- 多后端灵活性:支持多种存储引擎,适配不同业务场景;
- 丰富索引支持:二级/全文/地理空间索引,覆盖各类查询需求;
- TinkerPop兼容:无缝集成Gremlin生态,降低迁移成本;
- 高性能查询:优化的图遍历算法,毫秒级响应复杂查询;
- 企业级安全:认证授权、加密、审计,满足合规要求;
- 高可用性:无单点故障,7x24小时持续服务;
- 开源生态:活跃社区支持,持续迭代更新。
四、典型应用场景
- 社交网络:存储好友/关注关系,实现推荐系统、人脉分析;
- 知识图谱:构建实体关系网络(如医疗、电商),支持智能问答、语义搜索;
- 欺诈检测:识别异常交易关系,检测团伙欺诈;
- 网络运维:存储IT拓扑,快速定位故障路径;
- 供应链管理:分析节点关系,优化供应链流程;
- 生物医药:存储分子结构/蛋白质交互,加速药物研发;
- 推荐系统:基于用户行为关系,生成个性化推荐。
五、总结
JanusGraph作为开源分布式图数据库的佼佼者,以其强大的分布式能力、丰富的功能特性和开放的生态兼容,成为处理复杂关系型数据的首选工具。它帮助企业挖掘数据中的关系价值,驱动业务创新,无论是社交网络、知识图谱还是欺诈检测,JanusGraph都能提供高效、可靠的解决方案。
了解更多JanusGraph产品详情,请访问官方网站:
登录后查看

展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
0.0分项目
评分
同类平均分
综合
0
60
兼容性
0
60
稳定性
0
62
易用性
0
58
性能
0
60
市场占有率
0
60
功能
0
66
扩展性
0
62
美观度
0
62
技术服务
0
56
性价比
0
56
时间排序↓
最新
精华
0 条评论

向我咨询

发表评论