Greenplum 是一款基于 PostgreSQL 开发的开源 MPP 数据仓库,专为处理大规模数据分析任务而设计。它通过大规模并行处理架构,实现了高效的分布式查询处理能力,能够快速处理海量数据。
2.1 核心架构
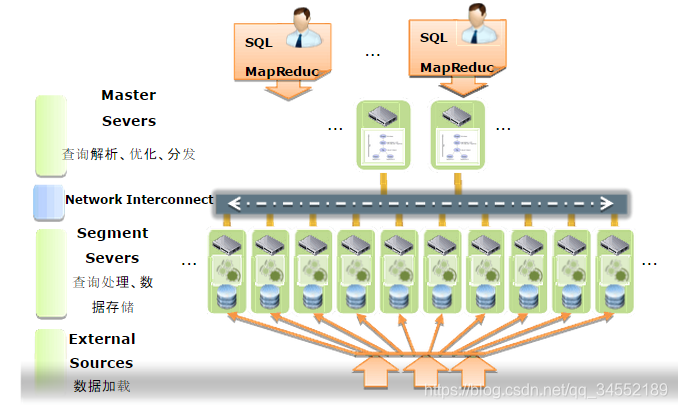
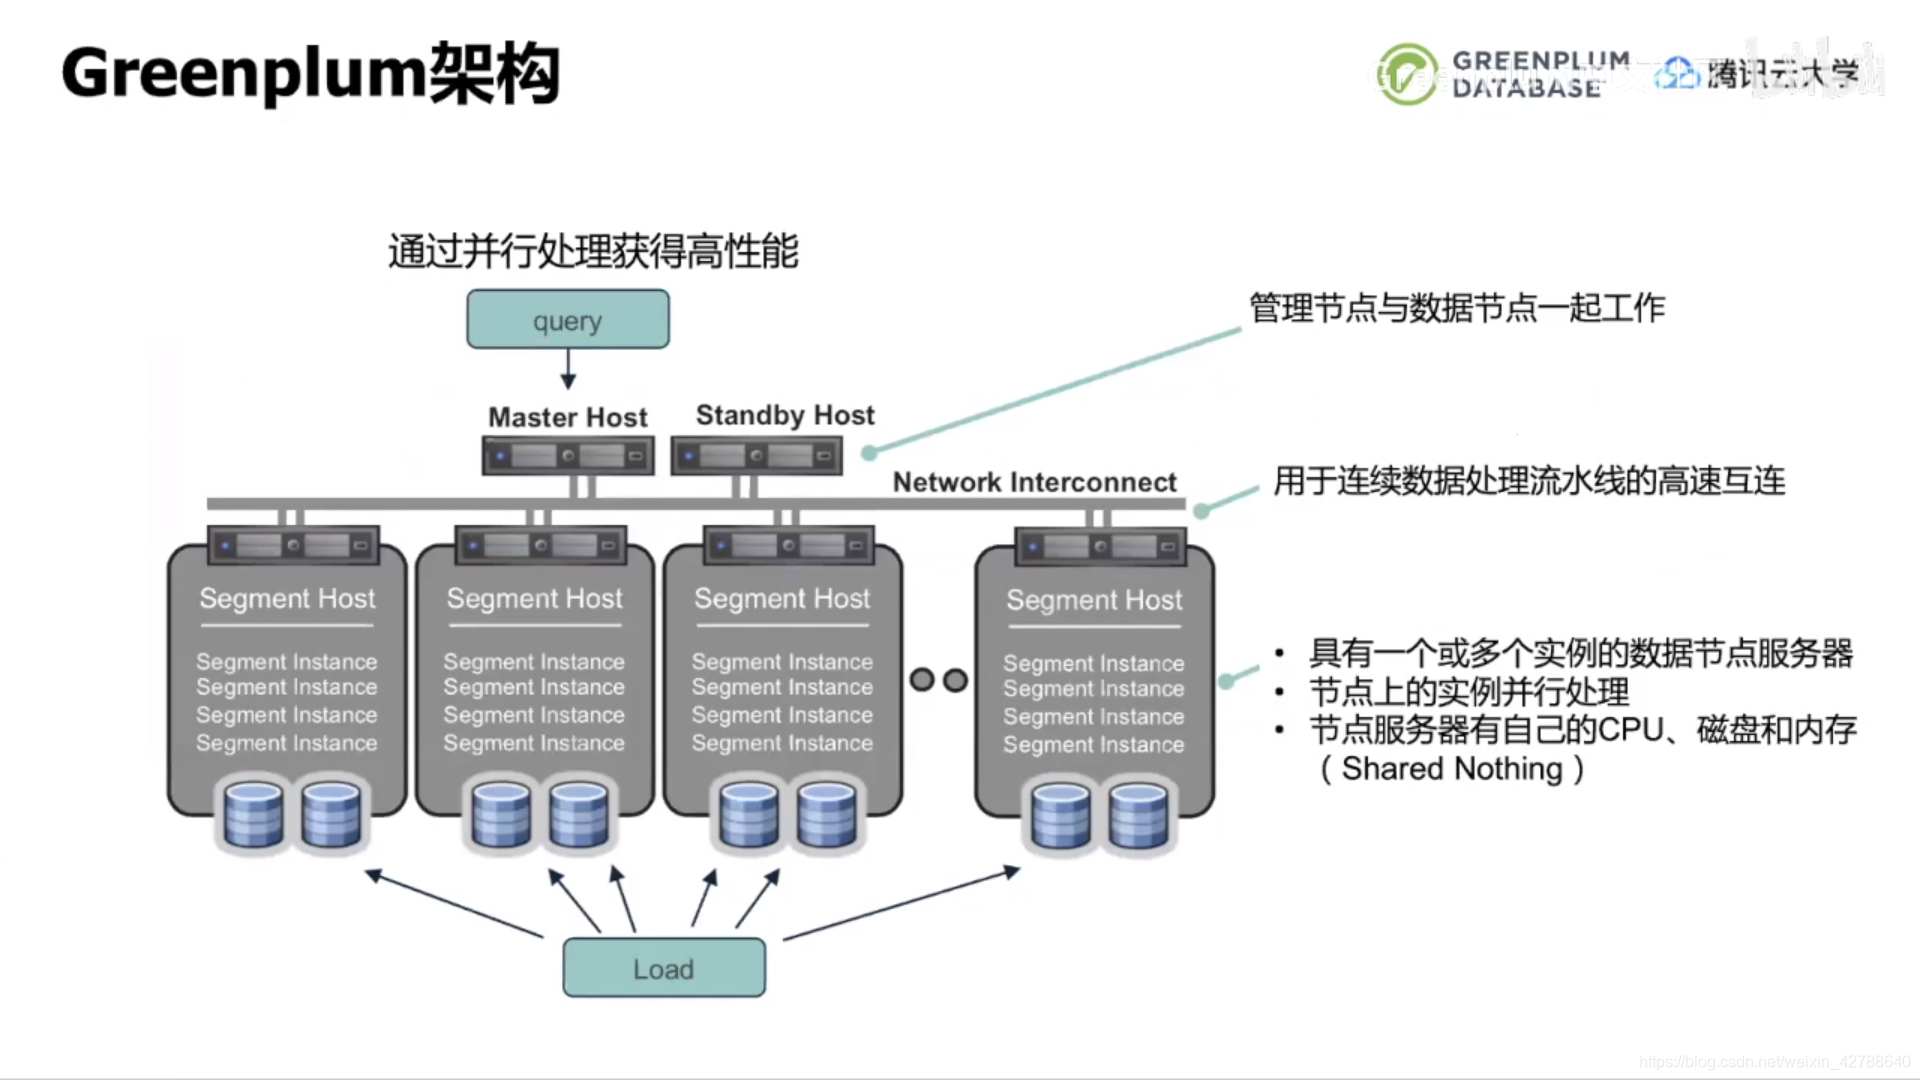
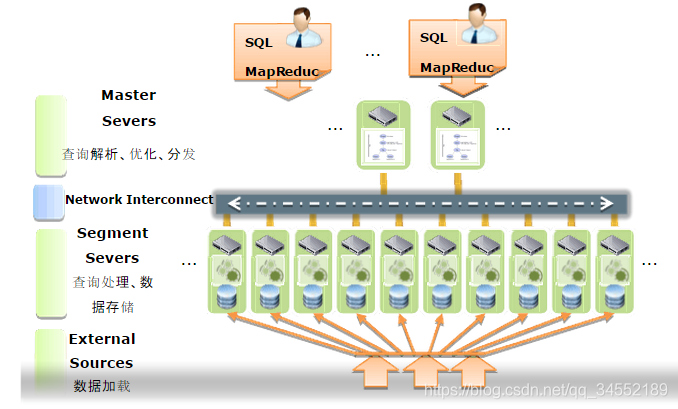
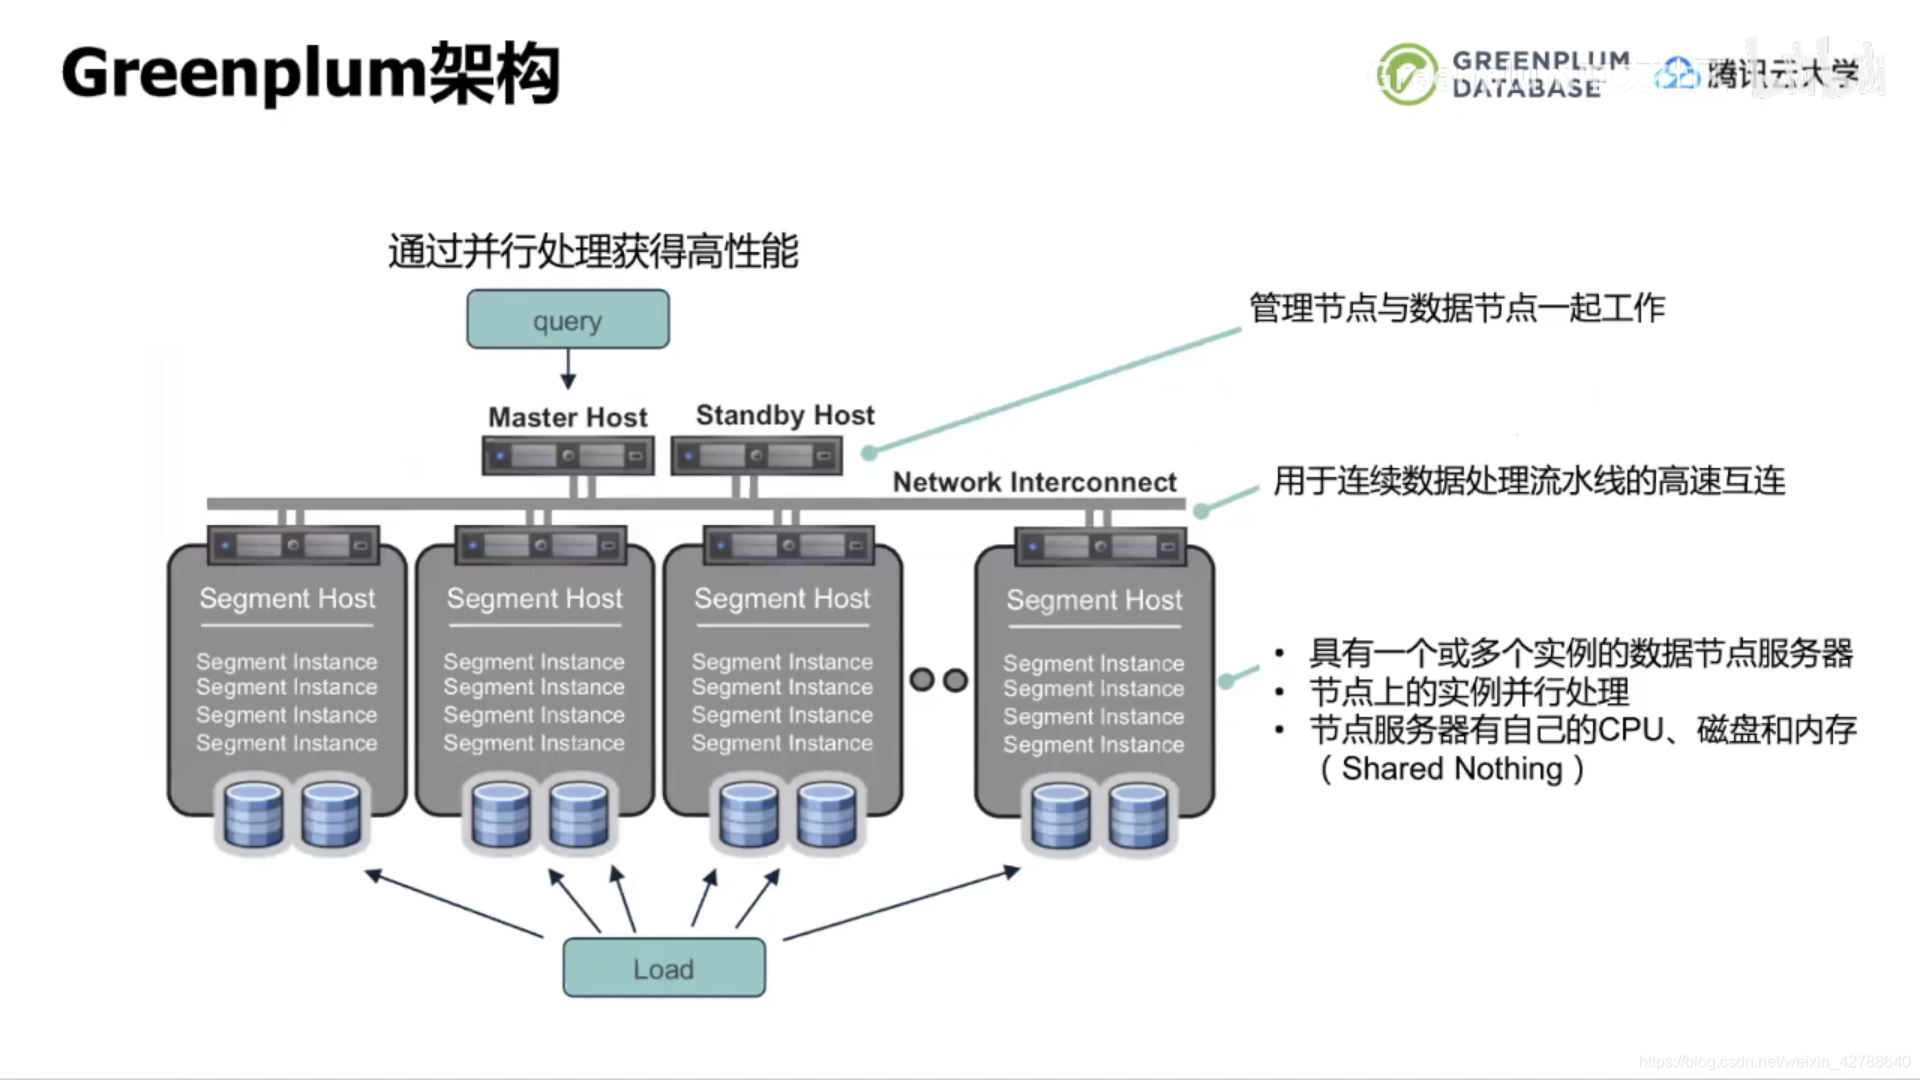
Greenplum 的架构基于 MPP(Massively Parallel Processing)设计,主要由以下两个关键组件构成:
Master 节点:负责接收客户端查询请求、生成查询计划,并将任务分发给 Segment 节点。
Segment 节点:实际存储数据并执行查询任务,每个节点运行独立的 PostgreSQL 实例。
这种架构支持通过增加 Segment 节点实现线性扩展,能够应对日益增长的数据量和查询压力。
2.2 产品特点
高性能查询:支持 ANSI SQL 2008 和 SQL OLAP 2003 扩展,查询稳定性强。
线性扩展:通过增加节点实现存储和处理能力的线性扩展。
与大数据生态集成:支持与 Hadoop、Spark、Kafka 等大数据工具无缝集成。
高可用性:支持节点级镜像和主节点容错机制。
高性价比:基于开源 PostgreSQL,可在普通硬件上运行。
2.3 应用场景
Greenplum 适用于以下场景:
企业级数据仓库:支持复杂的多表连接、聚合和分析查询。
大规模数据分析:适用于实时分析、业务智能(BI)和数据挖掘。
批处理和 ETL 任务:支持高效的数据导入和清洗。
3. Greenplum 的优势与不足
优势:
强大的 SQL 支持和查询稳定性。
与大数据生态系统无缝集成。
线性扩展能力,适合 PB 级数据处理。
高性价比,基于开源 PostgreSQL。
不足:
维护成本高,尤其是节点规模上升后。
扩容和缩容操作较为复杂。