








阿里云(Alibaba Cloud)创立于2009年,是全球领先的云计算及人工智能科技公司。公司总部位于杭州,隶属阿里巴巴集团,现服务已覆盖200多个国家和地区。阿里云以自研的飞天云计算操作系统为核心,面向政府、企业及开发者提供IaaS、PaaS、MaaS三层架构的全栈云服务
ChaosBlade
53.03条评价364次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
在分布式系统和云原生架构成为主流的今天,系统的复杂性呈指数级增长。服务之间依赖繁多、网络环境瞬息万变、基础设施可能随时故障。传统的测试方法无法覆盖所有潜在的不稳定场景,“黑天鹅”事件频发。混沌工程应运而生,它通过主动注入故障来验证系统在异常条件下的表现,从而建立韧性。阿里巴巴开源的ChaosBlade,正是这一领域的翘楚,它已从一个故障注入工具演进为面向云原生领域的混沌工程平台。
一、 核心定位与设计理念:简单、强大、可扩展
ChaosBlade的核心理念是 “混沌工程实验模型” 。它不仅仅是一个故障注入工具集,更是一个完整的实验生命周期管理框架。其设计遵循三大原则:
- 简单性:通过统一的命令行工具
blade,用户可以用一致的命令语法对不同的目标(如容器、Kubernetes、应用、主机)进行故障注入,极大降低了学习和使用成本。 - 强大性:覆盖范围广,从基础资源(CPU、内存、磁盘、网络)到应用层(如Java应用的方法延迟、异常抛出)、再到中间件(如MySQL、Redis)和平台层(如Kubernetes、Docker),支持丰富的故障场景。
- 可扩展性:采用高度模块化的设计。其核心是一个框架,各种故障场景以“插件”(ChaosBlade Project)的形式存在,方便社区和用户扩展新的故障类型和目标环境。
二、 架构解析:层次化与模块化的完美结合
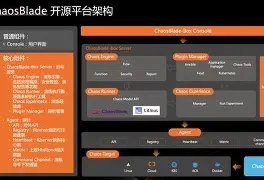
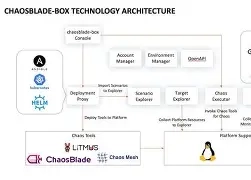
ChaosBlade的架构清晰地将实验定义、实验执行和实验管理分离开来。
- ChaosBlade CLI (
blade): 是面向用户的统一入口。它负责解析命令、创建实验、查询状态和销毁实验。 - ChaosBlade Operator: 这是ChaosBlade在Kubernetes环境中的核心组件。它以DaemonSet的形式部署在集群中,负责接收指令,并在特定的目标Pod中执行故障注入动作。它本质上是Kubernetes API和ChaosBlade执行器之间的桥梁。
- ChaosBlade执行器: 这是真正执行故障注入的组件。每个目标环境都有对应的执行器。
- ChaosBlade Java Agent: 通过Java Agent技术,无需修改代码即可对JVM应用进行深入的故障注入,如方法延迟、返回值篡改、抛异常等。
- ChaosBlade C++: 用于C++应用。
- Docker/容器执行器: 在容器内利用
nsenter等命令注入资源类故障。 - OS执行器: 在主机层面利用
stress-ng、tc等命令注入CPU、内存、网络故障。
工作流程简述:
- 用户通过
blade命令发起实验,例如:blade create k8s node-cpu load --cpu-percent 80 --names node01。 bladeCLI将请求发送给目标集群的ChaosBlade Operator。- Operator根据实验定义,找到目标节点
node01,并在该节点上部署一个短暂的“故障注入Pod”。 - 该Pod内的执行器开始执行
stress-ng命令,将节点CPU占用率拉高到80%。 - 实验状态被持续监控,用户可随时通过
blade destroy命令停止实验。
三、 核心功能场景详解
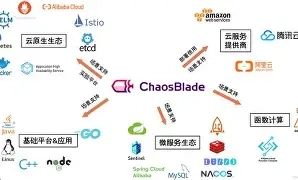
ChaosBlade的功能覆盖可以概括为四个层次:资源层、应用层、中间件层、平台层。
1. 基础设施资源层故障注入
这是混沌工程的基础,模拟底层基础设施的不稳定性。
- CPU故障:模拟CPU高负载。可精确控制负载百分比、绑定到特定核心,用于验证应用在计算资源不足时的降级能力。
blade create cpu load --cpu-percent 80 --cpu-count 2- 内存故障:模拟内存耗尽或占用。可指定占用大小、比例,验证应用的内存管理机制和OOM Killer处理。
blade create mem load --mode ram --mem-percent 80- 磁盘故障:模拟磁盘IO高负载、磁盘空间满、读写延迟等。这是验证有状态服务(如数据库)持久化能力的关键。
blade create disk burn --read --path /home/- 网络故障:这是最复杂也最常见的场景。模拟网络延迟、丢包、包损坏、分区等。
- 延迟:
blade create network delay --time 3000 --interface eth0 --remote-ip 10.0.0.1 - 丢包:
blade create network loss --percent 50 --interface eth0 - 网络分区:模拟整个可用区或集群之间的网络中断,验证系统的容错和自动恢复能力。
2. 应用层故障注入
这是ChaosBlade的精华所在,它能够深入到应用内部,模拟微服务之间的调用问题。
- Java应用故障注入(通过Java Agent):
- 方法延迟:指定某个Java方法的执行延迟,模拟下游服务响应慢。
- 方法抛异常:让指定的方法调用时抛出异常,模拟下游服务错误。
- 返回值篡改:修改指定方法的返回值,模拟下游返回脏数据或异常数据。
- 自定义类加载:模拟类加载冲突或失败。
- HTTP故障:模拟HTTP请求的延迟、错误码返回等。
- JVM故障:模拟JVM的GC频繁、OutOfMemoryError等。
3. 云原生平台层故障注入
专门针对Kubernetes和Docker环境,是现代混沌工程的焦点。
- Pod故障:模拟Pod被杀、网络异常、文件系统异常。
blade create k8s pod-pod kill --names nginx-7df9d6ccb5-abcde- Node故障:模拟节点宕机、CPU/Mem压力、网络问题。
- 容器网络故障:模拟容器间的网络延迟、丢包,验证Service Mesh的弹性策略。
4. 中间件故障注入
针对常用中间件,模拟其不可用或异常。
- MySQL:模拟数据库连接池满、SQL执行慢、插入延迟等。
- Redis:模拟Redis连接失败、命令执行超时。
四、 核心优势与创新价值
- 声明式混沌实验:ChaosBlade支持通过YAML文件定义复杂的实验场景,从而可以实现实验的版本化管理、重复执行和CI/CD集成。这是将混沌工程从“手工作坊”推向“自动化工厂”的关键。
- 精细化的场景控制:与简单的
pkill或tc命令不同,ChaosBlade提供了极其精细的控制能力。例如,可以指定“只对A服务调用B服务的特定接口注入50%的延迟”,而不是对整个网络链路进行无差别攻击。 - 安全可控的爆炸半径:通过精确的目标选择(如Pod标签、节点名)和故障场景控制,可以将故障的影响范围限制在最小,遵循“在生产环境中谨慎地进行小规模实验”的原则。
- 强大的生态集成:ChaosBlade可以轻松与Argo、Jenkins等CI/CD工具集成,实现“混沌左移”,在部署前自动验证服务的韧性。它也与监控系统(如Prometheus、SkyWalking)天然互补,实验期间可观察系统的各项指标变化。
- 活跃的社区与丰富的场景:作为开源项目,ChaosBlade拥有活跃的社区,不断贡献新的故障场景和插件,紧跟技术发展趋势(如eBPF、WASM等)。
五、 典型应用场景
- 微服务韧性验证:在上线前,通过注入延迟和异常,验证服务的超时、熔断、降级、重试机制是否按预期工作。
- 容器化演练:在K8s集群中,定期执行“杀Pod”或“节点宕机”实验,验证部署的
liveness/readiness探针、HPA、集群调度等机制的有效性。 - 灾难恢复演练:模拟整个可用区故障(通过网络分区),验证系统的多活架构和异地容灾能力。
- 性能与稳定性摸底:通过注入资源压力,了解系统的容量边界和瓶颈所在,为容量规划提供数据支持。
- CI/CD流水线集成:在自动化流水线中增加一个“混沌测试阶段”,只有通过韧性验证的服务镜像才能被部署到生产环境,提升整体交付质量。
总结
阿里巴巴ChaosBlade不仅仅是一个技术工具,它代表了一种主动、前瞻性的工程文化。通过将混沌工程实践产品化、标准化和自动化,它极大地降低了实施混沌工程的门槛,使团队能够系统性地构建和验证分布式系统的韧性。在云原生架构日益复杂的未来,ChaosBlade这样的平台将成为确保系统高可用的必备基础设施。其价值在于,它将不可预知的“未知未知”风险,转化为可观察、可测量、可管理的“已知未知”问题,从而最终建立起能够抵御真实世界复杂性的反脆弱系统。
展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
53.0分项目
评分
同类平均分
综合
53
56
兼容性
46
54
稳定性
54
56
易用性
54
58
性能
46
54
市场占有率
60
62
功能
50
54
扩展性
56
56
美观度
56
58
技术服务
50
54
性价比
54
58
时间排序↓
最新
精华
3 条评论

向我咨询

发表评论