








LitmusChaos 是一个开源的云原生混沌工程平台,专为 Kubernetes 环境设计,旨在帮助开发者和系统可靠性工程师(SRE)通过主动注入故障来验证系统的容错性与韧性。以下是其核心介绍:

LitmusChaos
60.02条评价356次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
LitmusChaos是一个开源项目,其核心产品是Litmus混沌工程平台。近年来,其社区和商业化公司(ChaosNative)持续推动其演进,最新的重大发展是将其全面升级并更名为 Litmus 2.0,并进一步强化了其云原生混沌工程能力。
LitmusChaos 深度解析:云原生混沌工程的实践者与革新者
在Kubernetes和微服务架构成为企业标准的今天,系统的复杂性和动态性达到了前所未有的高度。确保这些分布式系统的韧性(Resilience)不再是可选项,而是生存的必需。混沌工程从Netflix的先锋实践,逐渐发展成为一门成熟的工程学科。而在云原生领域,LitmusChaos 凭借其原生为Kubernetes设计、开源开放的特性,迅速成长为这一领域的核心玩家。其最新版本(Litmus 2.0+)的演进,标志着它从一个混沌实验工具集,转变为一个完整的、可扩展的混沌工程平台。
一、 核心定位与设计哲学的演进
LitmusChaos的核心理念始终围绕 “Kubernetes原生” 和 “开源开放” 。其设计哲学体现在:
- 以Kubernetes的方式管理混沌:Litmus将混沌实验视为Kubernetes中的一等公民。实验本身被定义为自定义资源(CRD),如
ChaosEngine,ChaosExperiment和ChaosResult。这意味着你可以使用熟悉的kubectl命令来管理实验,并可以轻松地将混沌实验集成到GitOps工作流中。 - 声明式混沌实验:与命令式工具(通过CLI触发故障)不同,Litmus采用声明式API。用户通过YAML文件定义实验的期望状态(“我想要注入什么故障,在何处注入”),由Litmus控制器负责协调,使其达到该状态。这带来了版本控制、可重复性和审计追踪的巨大优势。
- 可扩展的架构:Litmus采用“混沌中心”的概念,其核心是一个框架,而具体的故障实验以“混沌实验图表”的形式存在,可以轻松地从社区获取或自行创建。这种插件化架构使其能够不断扩展,适应新的技术和场景。
- 关注应用韧性,而非仅仅基础设施:Litmus强调“应用感知的混沌” 。它不仅仅关心Pod是否被杀,更关心这个Pod被杀后,整个应用的SLA(如延迟、错误率)是否受到影响,以及应用的自我修复能力如何。
二、 Litmus 2.0+ 架构解析:迈向平台化
Litmus 2.0 的架构进行了重大重构,使其更清晰、更强大,主要分为三个核心组件:
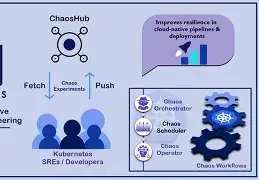
- LitmusChaos Control Plane (混沌控制平面):这是平台的大脑。它包含多个微服务,负责实验的调度、生命周期管理、事件处理和与外部系统的集成。它提供了一个现代化的用户界面(Web UI)和API,用于集中管理多个集群的混沌实验。
- LitmusChaos Execution Plane (混沌执行平面):这是平台的手脚。它由部署在目标集群(一个或多个)中的Litmus代理组成。代理负责接收来自控制平面的指令,在集群中实例化并执行具体的混沌实验。这种控制平面与执行平面分离的架构,使得Litmus可以轻松地实现多集群、多租户的混沌工程。
- ChaosHub (混沌中心):这是一个类似Helm Chart仓库的混沌实验图表仓库。它包含了大量预定义的、可复用的混沌实验,涵盖了Kubernetes平台、云提供商、中间件、应用层等各个层面。用户可以从ChaosHub中“安装”所需的实验图表,无需从零开始编写。
三、 核心功能模块与场景详解
Litmus的功能覆盖了从基础设施到应用的完整链条,并通过“混沌实验图表”的形式交付。
1. Kubernetes平台级故障注入
这是Litmus最核心和最成熟的能力。
- PodChaos:
- Pod故障:模拟Pod被意外删除(
pod-delete),验证Deployment的副本机制能否快速重建。 - Pod资源压力:模拟Pod的CPU或内存耗尽(
pod-cpu-hog,pod-memory-hog),验证资源的Limit和Request配置是否合理,以及HPA(水平Pod自动扩缩)是否生效。 - NodeChaos:
- 节点排水:安全地排空一个节点(
node-drain),验证工作负载能否被平滑地调度到其他可用节点。 - 节点故障:通过
node-reboot模拟节点重启,或通过资源压力模拟节点不可用,验证集群的自动恢复能力。 - NetworkChaos:通过Linux内核的
netem模块,在容器网络接口层面注入故障。 - 网络延迟:在微服务之间注入延迟,验证服务的超时和熔断机制。
- 网络丢包:模拟不稳定的网络,验证服务的重试逻辑。
- 网络分区:模拟整个可用区或集群内部的网络中断,验证多副本数据一致性策略和故障转移。
2. 云提供商与基础设施故障注入
通过与ChaosMesh等项目的集成或自有实验,支持对底层云基础设施的故障模拟。
- AWS:如EC2实例终止、EBS卷丢失、AWS节点CPU压力等。
- GCP:类似的虚拟机实例故障等。
3. 应用层与中间件故障注入
Litmus可以通过辅助Pod或Sidecar模式,深入到应用内部。
- JVM故障注入:通过集成JVM Chaos工具,可以模拟方法延迟、抛异常等Java应用级故障。
- 中间件故障:提供针对流行中间件(如Redis、MySQL、Kafka)的混沌实验,例如模拟Redis主节点宕机,验证哨兵或集群模式的切换能力。
4. 混沌工作流:构建复杂的实验场景
这是Litmus的高级功能,允许用户将多个简单的混沌实验组合成一个复杂的、有顺序的“混沌工作流”。
- 串行与并行执行:可以定义实验A执行后,再执行实验B,或者同时执行实验C和D。
- 流程控制与判断:在工作流中可加入“探针”,在注入后续故障前,先检查应用的健康状态。如果应用已经崩溃,则中止后续更破坏性的实验。
- 示例场景:一个工作流可以定义为:1) 先对某个微服务注入网络延迟 -> 2) 等待2分钟,观察监控指标 -> 3) 如果错误率未超过阈值,则杀死该微服务的一个Pod -> 4) 验证服务是否自动恢复。这种场景能更真实地模拟连环故障。
四、 与可观测性平台的深度集成
一个成功的混沌实验,一半在于“注入”,另一半在于“观察”。Litmus深知这一点,因此提供了强大的集成能力。
- 原生事件与监控:每个实验都会发出清晰的事件(Kubernetes Events)并生成详细的
ChaosResultCR,其中包含实验的通过/失败状态、持续时间等。 - 与Prometheus/Grafana集成:实验指标可以轻松导出到Prometheus,并在Grafana中构建专属的混沌实验仪表盘。
- 与Datadog、New Relic等商业APM集成:通过预定义的仪表板或webhook,可以将实验事件和结果实时推送到这些可观测性平台,在统一的界面中关联故障注入和业务指标变化。
五、 核心优势与价值总结
- 云原生原生:对Kubernetes生态的深度理解和集成,使其成为在K8s环境中实施混沌工程最自然的选择。
- GitOps友好:实验即代码,可以完美融入CI/CD流水线,实现自动化的混沌测试,践行“混沌左移”。
- 强大的社区与生态:作为CNCF沙箱项目,Litmus拥有活跃的社区,不断贡献新的实验图表和功能,保证了其持续生命力。
- 企业级平台能力:Litmus 2.0的多集群管理、基于角色的访问控制、审计日志等功能,使其能够满足大型企业的安全性和合规性要求。
六、 典型应用场景
- CI/CD流水线中的韧性验证:在镜像构建后、部署到生产环境前,在集成测试环境中自动运行一套快速的混沌实验(如杀Pod),确保新版本的基本韧性。
- 定期灾难恢复演练:在预生产环境中,每月或每季度执行一次复杂的多故障工作流,模拟整个可用区宕机,验证整个系统的容灾能力。
- 验证监控告警的有效性:通过注入已知会触发告警的故障,来验证监控系统的告警规则是否灵敏、准确,确保运维团队能及时响应真实的事故。
总结
LitmusChaos的最新版本,通过其声明式的API、控制平面与执行平面分离的架构、丰富的混沌实验图表库以及强大的混沌工作流功能,已经成功地从一款优秀的开源工具,演进为一个成熟、可靠的企业级混沌工程平台。它不仅仅是在“制造混乱”,而是在提供一套系统化的方法论和工具链,帮助工程团队主动发现、理解和加固系统的薄弱环节。对于任何严重依赖Kubernetes和微服务架构的组织而言,采用LitmusChaos来构建主动的韧性验证体系,不再是锦上添花,而是确保业务连续性和技术卓越的战略性投资。
展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
60.0分项目
评分
同类平均分
综合
60
56
兼容性
56
54
稳定性
60
56
易用性
64
58
性能
64
54
市场占有率
70
62
功能
60
54
扩展性
56
56
美观度
60
58
技术服务
50
54
性价比
60
58
时间排序↓
最新
精华
2 条评论

向我咨询

发表评论