








SeaTunnel是一个开源非常易用、多模态、超高性能的分布式数据集成平台,支持实时海量数据同步。 每天可稳定高效同步数百亿数据,已被近百家企业应用于生产。
SeaTunnel
0.01条评价430次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
在数据驱动的时代,企业面临的核心挑战之一是如何高效、可靠地将分散在异构数据源(如关系型数据库、大数据平台、数据仓库、消息队列、云存储等)中的海量数据进行集成、同步和转换。传统的数据集成工具往往面临性能瓶颈、功能单一、对复杂场景支持不足以及运维成本高昂等问题。SeaTunnel,作为一个高性能、分布式、可扩展的海量数据集成平台,正是为解决这些痛点而生。它旨在成为企业数据架构中承上启下的 “数据高速公路” ,实现数据从任何来源到任何目的地的无缝、高效流动。
一、 核心定位与设计理念:极简、高性能与全场景覆盖
SeaTunnel的设计理念围绕以下几个核心原则:
- 极简配置与开箱即用:采用配置驱动的模式,用户通过简单的配置文件(如SQL、YAML、JSON)即可定义复杂的数据同步任务,极大降低了开发运维门槛,实现了“脚本即任务”。它提供了丰富的连接器(Connector)插件,覆盖绝大多数主流数据源和目的地,无需编码即可快速上手。
- 极致性能与水平扩展:基于先进的分布式计算框架(支持Apache Spark、Apache Flink作为底层引擎),SeaTunnel能够将数据同步任务天然地并行化处理,轻松应对TB/PB级别的数据量。通过优化的读写算法和内存管理,其性能远超许多传统ETL工具。
- 全场景数据支持:不仅支持批处理(Batch)模式,更强大的是对实时流处理(Streaming) 的深度支持。能够实时捕获数据库的变更日志(CDC)、持续消费消息队列中的数据,实现准实时的数据同步与集成,满足现代业务对数据时效性的高要求。
- 强大的数据转换与容错能力:内置了丰富的数据转换功能(过滤、映射、聚合、关联等),并提供了强大的容错机制和精确一次(Exactly-Once)语义保证,确保数据同步过程的高可靠性和数据一致性。
二、 系统架构与核心组件
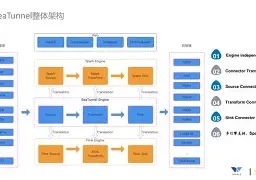
SeaTunnel采用模块化、插件化的架构,使其灵活且易于扩展:
- 连接器层(Connectors):这是SeaTunnel的核心优势所在。它提供了超过100种数据源和数据目的地的连接器插件,形成了一个庞大的生态系统。
- 输入源(Source):支持从MySQL、PostgreSQL、Oracle、MongoDB、Kafka、Pulsar、HDFS、S3、ClickHouse、Doris等读取数据。
- 输出源(Sink):支持将数据写入到上述所有数据源,以及Elasticsearch、Hive、StarRocks、数据湖等。
- CDC连接器:特别值得一提的是对Change Data Capture(CDC)的支持,如Debezium for MySQL/PostgreSQL,能够高效、低延迟地捕获数据库的插入、更新、删除操作。
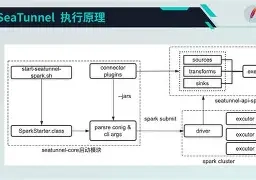
- 引擎层(Engines):SeaTunnel自身不直接处理计算,而是作为一个抽象层,将用户定义的同步任务翻译成底层计算引擎的执行计划。它主要支持:
- Apache Spark:适用于超大规模数据的批处理和高吞吐量的场景。
- Apache Flink:适用于要求低延迟、高可靠性的实时流处理场景,特别是CDC同步。
- SeaTunnel Engine(Zeta):SeaTunnel社区自研的轻量级引擎,旨在提供更简化的部署和运维体验。
- 翻译层(Translator):负责将用户提交的配置(如SQL)解析并转换成底层引擎(Spark/Flink)能够理解的任务DAG(有向无环图)。
- 管理控制台(Web UI):提供可视化的任务管理界面,方便用户进行任务配置、监控、调度和运维,降低了命令行操作的门槛。
三、 核心功能详解
1. 实时数据同步与CDC
- 场景:需要将业务库(如MySQL)的数据变更实时同步到数据仓库(如ClickHouse)或搜索索引(如Elasticsearch)中,以支持实时报表、实时推荐或实时大屏。
- 方案:使用SeaTunnel的Flink引擎,配置MySQL-CDC作为Source,ClickHouse作为Sink。SeaTunnel会实时监控MySQL的binlog,将增删改事件捕获并几乎实时地写入到ClickHouse,延迟可控制在秒级。
- 价值:替代了传统的定时批量抽取,实现了真正的实时数据流动,极大提升了数据分析的时效性。
2. 大规模数据迁移与备份
- 场景:需要将HDFS上的历史数据全量迁移到云上的对象存储(如AWS S3),或者将一个旧数据库的数据迁移到新数据库。
- 方案:使用SeaTunnel的Spark引擎,配置HDFS作为Source,S3作为Sink。利用Spark强大的分布式计算能力,可以高速、并行地完成TB级数据的迁移。
- 价值:高性能、高可靠性,简化了跨系统、跨云的数据迁移工作。
3. 数据清洗与转换
- 场景:从Kafka接入的原始日志数据包含大量噪声,需要进行清洗、过滤、格式转换后才能存入数据湖进行分析。
- 方案:在SeaTunnel的配置文件中,除了定义Kafka(Source)和数据湖(Sink),还可以在中间定义一系列Transform操作,如使用SQL语句进行数据过滤、字段拆分、脏数据剔除等。
- 价值:将ETL(抽取、转换、加载)流程一体化,无需编写复杂的Spark或Flink代码,通过配置即可完成。
4. 多源异构数据汇聚
- 场景:需要将来自不同业务系统(MySQL、Kafka、API)的数据汇聚到同一个数据目标(如数据仓库),进行关联分析。
- 方案:SeaTunnel支持在一个任务中配置多个Source,并可能进行数据关联(Join)后,再写入同一个Sink。这简化了复杂数据集成管道的构建。
- 价值:提供了强大的数据集成能力,是构建数据中台、数据仓库的核心工具。
四、 技术特点与核心优势
- 插件化架构:所有连接器和部分核心功能都以插件形式存在,易于社区贡献和自定义开发,生态活跃。
- 强大的社区支持:作为Apache软件基金会的孵化器项目,拥有活跃的开源社区,迭代速度快,文档和案例丰富。
- 对云原生的友好支持:可以轻松部署在Kubernetes环境中,实现弹性伸缩和高效的资源利用。
- 低代码/无代码:通过配置化和SQL支持,显著降低了数据开发工程师和数据分析师的使用门槛。
五、 典型应用场景
- 实时数仓与数据湖构建:将OLTP数据库的数据实时同步到数据仓库(如StarRocks、Doris)或数据湖(如Iceberg、Hudi),构建实时数据分析能力。
- 数据库容灾与多活:实现跨数据中心、跨云的数据库实时双向同步。
- 微服务数据汇聚:将各个微服务产生的数据(通过Kafka等)实时汇聚到统一的数据平台。
- 搜索索引实时更新:将业务数据变更实时同步到Elasticsearch或OpenSearch,保证搜索结果的及时性。
总结
SeaTunnel通过其卓越的性能、丰富的连接器生态、对实时流处理的深度支持以及极简的配置化体验,已经成为现代数据栈中数据集成领域的一颗耀眼新星。它有效地解决了数据孤岛问题,为企业提供了构建实时、高效、可靠数据管道的有力工具。对于追求数据时效性、正在建设数据中台或进行数字化转型的企业而言,SeaTunnel提供了一个比许多商业软件更灵活、更强大且成本更优的选择。它不仅是数据的“搬运工”,更是企业数据价值释放的“加速器”。
展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
74.0分项目
评分
同类平均分
综合
74
60
兼容性
80
64
稳定性
80
64
易用性
80
60
性能
80
62
市场占有率
60
58
功能
70
64
扩展性
80
58
美观度
80
58
技术服务
60
56
性价比
70
52
时间排序↓
最新
精华
1 条评论
评 价 12
支 持 0
关 注 0
被关注 0
访 客 0


使用经验:12个月
.png)
1、易用性好:通过配置文件即可定义数据同步任务
2、连接器丰富
3、部署简单:单节点通过docker-compose,安装非常容易
.png)
1、对于复杂场景、海量数据处理存在性能瓶颈

1、适合数据量不大的中小型公司
2、不适合大型公司或海量数据场景


回复
2026-09-24

向我咨询

发表评论