








- 定位:开源流处理计算框架的绝对领导者。虽然它本身更偏向于“流处理引擎”而非完整的“数据库”,但其在流计算领域的地位如同Linux在操作系统领域,是许多商业流数据库和流处理服务的底层基石。
- 特点:高吞吐、低延迟、精确一次的状态一致性、强大的状态管理能力。它提供了复杂的流式API(DataStream)和关系型API(Table API/SQL)。
- 商业支持:由Ververica(被阿里巴巴收购)提供核心商业支持,其创始人也是Flink的创始人。
Ververica Platform
0.01条评价368次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
一、核心理念与定位:有状态的流处理
Flink 的诞生源于一种前瞻性的技术理念:批处理是流处理的特例。与传统先收集数据再成批处理(批处理)的模式不同,Flink 将一切数据视为无界的数据流,并在此基础上实现了有状态的、精确一次的流式计算。
- 流处理优先:数据一旦产生就立即处理,实现毫秒级到秒级的低延迟分析。
- 有状态计算:这是 Flink 的灵魂。它能够在内存或外部存储中维护计算过程中的“状态”(例如,过去一小时内的用户点击次数、一个会话窗口内的所有事件)。这使得 Flink 能够进行复杂的窗口聚合、模式检测和事件驱动的应用开发,而不仅仅是简单的无状态过滤或转换。
- 精确一次的状态一致性:即使在发生节点故障时,Flink 也能确保其内部状态和输出结果不丢不重,这对于金融交易、实时计费等关键业务场景至关重要。
因此,Flink 的定位是一个强大、灵活且可靠的数据处理核心引擎,用于构建和管理数据密集型、有状态的应用程序。
二、核心架构与关键组件
Flink 的架构设计确保了其高吞吐、低延迟和容错能力。
- 分层 API:提供不同层次的抽象,以适应不同开发需求。
- SQL & Table API:最高层的抽象,使用标准的 SQL 或类 SQL 的 Table API 进行流处理和批处理。这对于数据分析师和习惯声明式编程的开发者非常友好。
- DataStream / DataSet API:核心 API,为 Java 和 Scala 开发者提供对数据流(无界)和数据集(有界)的精细控制能力。开发者可以自定义复杂的处理逻辑和状态操作。
- ProcessFunction:最底层的 API,提供对时间、状态和生命周期的细粒度控制,用于实现最复杂的业务逻辑。
- 状态管理:
- 状态类型:支持 Keyed State(与数据流的键绑定)和 Operator State(与算子实例绑定)。
- 状态后端:Flink 允许将状态存储在内存、RocksDB(本地磁盘)或外部文件系统(如 HDFS)中,在性能和状态大小之间提供灵活性。
- 检查点和恢复:通过分布式快照算法(借鉴了 Chandy-Lamport 算法)定期对应用状态做检查点。故障发生时,系统自动从最近一个一致性检查点恢复,实现容错。
- 时间语义与窗口:
- 事件时间:使用数据自身携带的时间戳进行处理,能正确处理乱序事件,得到准确的计算结果。
- 处理时间:使用处理机器的系统时间,延迟最低,但无法处理乱序。
- 丰富的窗口:支持滚动窗口、滑动窗口、会话窗口等,满足各种时间范围内的聚合需求。
- 部署模式:
- 独立集群:在自有硬件或虚拟机集群上部署。
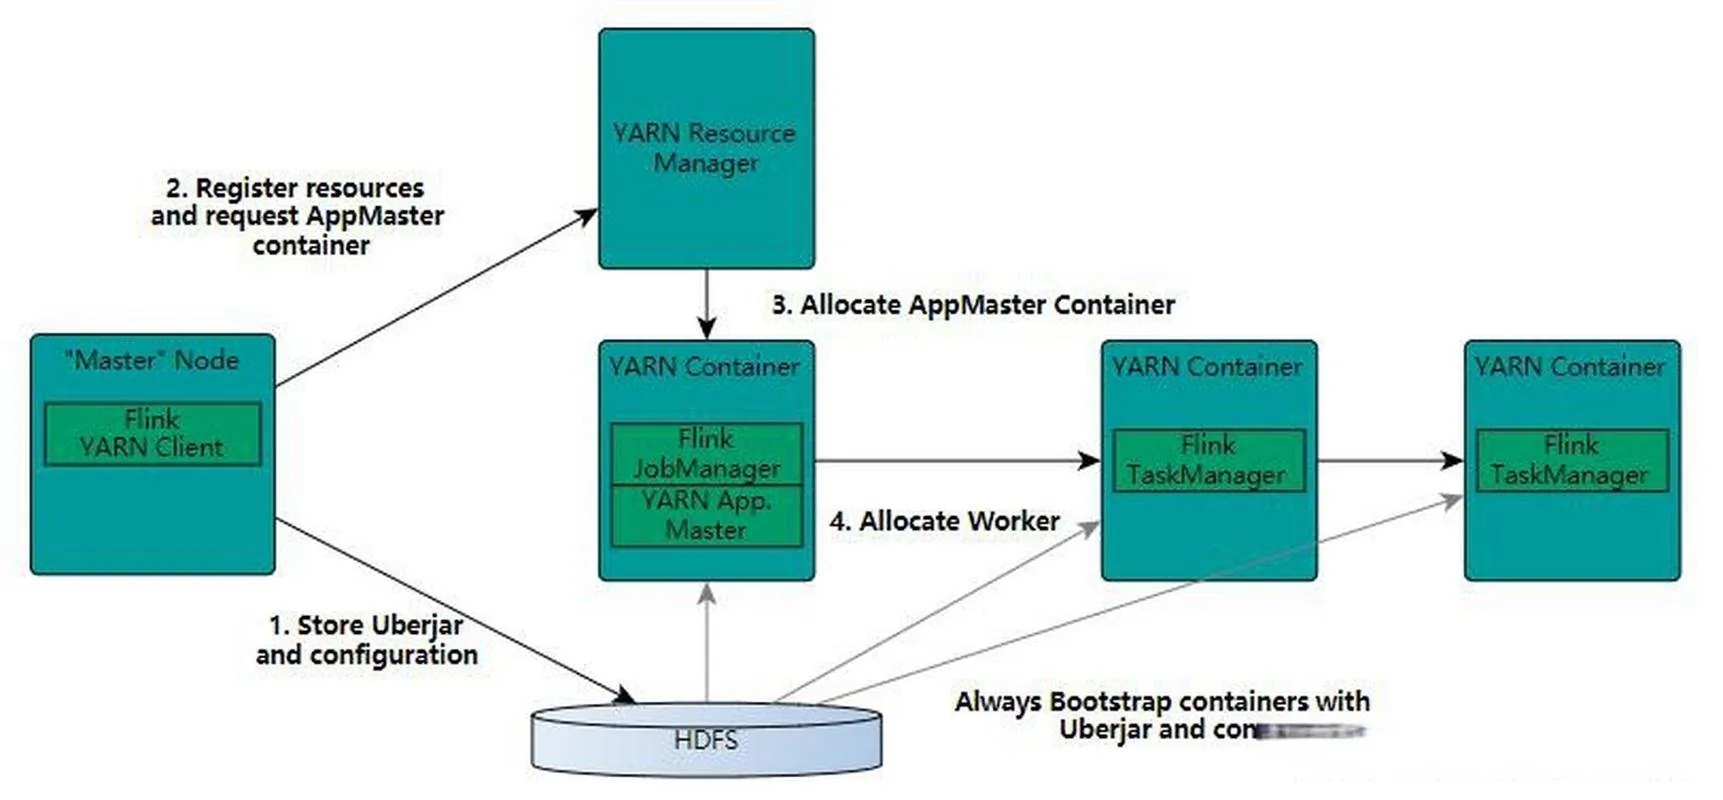
- YARN / Kubernetes:作为资源管理框架上的应用运行,实现资源动态分配。
- 云托管服务:如 Ververica Platform(由 Flink 创始公司提供)、Amazon Kinesis Data Analytics for Apache Flink 等,提供全托管体验。
三、主要产品形态:开源核心与商业发行版
- Apache Flink(开源社区版)
- 这是核心和基础,包含了所有核心功能。用户可以直接从社区获取、部署和维护。
- Ververica Platform(原 Data Artisans)
- 由 Flink 的创始公司 Ververica(现为阿里巴巴旗下)提供,是 Flink 最权威的商业发行版。
- 它在开源核心之上增加了企业级功能,如:SQL 编辑器、作业管理控制台、自动化部署、监控告警、版本控制、自动化故障恢复等,极大地简化了 Flink 在生产环境中的运维和管理。
- 云厂商的托管服务
- AWS Kinesis Data Analytics for Apache Flink:全托管服务,无需管理集群。
- Google Cloud Dataflow:基于 Apache Beam API,但底层执行引擎与 Flink 技术同源。
- 这些服务降低了使用门槛,但可能在功能和版本更新上有所滞后。
四、典型应用场景
- 事件驱动型应用:
- 实时推荐系统:根据用户实时行为(点击、浏览)立即更新推荐结果。
- 实时风控与异常检测:实时分析交易流,检测欺诈模式并触发警报或拦截。
- 网络监控:实时分析网络流量,检测异常模式或安全威胁。
- 实时数据管道与 ETL:
- 持续清洗、丰富和转换数据流,并将其导入到数据仓库(如 Apache Doris, ClickHouse)、搜索引擎或其它存储系统中。
- 实时分析与报表:
- 为运营仪表盘提供实时指标,如实时营业额、在线用户数、物联网设备状态监控等。
五、总结:优势与挑战
优势:
- 技术领先性:在流处理领域,尤其在状态管理和时间处理方面,是事实上的技术标准。
- 高吞吐与低延迟:能够处理海量数据的同时保持极低的处理延迟。
- 精确一次保证:提供强大的容错能力,确保计算结果准确无误。
- 丰富的生态系统:与 Kafka、Hadoop、HBase 等大数据组件无缝集成。
挑战:
- 学习曲线陡峭:相比于简单的 SQL 工具,理解和掌握 Flink 的编程模型和状态管理需要较高的学习成本。
- 运维复杂度高:在生产环境中稳定运行和调优 Flink 集群需要专业的知识和经验(这也是商业发行版的价值所在)。
总而言之,Apache Flink 是一个强大而专业的流处理计算框架。它不适合简单的数据查询任务,而是为需要处理无限数据流、并维护复杂状态的实时数据应用提供了一个坚实的技术基础。在选择 Flink 时,应明确其定位是作为应用开发的“引擎”,而非开箱即用的“数据库”或“分析工具”。

展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
70.0分项目
评分
同类平均分
综合
70
78
兼容性
80
84
稳定性
70
80
易用性
60
74
性能
60
76
市场占有率
70
80
功能
60
74
扩展性
80
80
美观度
70
76
技术服务
70
76
性价比
80
84
时间排序↓
最新
精华
1 条评论

向我咨询

发表评论