第一章:核心定位与设计哲学——为流式世界而生的数据库
ksqlDB 并不是一个传统的、面向静态数据的关系型数据库。它的核心定位是 一个专为流处理构建的、轻量级的、基于SQL的流数据库。要理解 ksqlDB,必须首先理解其诞生的背景和要解决的根本问题。
1.1 诞生背景:Apache Kafka 的生态演进
Apache Kafka 已成为现代数据架构的“中枢神经系统”,负责处理海量的实时数据流。然而,早期与 Kafka 交互主要依赖于复杂的编程 API(如 Kafka Streams、Spark Streaming),需要 Java/Scala 开发者编写大量代码。这造成了很高的技术门槛,使得业务分析师、数据工程师等不熟悉编程的群体难以直接利用实时数据流。
ksqlDB 的出现,旨在 将流处理的能力民主化。其核心设计哲学是:能否像操作传统数据库一样,使用简单的 SQL 来查询、转换和持续处理无界的数据流?
1.2 核心理念:流即表,表即流
ksqlDB 建立在 Apache Kafka 和 Kafka Streams 之上,并引入了两个关键的关系型抽象:
- 流:代表一系列无界的、结构化的实时事件。例如,
clicks流记录了用户点击事件的连续历史。流是 不可变 的,只能插入新事件。 - 表:代表流在某个时间点的 状态 或 物化视图。例如,从
clicks流中按用户分组计算出的点击次数,就构成了一个 user_click_counts表。表是 可变的,会随着底层流的数据到来而持续更新。
基于这种抽象,ksqlDB 允许用户:
- 对流进行连续查询:创建一个
SELECT ... FROM stream ...查询,它会持续运行,每当新数据到达流中,就输出新的结果。 - 创建物化视图:通过
CREATE TABLE AS SELECT ...语句,将聚合、JOIN 等操作的结果作为一个持续更新的表物化下来,供其他查询快速读取。
总结而言,ksqlDB 的本质是一个建立在 Kafka 流之上的、持续更新的物化视图引擎。
第二章:系统架构与核心组件
ksqlDB 采用客户端-服务器架构,其核心组件如下图所示(图示关系如下):
+----------------+     +-------------+     +-------------------+
|   Kafka集群    | <-> | ksqlDB 服务器 | <-> | ksqlDB CLI / 应用 |
| (数据源与状态存储) |     |  (处理引擎)   |     |    (客户端接口)    |
+----------------+     +-------------+     +-------------------+
2.1 ksqlDB 服务器
这是执行所有计算的核心引擎。一个 ksqlDB 集群可以包含多个服务器节点以实现高可用和横向扩展。服务器的主要职责包括:
- 解析与规划:接收客户端提交的 SQL 语句,进行语法解析并生成执行计划。
- 流处理执行:执行计划被转换为底层的 Kafka Streams 拓扑,执行持续查询、聚合、JOIN 等操作。
- 状态管理:所有的计算状态(如聚合的中间结果)都作为容错的、压缩的 Kafka Topic 持久化存储。这使得 ksqlDB 服务器本身可以是无状态的,故障恢复时只需从 Kafka 中重建状态即可。
- REST API:提供 RESTful 接口,供客户端提交查询、拉取数据和管理集群。
2.2 Kafka 集群:唯一的真相之源
Kafka 在 ksqlDB 架构中扮演两个至关重要的角色:
- 数据源:所有被 ksqlDB 处理的原始流数据都来自 Kafka Topic。
- 状态存储:所有 ksqlDB 创建的物化视图(表)和中间状态,都作为内部的 Kafka Topic 进行持久化。这使得 ksqlDB 具有容错性和可恢复性。任何服务器节点故障后,新节点都可以从 Kafka 中重新加载状态并继续处理。
2.3 客户端
- 交互式 CLI:一个命令行界面,用于交互式地探索数据、执行查询和进行管理操作。
- Java 客户端:允许 Java 应用程序通过编程方式与 ksqlDB 服务器交互,将实时数据流集成到应用中。
- REST API 客户端:任何能发送 HTTP 请求的工具或语言都可以与 ksqlDB 交互。
第三章:核心功能与特性深度解析
3.1 流处理能力
- 数据过滤与投影:使用
SELECT ... WHERE ...语句对数据流进行简单的清洗和转换。 - 窗口化聚合:支持跳跃窗口、滑动窗口和会话窗口,可计算如“每分钟的订单总额”、“过去5分钟内的独立用户数”等指标。
- 流-表 JOIN:这是 ksqlDB 最强大的功能之一。允许一个实时事件流与一个静态的(或缓慢变化的)参考表进行关联。例如,将
订单流与 用户信息表JOIN,实时丰富订单数据。 - 流-流 JOIN:连接两个实时数据流,用于检测复杂的事件模式,例如将“用户登录流”和“用户购买流”关联,分析登录后立即购买的行为。
3.2 事件时间处理与乱序处理
ksqlDB 支持基于事件本身携带的时间戳(事件时间)进行处理,而不仅仅是处理到达服务器的时间(处理时间)。这对于处理网络延迟导致的乱序事件至关重要,能够保证计算结果的准确性。
3.3 可扩展性
通过增加 ksqlDB 服务器节点,可以水平扩展处理能力。其扩展性直接依赖于 Kafka 的分区机制。一个查询的处理任务会分布到多个节点上,每个节点处理原始 Kafka Topic 的一个子集(分区)。
3.4 恰好一次语义
通过继承 Kafka 和 Kafka Streams 的恰好一次语义,ksqlDB 能够确保在出现故障时,每条数据只被处理一次,避免重复计算,对于金融交易等关键场景必不可少。
第四章:主要应用场景
4.1 实时ETL与数据管道
简化数据从原始格式到目标格式的实时转换和丰富过程。例如,从 JSON 格式的日志流中提取特定字段,转换为 Avro 格式并写入另一个 Kafka Topic。
4.2 实时监控与异常检测
持续监控数据流,在异常发生时立即告警。例如,监控服务器指标流,在 CPU 使用率超过阈值时触发警报;监控金融交易流,实时检测欺诈模式。
4.3 实时仪表盘与业务分析
为运营仪表盘提供低延迟的数据支撑。物化视图可以持续计算关键业务指标(如实时销售额、在线用户数),前端应用只需简单地查询这个物化视图即可获得最新结果。
4.4 事件驱动型应用
作为微服务架构中的实时数据后端。例如,一个应用可以订阅 ksqlDB 物化出的 当前库存表,来实时响应前端的查询请求。
第五章:优势与局限性
5.1 核心优势
- 极低的入门门槛:使用熟悉的 SQL,大大降低了流处理的学习和开发成本。
- 与 Kafka 生态无缝集成:对于已经使用 Kafka 作为数据管道的企业,ksqlDB 是自然延伸,无需引入复杂的新技术栈。
- 运维简单:服务器无状态,所有持久化依赖 Kafka,简化了集群运维。
- 快速原型开发:能够以极快的速度验证和交付实时数据处理逻辑。
5.2 主要局限性
- 功能深度限制:虽然 SQL 易用,但其表达能力不如完整的编程框架(如 Apache Flink 的 DataStream API)。对于极其复杂的自定义状态处理或迭代计算,ksqlDB 可能力不从心。
- 对 Kafka 的强依赖:ksqlDB 完全构建在 Kafka 之上,如果企业没有 Kafka 基础架构,引入 ksqlDB 的成本会很高。
- 性能考量:对于超大规模、超低延迟的复杂计算场景,专门的流处理框架可能在性能调优方面有更大空间。
第六章:与相关技术对比
- ksqlDB vs. Apache Flink:
- Flink:是一个功能更全面、更底层的流处理计算框架。它提供更强的编程能力和灵活性,适合构建复杂、高性能的流处理应用,但学习曲线陡峭。
- ksqlDB:是构建在 Kafka Streams(可视为一个轻量级库)之上的流数据库。它通过 SQL 抽象简化了常见流处理任务,更适合快速实现标准化的实时查询和物化视图。
- 类比:Flink 像是给了你一套强大的“机床和原材料”,可以制造任何零件;而 ksqlDB 像是给了你一个“标准化零件目录”,你可以快速找到并组装需要的零件,但定制能力有限。
- ksqlDB vs. 传统数据库:
- 传统数据库(如 PostgreSQL)主要针对存储在磁盘上的静态数据进行“一次性查询”。
- ksqlDB 针对动态数据流进行“持续查询”,结果随时间推移不断更新。
总结
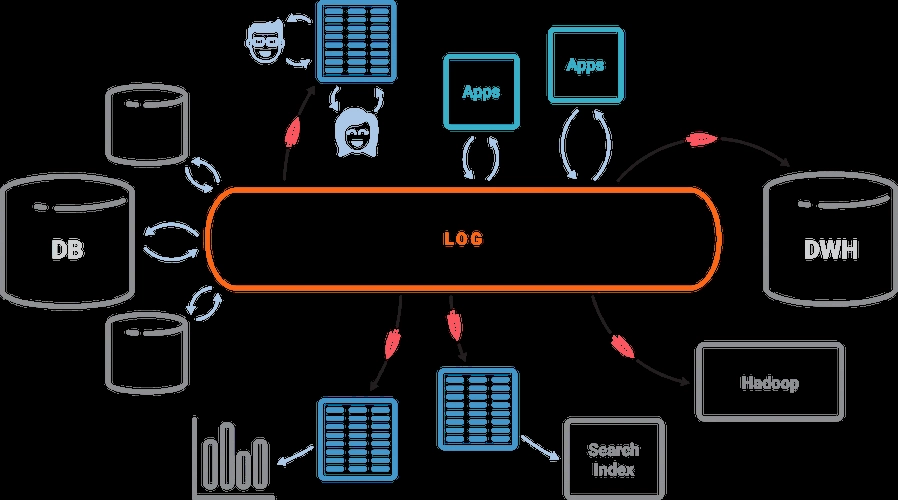
ksqlDB 是一个开创性的产品,它成功地将熟悉的 SQL 语言引入了实时流处理领域,极大地降低了开发门槛。它的核心价值在于将 Kafka 数据流“数据库化”,让用户能够以声明式的方式定义和物化实时业务逻辑。
它最适合的场景是已经深度使用 Kafka 的企业,需要快速构建实时数据管道、监控系统和轻量级事件驱动应用。对于追求极致灵活性和复杂计算能力的场景,更底层的流处理框架可能是更好的选择。但无论如何,ksqlDB 在推动流处理技术普及方面,扮演了不可或缺的角色。