








DataPipeline(北京数见科技有限公司)是一家专注于企业级实时数据融合服务的科技公司,成立于2016年。公司总部位于北京。
DataPipeline
0.00条评价435次浏览
所属厂商:
交付方式:
定价方式:
适用客户规模(/人):
价格区间:
公司介绍:
产品详情
第一章:产品核心理念与市场定位:企业级实时数据枢纽
DataPipeline 是一家专注于企业级数据融合领域的国内软件厂商,其核心产品即名为 DataPipeline。这个名字清晰地传达了其产品愿景:成为企业内负责数据流动的“数据管道”。
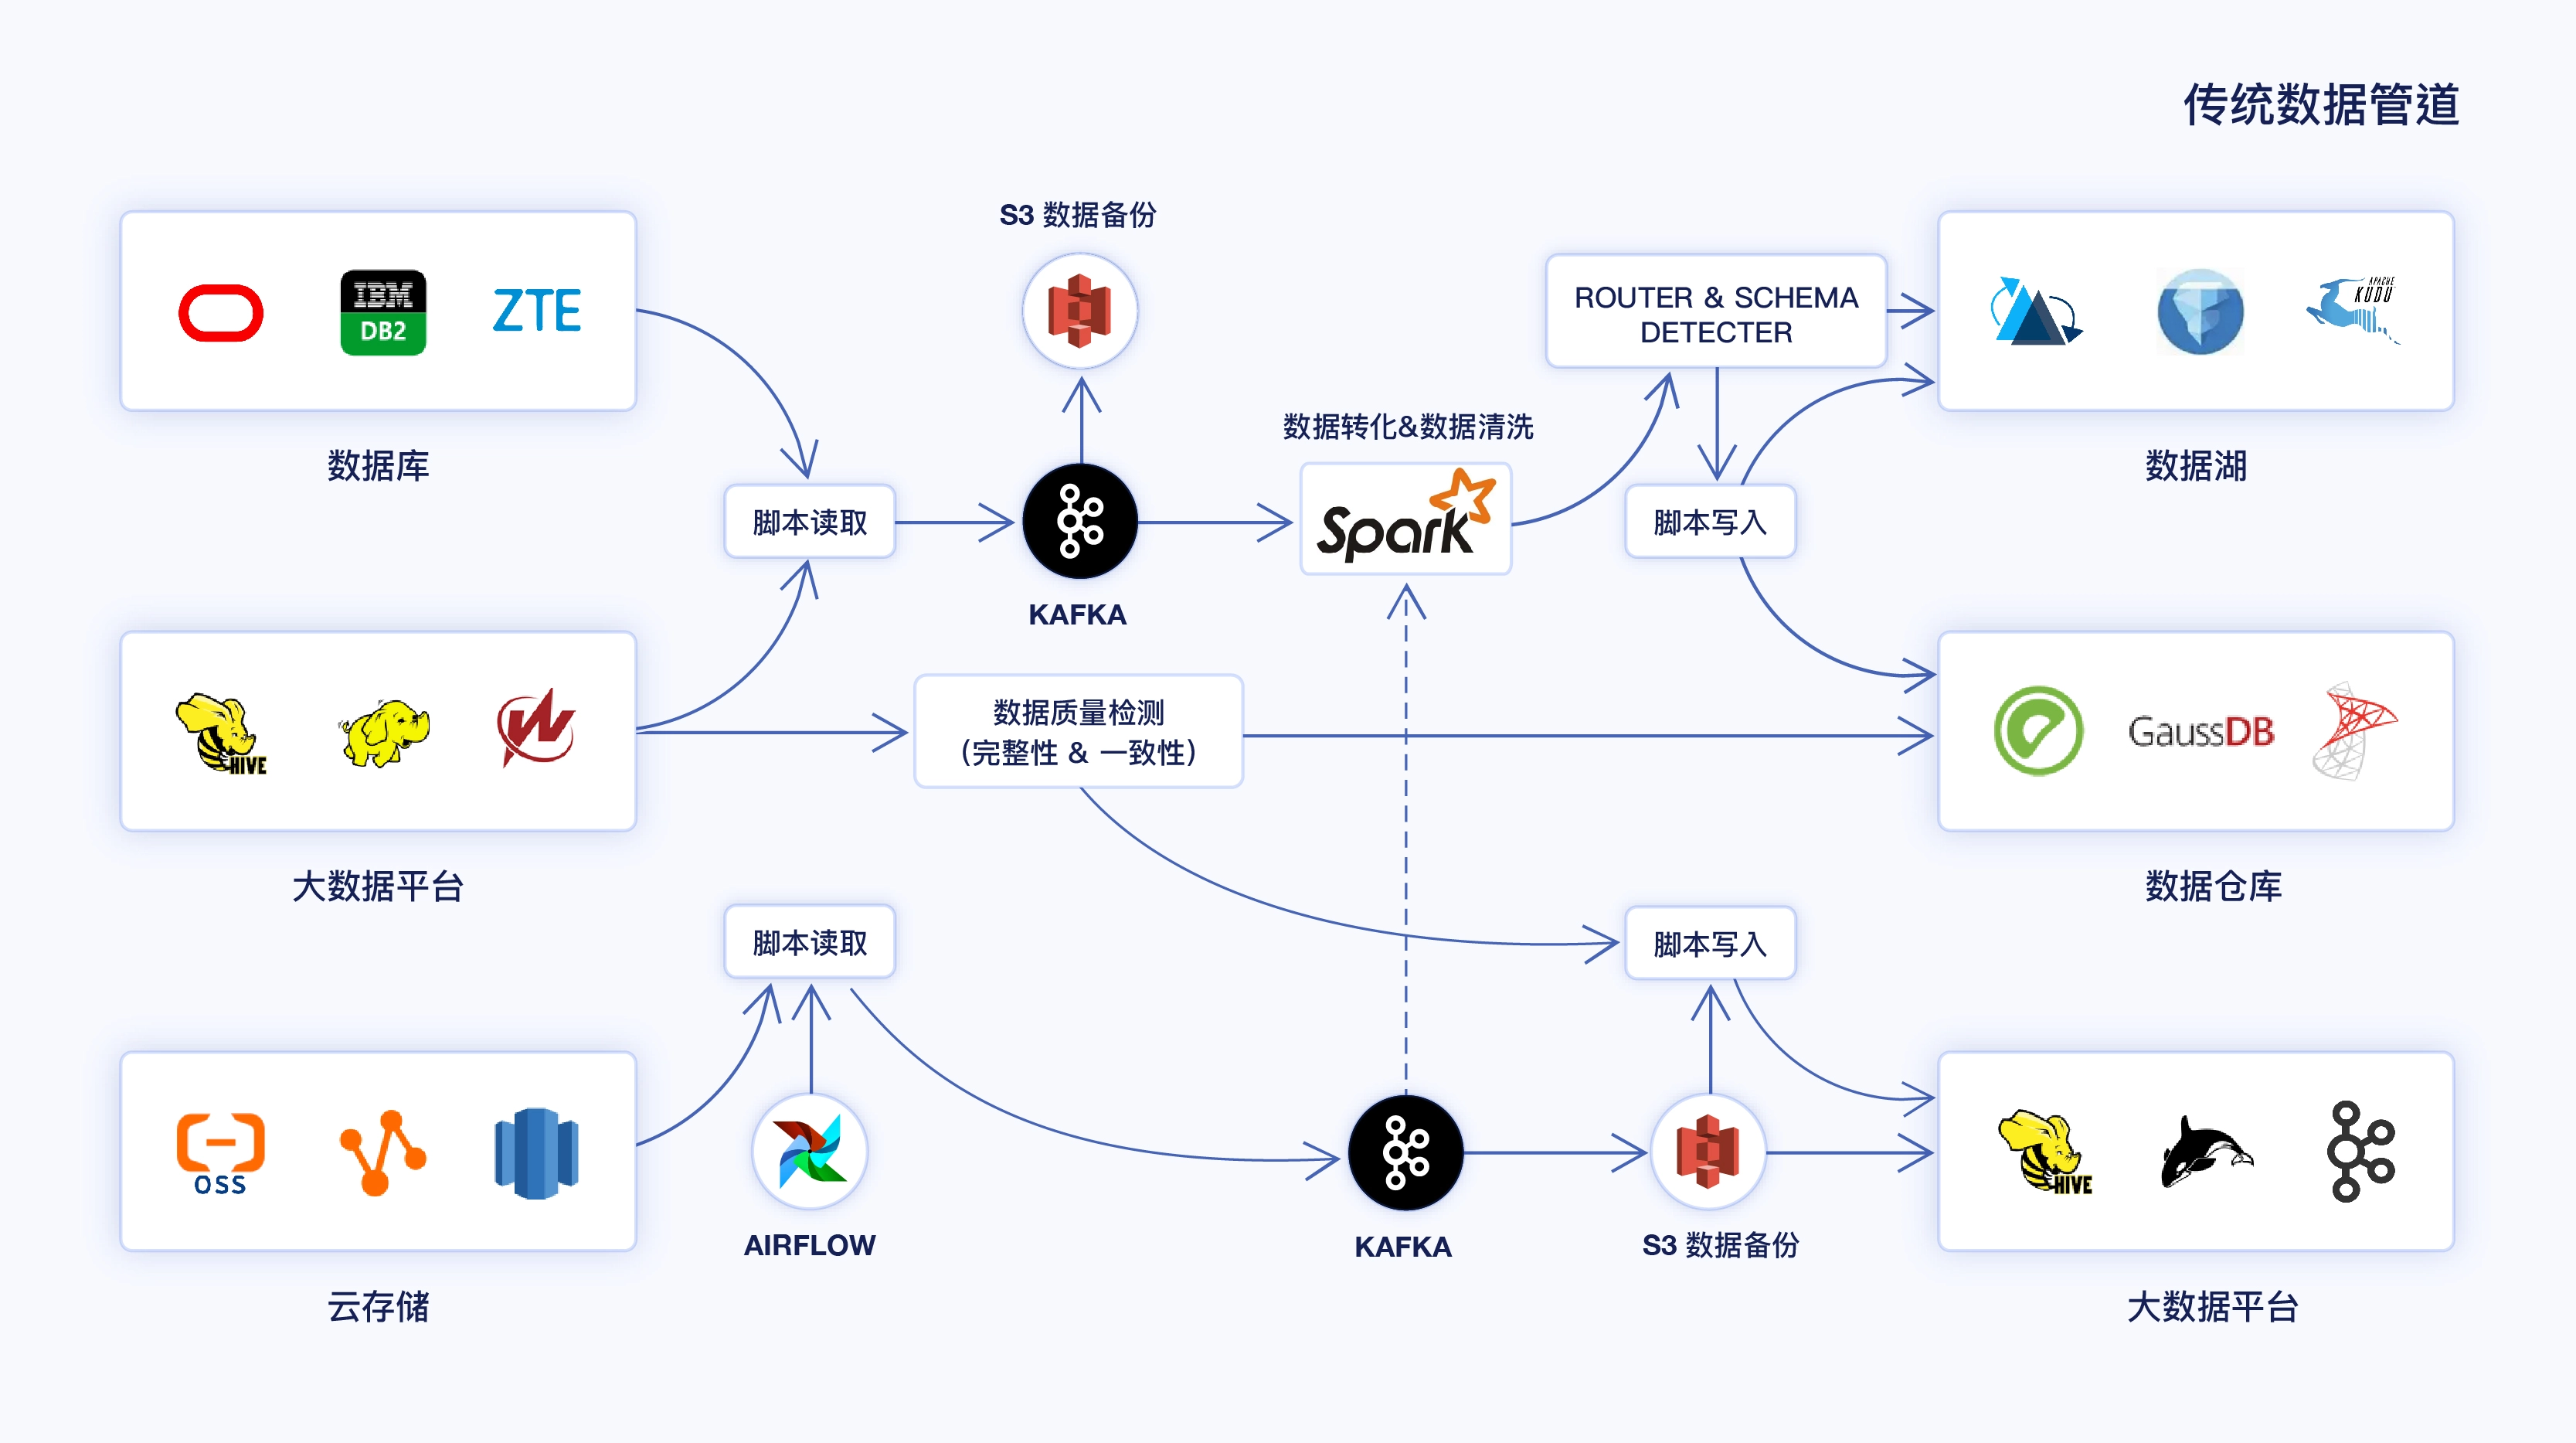
与传统的ETL工具不同,DataPipeline从诞生之初就深刻洞察了现代企业的数据需求变化:数据量爆发式增长、数据源极度多样化、以及对数据时效性的要求从“天级别”提升到“分钟级甚至秒级”。因此,它的设计理念聚焦于:
- 实时性为先: 将变更数据捕获(CDC) 和实时数据同步作为产品的核心能力,确保业务数据能够持续不断地流向需要它的地方。
- 云原生与弹性扩展: 采用分布式架构,支持在云环境中灵活部署和弹性伸缩,以应对海量数据流动的挑战。
- 低侵入与易运维: 强调对源系统(特别是生产数据库)的低性能影响,并提供完善的可视化监控管理界面,降低运维成本。
- 连接与融合: 致力于连接各种异构数据源,不仅仅是数据库,还包括大数据平台、SaaS应用、API等,实现数据的自由流动。
市场定位:
- 企业级实时数据集成的专家: 专注于解决中大型企业面临的实时数据集成难题,特别是在数据仓库实时化、微服务数据同步、业务系统解耦等场景。
- 传统ETL工具的现代化替代者: 为那些受困于传统ETL工具(如DataStage、Informatica)高成本、高复杂度、批处理延迟的企业,提供一个更轻量、更敏捷、更现代的选项。
- 国产化替代的选择之一: 作为国内自主研发的产品,在信创背景下,成为许多寻求国产软件替代的企业的考虑对象。
第二章:核心架构与技术特性
DataPipeline的先进性源于其为“实时数据流动”而设计的现代化技术架构。
1. 分布式与高可用架构
- 集群化部署: DataPipeline核心组件支持集群部署,无单点故障。管理节点、工作节点均可水平扩展,确保服务的高可用性。
- 负载均衡: 数据同步任务可以分布在多个工作节点上执行,实现负载均衡,提升整体数据处理吞吐量。
- 故障自动恢复: 当某个节点发生故障时,任务会自动切换到健康的节点上继续运行,保障数据同步任务不中断。
2. 基于日志的增量数据捕获(CDC)
这是DataPipeline实现实时同步且低影响的关键技术。
- 原理: 通过解析数据库的二进制日志(如MySQL的binlog、Oracle的redo log、PostgreSQL的WAL)来捕获数据的插入、更新、删除操作。
- 优势:
- 高性能低延迟: 几乎是实时捕获数据变更,延迟可控制在毫秒级别。
- 低源端压力: 与通过轮询数据库或使用触发器的方式相比,基于日志的CDC对源数据库的性能影响极小。
- 高保真度: 能准确捕获每一次数据变更,避免数据丢失。
3. 低代码可视化操作
- 可视化配置界面: 提供友好的Web UI,用户通过拖拽方式配置数据源、选择同步表、进行简单的字段映射,无需编写代码即可完成大多数数据同步任务的配置。
- 任务流设计: 可以设计包含多个步骤的数据管道,清晰展示数据流向。
4. 丰富的连接器生态
DataPipeline内置了广泛的数据源连接器,支持与各类系统对接:
- 数据库: MySQL、Oracle、SQL Server、PostgreSQL、DB2等关系型数据库,以及MongoDB等NoSQL数据库。
- 大数据平台: Apache Kafka、HDFS、Hive、HBase、ClickHouse、StarRocks等。
- 消息队列与云服务: 支持与各类消息中间件及云存储服务集成。
- 国产数据库: 对达梦、人大金仓等国产数据库有较好的支持,适应信创需求。
第三章:核心功能模块详解
1. 数据源管理
- 集中管理所有需要连接的数据源信息,支持连接测试和权限控制。
- 支持不同网络环境(如公有云、私有云、本地数据中心)下的数据源接入。
2. 数据任务配置与管理
- 任务创建: 通过向导式界面,选择源端和目标端,选择同步模式(全量、增量、全量+增量)。
- 字段映射与转换: 提供可视化的字段映射关系配置。支持简单的数据转换规则,如类型转换、空值处理、字段脱敏等。对于复杂逻辑,可能支持自定义脚本或SQL。
- 任务调度: 支持灵活的任务调度策略,如一次性执行、周期调度(支持cron表达式)、实时持续运行。
3. 实时监控与告警
- 运维监控大屏: 直观展示所有数据管道的运行状态(正常、异常、延迟)、数据流量、同步速度等核心指标。
- 详细日志查询: 提供任务级别的详细运行日志,便于在出现问题时快速定位和排查。
- 多方式告警: 支持通过邮件、短信、钉钉、企业微信等方式发送告警信息,可设置延迟告警、错误率告警等规则。
4. 数据管理与治理功能
- 数据血缘: 自动分析和展示数据从何而来,经过哪些处理,最终流向何处,助力数据治理和影响分析。
- 任务依赖管理: 支持设置任务间的依赖关系,形成有向无环图的工作流,确保任务按正确顺序执行。
第五章:典型应用场景
- 实时数据仓库与数据中台: 将业务库(如订单、用户数据)的变更实时同步到数据仓库(如ClickHouse, StarRocks)或数据湖,为实时BI、精准营销提供支撑。
- 数据库同步与容灾: 实现同构或异构数据库之间的实时数据同步,用于读写分离、报表库分离、异地容灾等。
- 微服务数据解耦: 在微服务架构中,作为可靠的数据管道,将某个服务的数据库变更异步同步给其他服务,避免直接调用数据库,保持服务间的松耦合。
- 系统迁移与升级: 在系统更换(如Oracle迁MySQL)或升级时,实现数据的平滑、实时迁移和切换。
- 数据应用供给: 将处理好的数据实时推送给前端应用,如实时大屏、推荐系统等。
点击链接,了解更多产品:
登录后查看
展开更多
案例介绍
暂无内容
版权/专利
暂无内容
评价

"客观"-"真实"-"中立"-"专业"点评,每项不少于20字,总字数不少于90字,帮助更多迷茫的IT人。点评完即可现金抽奖,满5个送笔记本/平板活动支架;10个送扫地机器人;20个送VIP视频会员。
评分标准及明细
0-20分
很糟糕功能/性能/服务等基本无法使用
20-40分
较差功能/性能/服务等存在较多问题
40-60分
一般行业同类平均水平,凑活够用
60-80分
还不错行业上游水平,能满足大部分使用需求
80-100分
优秀行业领先水平,只有20%左右评比对象满足这个标准
总评分
0.0分项目
评分
同类平均分
综合
0
40
兼容性
0
40
稳定性
0
40
易用性
0
38
性能
0
40
市场占有率
0
38
功能
0
40
扩展性
0
42
美观度
0
38
技术服务
0
38
性价比
0
40
时间排序↓
最新
精华
0 条评论

向我咨询

发表评论