线程池这个标题,平常写业务时似乎没什么存在感,很多代码里顺手就是一个:- ExecutorService executor = Executors.newFixedThreadPool(10);
但假如口试官问一句:你们项目里的线程池是怎么用的?怎么管理的?
这时间假如只答复一句“用 Executors.newFixedThreadPool()”,根本就比力伤害了。由于生产环境里,线程池不是简朴创建几个线程来跑任务,而是要控制资源、控制队列、控制拒绝计谋,还要能监控 和调解。
本文内容:
- 为什么不发起直接使用 Executors
- 常见内置线程池到底有什么标题
- ThreadPoolExecutor 的几个焦点参数怎么明白
- 生产环境里线程池一样平常怎么创建
- 项目中怎样同一管理和监控线程池
为什么不发起直接使用 Executors
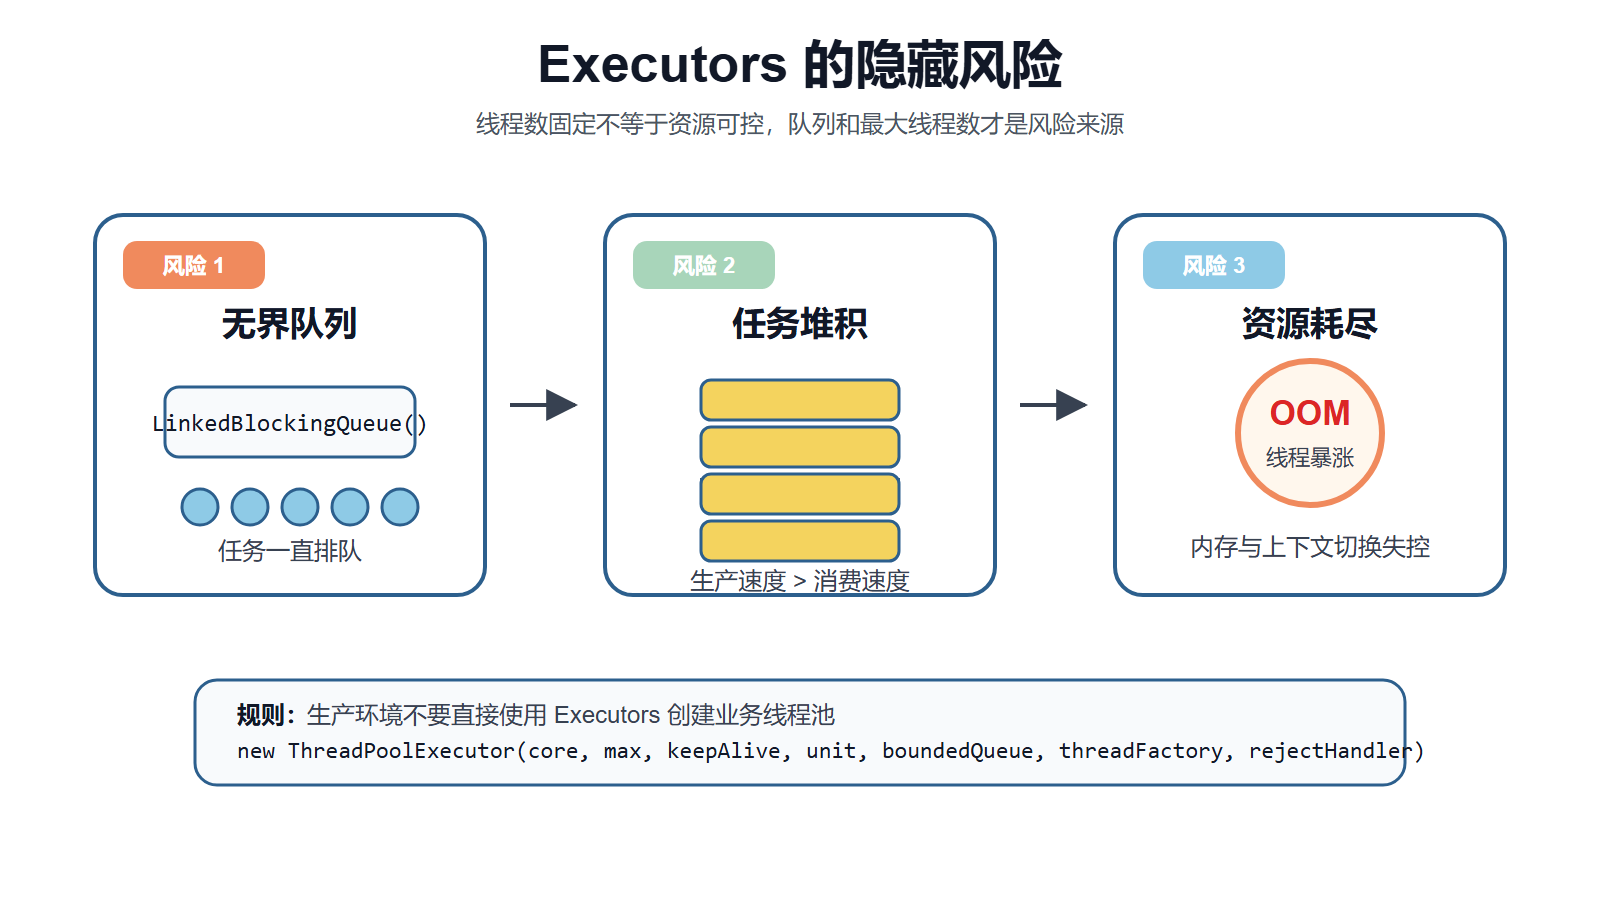
先用一张图把 Executors 的标题放到一起看:它的风险并不但是“线程池怎么创建”,而是默认参数把很多边界隐蔽掉了。
图里最须要关注的是两个边界:队列有没有上限,线程数有没有上限。这两个边界假如没有控制住,任务高峰期就很轻易从“异步处理惩罚”酿成“异步堆积”。
《阿里巴巴 Java 开发手册》中有一条比力常见的规范:
线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 的方式创建。
这句话很多人都背过,但不愿定真正明白它的标题在那里。
我们先看一个最常见的 FixedThreadPool:- ExecutorService executor = Executors.newFixedThreadPool(10);
但标题不在线程数,而在队列。
newFixedThreadPool 的源码如下:- public static ExecutorService newFixedThreadPool(int nThreads) {
- return new ThreadPoolExecutor(nThreads, nThreads,
- 0L, TimeUnit.MILLISECONDS,
- new LinkedBlockingQueue<Runnable>());
- }
- new LinkedBlockingQueue<Runnable>()
假如线程池里有 10 个线程,某一段时间内任务突然变多,那么前 10 个任务会被线程实行,反面的任务就会不绝进入队列。由于队列险些没有上限,以是线程池不会拒绝任务,任务只会越堆越多。
假如任务生产速率不绝大于消耗速率,末了占用的就是堆内存,严肃时就会导致 OOM。
以是 FixedThreadPool 最大的标题不是“线程数固定”,而是“队列没限定”。
这也是为什么生产环境里一样平常要求使用 ThreadPoolExecutor 显式创建线程池,把焦点线程数、最大线程数、队列巨细、线程工厂、拒绝计谋都写清楚。
几种内置线程池的标题
Executors 里提供了几种常见线程池:
- FixedThreadPool
- SingleThreadExecutor
- CachedThreadPool
- ScheduledThreadPool
它们不是完全不能用,而是不恰当在生产代码里不加控制地直接用。我们分别来看一下。
FixedThreadPool
前面已经看过它的源码:- public static ExecutorService newFixedThreadPool(int nThreads) {
- return new ThreadPoolExecutor(nThreads, nThreads,
- 0L, TimeUnit.MILLISECONDS,
- new LinkedBlockingQueue<Runnable>());
- }
- 焦点线程数即是最大线程数
- 线程数固定
- 使用无界 LinkedBlockingQueue
由于队列是无界的,以是当焦点线程都在忙时,后续任务只会不绝列队,不会触发扩容,也不轻易触发拒绝计谋。
很多人以为固定线程池比力稳,着实它只是把压力藏到了队列里。队列没满之前,体系看起来都还正常;比及内存撑不住时,标题就已经比力严肃了。
SingleThreadExecutor
SingleThreadExecutor 的源码也很雷同:- public static ExecutorService newSingleThreadExecutor() { return new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>());}
假如只是少量配景任务,标题不显着。但假如任务提交速率很快,而这个单线程消耗不外来,任务照旧会不绝堆到无界队列里。
以是它的标题和 FixedThreadPool 一样,只是更埋伏,由于各人看到“单线程”时,会以为它更可控。
实际上线程数是可控了,队列照旧不可控。
CachedThreadPool
再看 CachedThreadPool:- public static ExecutorService newCachedThreadPool() {
- return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
- 60L, TimeUnit.SECONDS,
- new SynchronousQueue<Runnable>());
- }
- 焦点线程数为 0
- 最大线程数是 Integer.MAX_VALUE
- 使用 SynchronousQueue
- 空闲线程 60 秒后接纳
SynchronousQueue 比力特殊,它不存任务。提交任务时,必须立刻有线程吸收;假如没有空闲线程,就会创建新线程。
这就带来一个标题:假如任务提交很快,任务实行又比力慢,线程池就会不绝创建新线程。
线程并不是免费的。线程多了以后,会带来线程栈内存占用,也会带来大量上下文切换。严肃时 CPU 会被切换斲丧拖住,内存也大概被打满。
以是 CachedThreadPool 的风险不在队列,而在线程数险些没有上限。
ScheduledThreadPool
ScheduledThreadPool 一样平常用来实行耽误任务大概周期任务。
它底层使用的是耽误队列,队列自己也没有一个业务意义上的容量限定。假如定时任务提交过多,大概任务实行时间高出了调理周期,也会出现任务堆积。
比如一个任务每 1 秒调理一次,但每次实行须要 5 秒,假如没有控制好,就轻易产生积存。
以是定时任务线程池也不能只关注线程数,还要关注任务是否堆积、任务实行耗时是否高出周期。
ThreadPoolExecutor 的几个焦点参数
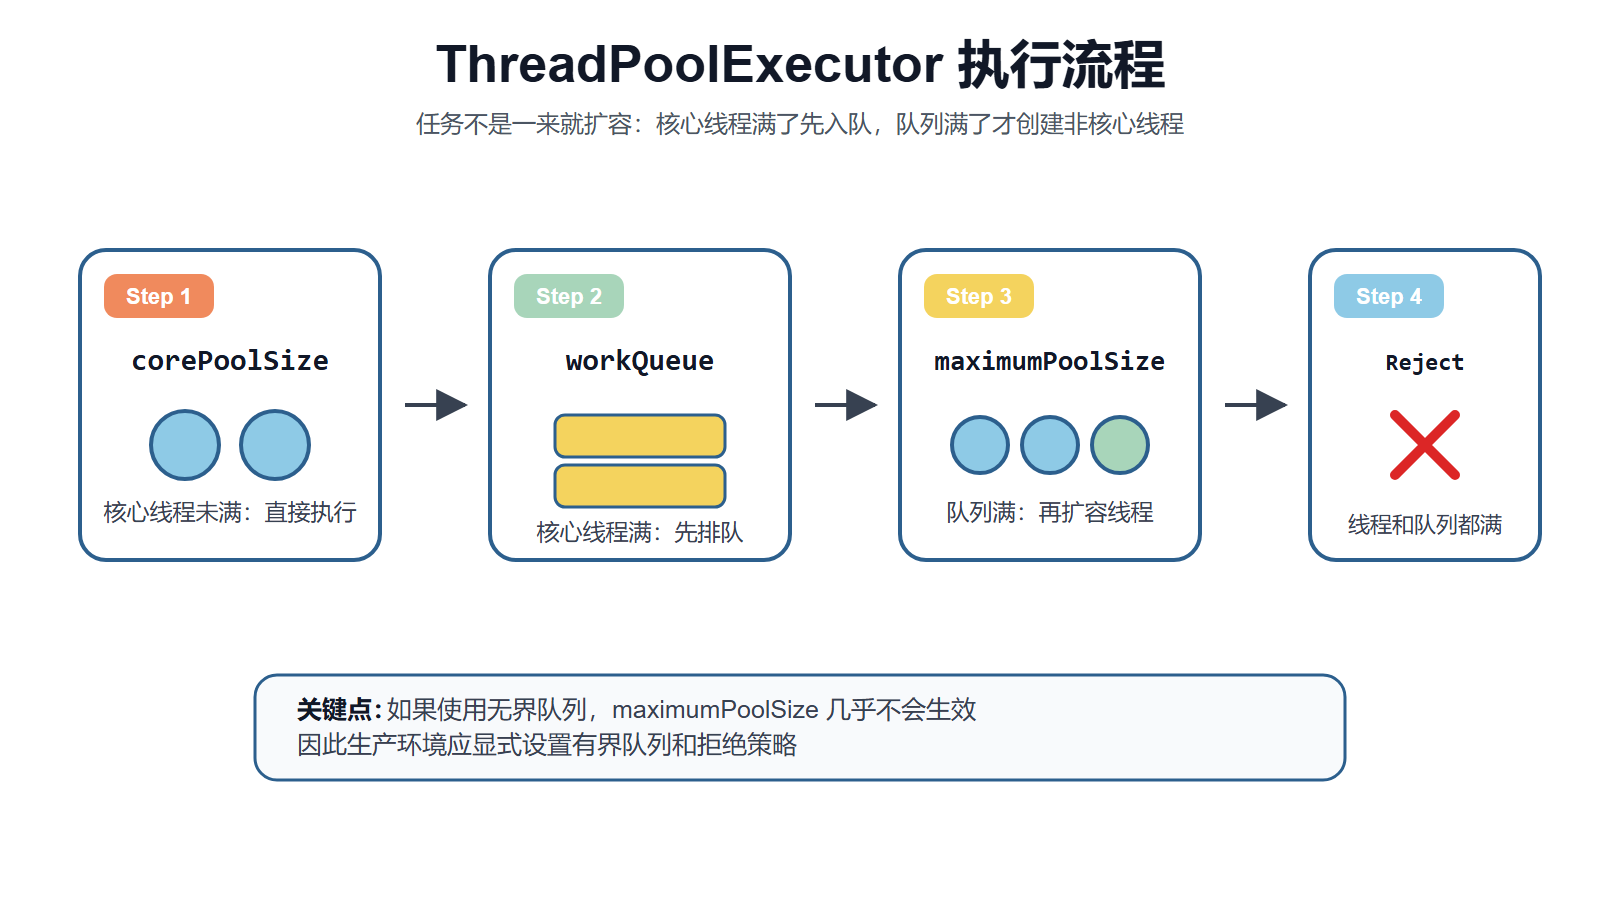
明白 ThreadPoolExecutor 的参数之前,最好先把任务提交后的实行次序搞清楚。很多线程池标题,都是由于误以为“最大线程数会立刻见效”。
这张图的关键点是:焦点线程满了以后,任务会先辈入队列;只有队列也满了,才会继承创建非焦点线程。以是队列范例和队列容量,会直接影响 maximumPoolSize 是否有时机发挥作用。
既然不发起直接使用 Executors,那我们就要自己创建 ThreadPoolExecutor。
它常用的构造方法如下:- public ThreadPoolExecutor(int corePoolSize,
- int maximumPoolSize,
- long keepAliveTime,
- TimeUnit unit,
- BlockingQueue<Runnable> workQueue,
- ThreadFactory threadFactory,
- RejectedExecutionHandler handler);
corePoolSize
corePoolSize 体现焦点线程数。
当任务提交到线程池时,假如当火线程数还没有到达 corePoolSize,线程池会创建新线程来实行任务。
假如当火线程数已经到达 corePoolSize,任务就会进入队列等候。
以是焦点线程数太小,任务轻易列队;焦点线程数太大,又会造成线程资源浪费,乃至带来更多上下文切换。
一样平常会根据任务范例来估算一个初始值。
假如是 CPU 麋集型任务,比如盘算、加密、压缩等,线程数通常可以设置为:假如是 IO 麋集型任务,比如访问数据库、Redis、RPC 接口、文件、网络等,线程常常处于等候状态,线程数可以恰当多一些。
常见估算公式是:- 线程数 = CPU 核心数 * (1 + IO 耗时 / CPU 耗时)
maximumPoolSize
maximumPoolSize 体现线程池允许创建的最大线程数。
它不是一开始就见效的。线程池只有在下面几个条件都满足时,才会继承创建非焦点线程:
- 焦点线程已经满了
- 队列也满了
- 当火线程数还小于 maximumPoolSize
这里有一个很轻易被忽略的点:假如使用的是无界队列,那么 maximumPoolSize 根本就没什么时机见效。
由于焦点线程满了之后,任务会不绝进入队列,而队列又险些不会满,以是线程数最多也就到 corePoolSize。
这也是为什么我们不发起用无界队列。无界队列不但大概导致 OOM,还会让最大线程数这个参数失去意义。
keepAliveTime
keepAliveTime 控制的好坏焦点线程的空闲存活时间。
当线程池里的线程数高出 corePoolSize 后,多出来的线程就好坏焦点线程。假如这些线程空闲时间高出了 keepAliveTime,就会被接纳。
默认环境下,焦点线程不会由于空闲而接纳。
假如盼望焦点线程也能超时接纳,可以如许设置:- threadPoolExecutor.allowCoreThreadTimeOut(true);
假如某个线程池使用频率很高,焦点线程频仍创建和烧毁反而会增长开销。假如是低频任务,大概任务颠簸比力大,可以思量让焦点线程也支持超时接纳。
workQueue
队列是线程池里非常关键的一个参数。
它决定了任务来了以后,是先列队,照旧扩容线程,照旧直打仗发拒绝计谋。
生产环境里,最紧张的一点是:队列最好有容量限定。
ArrayBlockingQueue
ArrayBlockingQueue 是基于数组实现的有界队列,创建时必须指定容量:- new ArrayBlockingQueue<>(1000)
缺点是生产者和消耗者共用一把锁,在并发非常高时吞吐一样平常,但很多业务场景下已经够用了。
LinkedBlockingQueue
LinkedBlockingQueue 是基于链表实现的壅闭队列。
它有两种写法:- new LinkedBlockingQueue<Runnable>()new LinkedBlockingQueue(1000)
第二种指定容量后,是可以使用的。
以是标题不在 LinkedBlockingQueue 这个类自己,而在于很多人用了默认构造方法,导致队列酿成了无界队列。
SynchronousQueue
SynchronousQueue 不存储任务,它更像是任务的直接交代。
提交任务时,假如有空闲线程吸收,就交给线程实行;假如没有空闲线程,就看线程池是否还能创建新线程;假如不能创建,就触发拒绝计谋。
它恰当任务实行时间较短、盼望任务不要在队列里堆积的场景。
但使用它时肯定要控制好 maximumPoolSize,否则就大概酿成线程数暴涨。
ThreadFactory
线程工厂常常被忽略,但线上排查标题时它很紧张。
比如我们可以给线程设置业务名称:- public class NamedThreadFactory implements ThreadFactory {
- private final AtomicInteger count = new AtomicInteger();
- private final String name;
- public NamedThreadFactory(String name) {
- this.name = name;
- }
- @Override
- public Thread newThread(Runnable r) {
- Thread thread = new Thread(r);
- thread.setName(name + "-" + count.getAndIncrement());
- thread.setDaemon(false);
- return thread;
- }
- }
假如线程名都是默认的 pool-1-thread-1,排查起来就很难过。
RejectedExecutionHandler
当线程池到达最大线程数,而且队列也满了,再提交任务就会触发拒绝计谋。
JDK 默认提供了几种计谋:
计谋分析AbortPolicy直接抛出 RejectedExecutionExceptionDiscardPolicy直接抛弃任务,不抛非常DiscardOldestPolicy抛弃队列中最早的任务,然后重新提交当前任务CallerRunsPolicy由提交任务的线程自己实行任务这几个计谋没有绝对优劣,要看业务能不能继承任务丢失、能不能继承调用方被壅闭。
假如任务不能丢,通常不能直接用 DiscardPolicy。
假如盼望标题尽快袒露,可以使用 AbortPolicy,但调用方要处理惩罚好非常。
假如使用 CallerRunsPolicy,任务不会被丢,但提交任务的线程会被拖住。比如一个 HTTP 哀求线程提交异步任务,效果线程池满了,这个异步任务就由哀求线程自己实行。假如任务很慢,就会拖慢主链路,严肃时还大概把 Tomcat 线程池也拖住。
以是拒绝计谋最少要做两件事:
- 记载日志
- 打监控或报警
任务被拒绝分析线程池已经饱和了,这不是平凡非常,而是体系处理惩罚本领不敷的信号。
线程池参数怎么定
线程池参数没有一个通用答案。
比犹如样是 8 核呆板,一个线程池是做当地盘算,另一个线程池是调用卑鄙接口,这两个线程池的参数就不应该一样。
通常可以先按下面这个思绪来定初始值:
- 先区分任务范例,是 CPU 麋集型照旧 IO 麋集型
- 估算单个任务耗时,以及任务中等候 IO 的比例
- 根据呆板资源给一个初始线程数
- 队列肯定要有容量限定
- 拒绝计谋要连合业务语义选择
- 上线后通过监控观察,再调解参数
比如一个调用外部接口的异步任务,耗时重要在网络等候上,可以恰当把线程数调大一些;但假如任务里有大量盘算,就不能盲目加线程,由于线程太多反而会让 CPU 花更多时间做上下文切换。
别的还要注意一点:队列容量不是越大越好。
队列大,只是能放更多任务,不代表处理惩罚本领变强。假如队列不绝在涨,本质上分析消耗本领已经跟不上了。队列越大,任务等候时间大概越长,用户感知到的耽误也大概越显着。
以是线程池要看的不是“能不能放得下”,而是“能不能及时处理惩罚完”。
项目里一样平常怎么封装线程池
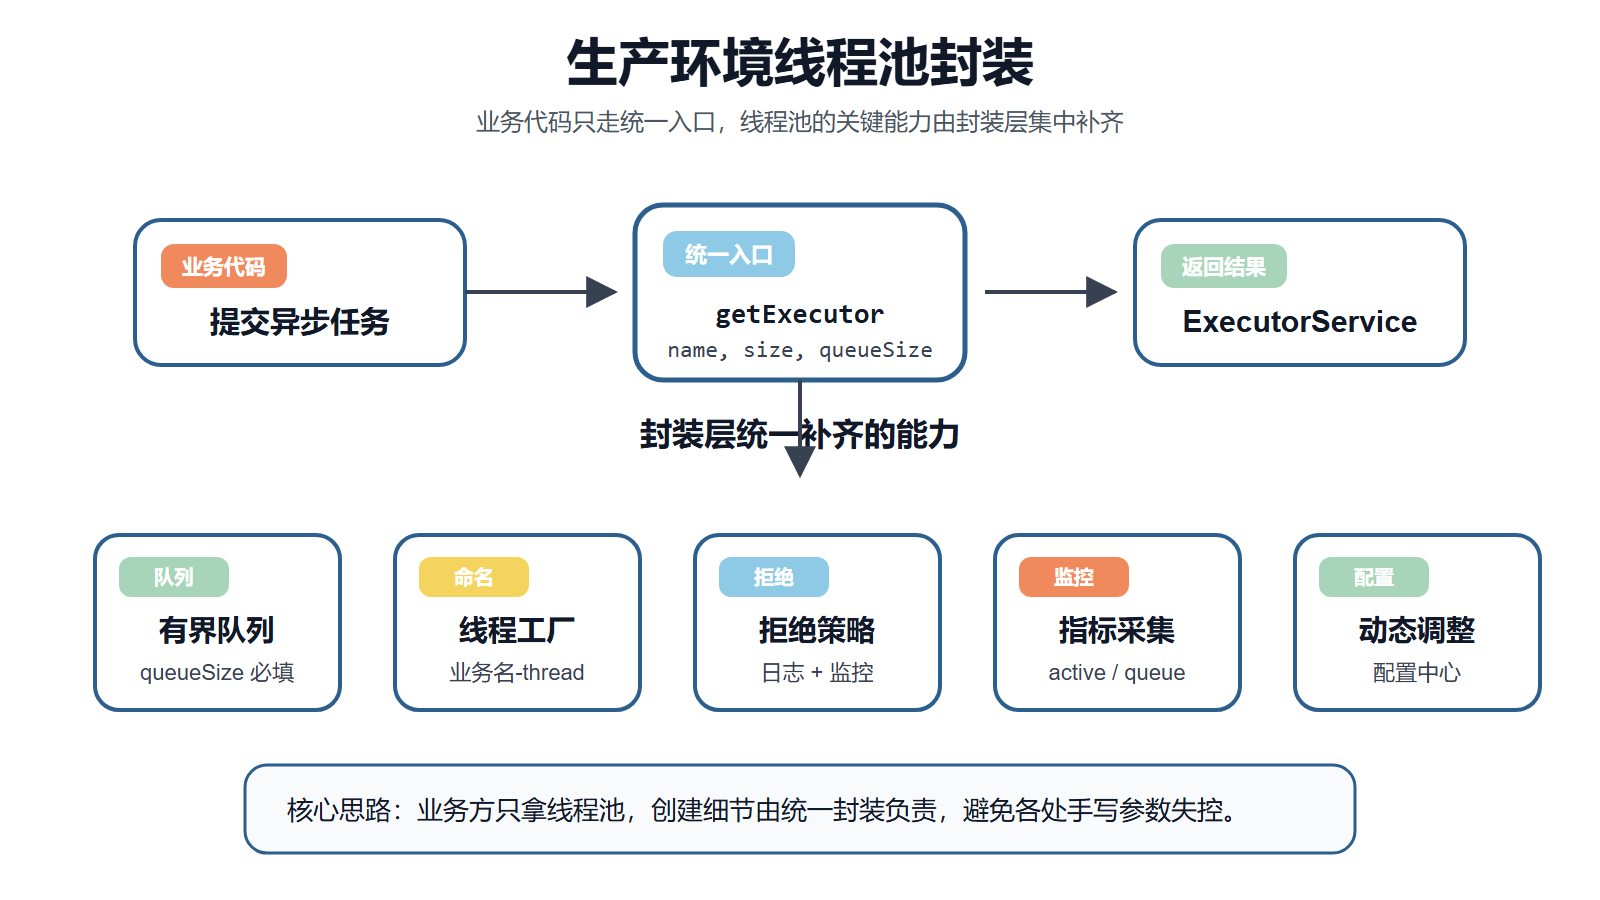
参数明白清楚以后,落到项目里还要办理另一个标题:不能让每个业务方都按自己的风俗创建线程池。否则线程名、队列容量、拒绝计谋和监控方式都会变得差别一。
比力稳妥的做法是提供同一入口,让业务只关心线程池名称和须要参数,底层同一补齐有界队列、定名线程工厂、拒绝计谋、监控收罗和动态设置。
在项目中,最好不要让业务代码到处自己 new ThreadPoolExecutor。
由于每个人写法不一样,有的人不设置线程名,有的人用无界队列,有的人没有拒绝计谋,有的人没有监控。末了项目里线程池越来越多,出了标题也欠好查。
比力常见的做法是封装一个同一的工具类大概组件,业务方通过同一入口创建线程池。
比如我们可以提供一个方法:- DynamicExecutorHelper.getExecutor(name, size, queueSize)
- 线程池名字由业务传入
- 队列容量必须显式传入
- 线程工厂同一设置线程名
- 拒绝计谋同一打日志和监控
- 定时收罗线程池指标
- 支持从设置中央动态调解线程数
- 包装任务,通报 MDC 或 trace 上下文
下面看一个简化后的实现思绪。
同一创建线程池
焦点创建逻辑可以写成如许:- public static ExecutorService getExecutor(String name, int size, int queueSize) {
- ExecutorWrapper executorWrapper = executorWrapperCache.getIfPresent(name);
- if (executorWrapper == null) {
- synchronized (DynamicExecutorHelper.class) {
- executorWrapper = executorWrapperCache.getIfPresent(name);
- if (executorWrapper == null) {
- ensureMonitorInitialized();
- ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(
- size,
- size,
- 1,
- TimeUnit.MINUTES,
- queueSize <= 0 ? new SynchronousQueue<>() : new LinkedBlockingDeque<>(queueSize),
- new NamedThreadFactory(name),
- new ExecutorRejectedExecutionHandler(name)
- );
- executorWrapper = new ExecutorWrapper(name, threadPoolExecutor);
- executorWrapperCache.put(name, executorWrapper);
- rejectCounters.put(name, new AtomicInteger(0));
- }
- }
- }
- return executorWrapper.getWrapperExecutorService();
- }
缩容时,先调小 corePoolSize,再调小 maximumPoolSize。
否则大概会由于 maximumPoolSize 小于 corePoolSize 而抛非常。
任务包装和链路上下文
线程池另有一个常见标题:跨线程后日志上下文丢失。
比如主线程里有 traceId,放在 MDC 里。任务提交到线程池后,实行任务的是另一个线程,MDC 默认不会自动传已往。
这时可以在提交任务时包一层:- queueSize <= 0 ? new SynchronousQueue<>() : new LinkedBlockingDeque<>(queueSize)
第一,在任务提交时生存当火线程的 MDC:- private static void recordMetrics(String name, ThreadPoolExecutor threadPoolExecutor) {
- SMonitor.recordOne("dynamic_executor_core_" + name + "_" + threadPoolExecutor.getCorePoolSize());
- SMonitor.recordOne("dynamic_executor_max_" + name + "_" + threadPoolExecutor.getMaximumPoolSize());
- SMonitor.recordOne("dynamic_executor_active_" + name + "_" + threadPoolExecutor.getActiveCount());
- SMonitor.recordOne("dynamic_executor_pool_size_" + name + "_" + threadPoolExecutor.getPoolSize());
- SMonitor.recordOne("dynamic_executor_queue_size_" + name + "_" + threadPoolExecutor.getQueue().size());
- SMonitor.recordOne("dynamic_executor_queue_remain_cap_" + name + "_" + threadPoolExecutor.getQueue().remainingCapacity());
- SMonitor.recordOne("dynamic_executor_completed_task_" + name + "_" + threadPoolExecutor.getCompletedTaskCount());
- }
- threadPoolExecutor.getActiveCount();
- threadPoolExecutor.getQueue().size();
别的这里还记载了一个任务列队耽误:- public static class ExecutorRejectedExecutionHandler implements RejectedExecutionHandler {
- private final String name;
- public ExecutorRejectedExecutionHandler(String name) {
- this.name = name;
- }
- @Override
- public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) {
- if (!executor.isShutdown()) {
- SMonitor.recordOne("dynamic_executor_task_reject_" + name);
- AtomicInteger rejectCounter = rejectCounters.get(name);
- if (rejectCounter != null) {
- rejectCounter.incrementAndGet();
- }
- log.warn("ThreadPool[{}] rejected task, poolSize: {}, active: {}, queueSize: {}, remainingCapacity: {}",
- name,
- executor.getPoolSize(),
- executor.getActiveCount(),
- executor.getQueue().size(),
- executor.getQueue().remainingCapacity());
- r.run();
- }
- }
- }
偶然间队列长度看起来不算特殊高,但任务列队时间已经很长了,这分析线程池处理惩罚本领大概已经跟不上了。
线程池一样平常怎么管理
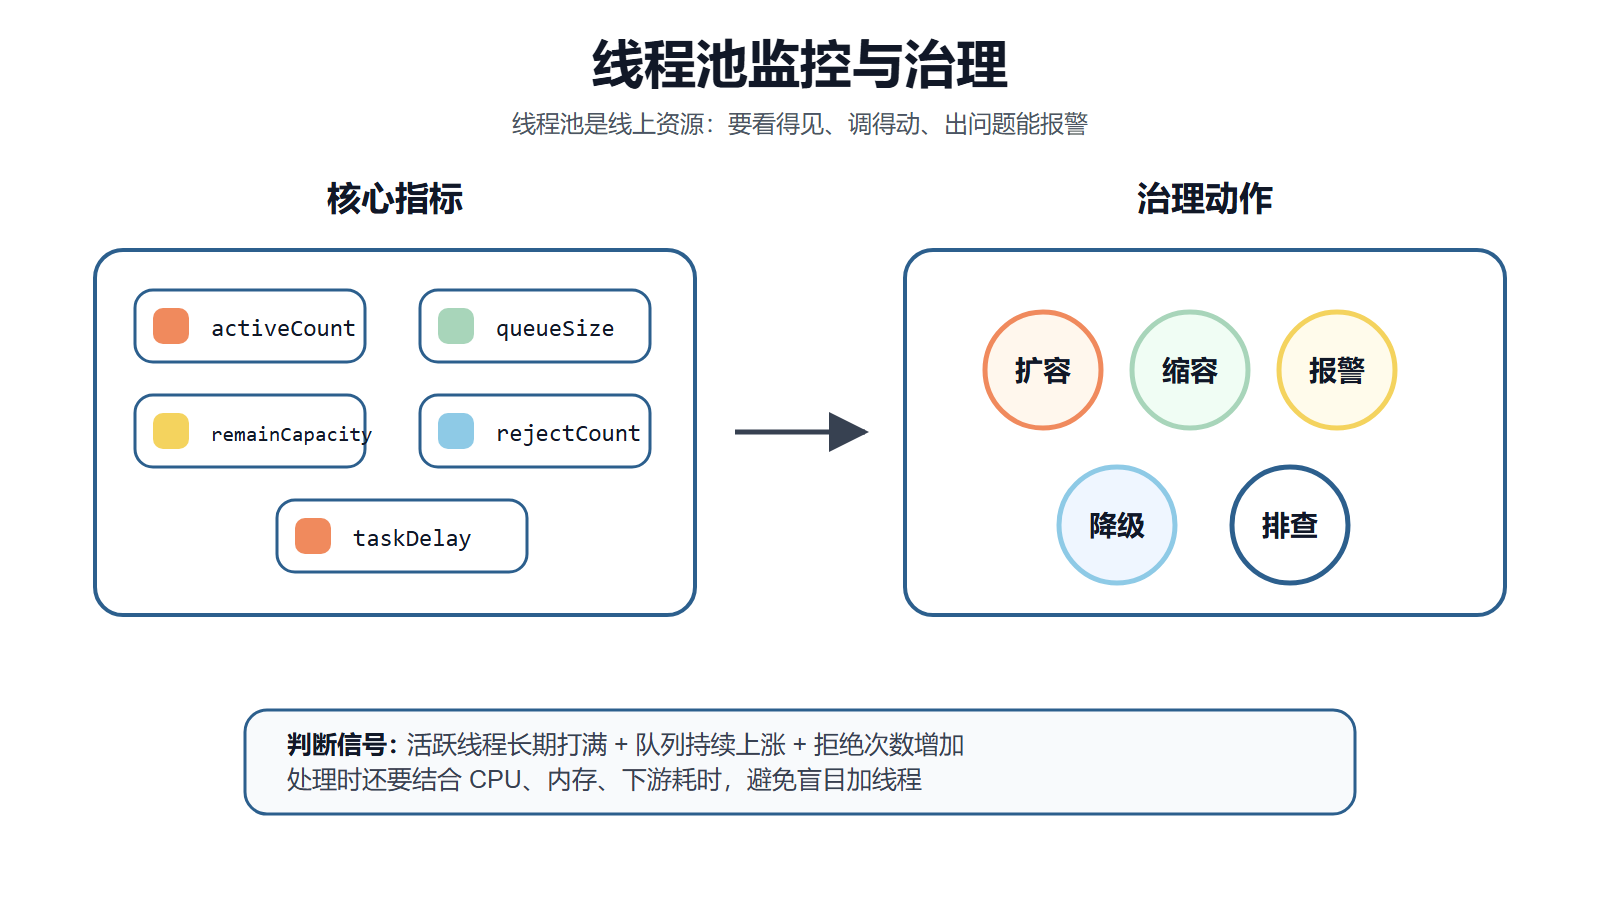
线程池创建出来只是第一步,真正在线上稳固运行,还要连续观察它的状态。生动线程数、队列长度、拒绝次数和任务列队耽误,每每比单纯看线程数更有代价。
假如这些指标恒久非常,就不能只想着把线程数调大,还要连合 CPU、内存和卑鄙耗时一起看,判断是扩容、降级,照旧排查慢任务和卑鄙抖动。
假如把线程池当成一个平凡工具类,用的时间拿来提交任务,不消的时间不管它,那早晚会出标题。
在线上,线程池更像是一种资源,须要管理。
比力根本的要求有下面几个。
同一创建
业务代码不要到处手写线程池。
同一入口创建线程池,可以包管线程名、队列容量、拒绝计谋、监控这些东西都不会漏。
队列有界
不要使用默认无界队列。
不管是 ArrayBlockingQueue,照旧指定容量的 LinkedBlockingQueue,重点是容量要明白。
容量明白以后,体系压力过大时才会袒暴露来,才有时机触发拒绝计谋、报警、降级。
指标可观测
至少要关注这些指标:
指标方法焦点线程数getCorePoolSize()最大线程数getMaximumPoolSize()当火线程数getPoolSize()生动线程数getActiveCount()队列长度getQueue().size()队列剩余容量getQueue().remainingCapacity()已完成任务数getCompletedTaskCount()拒绝任务数自界说拒绝计谋统计此中生动线程数、队列长度、拒绝任务数是最常看的几个。
参数可调解
线程池参数不是一次写完就永久不动。
假如队列连续上涨,生动线程恒久打满,而且呆板资源另有余量,可以思量扩容线程数。
假如线程池恒久很空闲,线程数显着过多,也可以思量缩容。
不外调参数时不要只看线程池自己,也要看 CPU、内存、卑鄙服务耗时。否则盲目扩容线程数,大概只是把压力转移到数据库、Redis 或卑鄙接口上。
总结
以是回到最开始的标题:你们项目中都是怎么用线程池的?
比力好的答复不是简朴说“我们用了 FixedThreadPool”,而是要说清楚这些点:
- 不直接使用 Executors 创建业务线程池
- 使用 ThreadPoolExecutor 显式指定参数
- 队列使用有界队列,克制任务无穷堆积
- 线程工厂同一设置业务线程名
- 拒绝计谋要记载日志、打监控,不能静默丢任务
- 线程池指标要定时收罗,重点关注生动线程数、队列长度、拒绝次数
- 参数最好能通过设置中央动态调解
- 异步任务须要思量 MDC、traceId 等上下文通报
线程池自己不复杂,复杂的是线上环境里的流量厘革、卑鄙抖动和任务堆积。
用得好,它可以帮我们削峰、隔离和提拔吞吐。
用得欠好,它也大概把一个小标题放大成线上事故。
|







 发表于 2026-6-15 11:00:12