

微软Azure SQL Hyperscale上线Serverless自动暂停与DiskANN向量索引:数据库内直接做RAG,省掉独立向量库
新闻原文
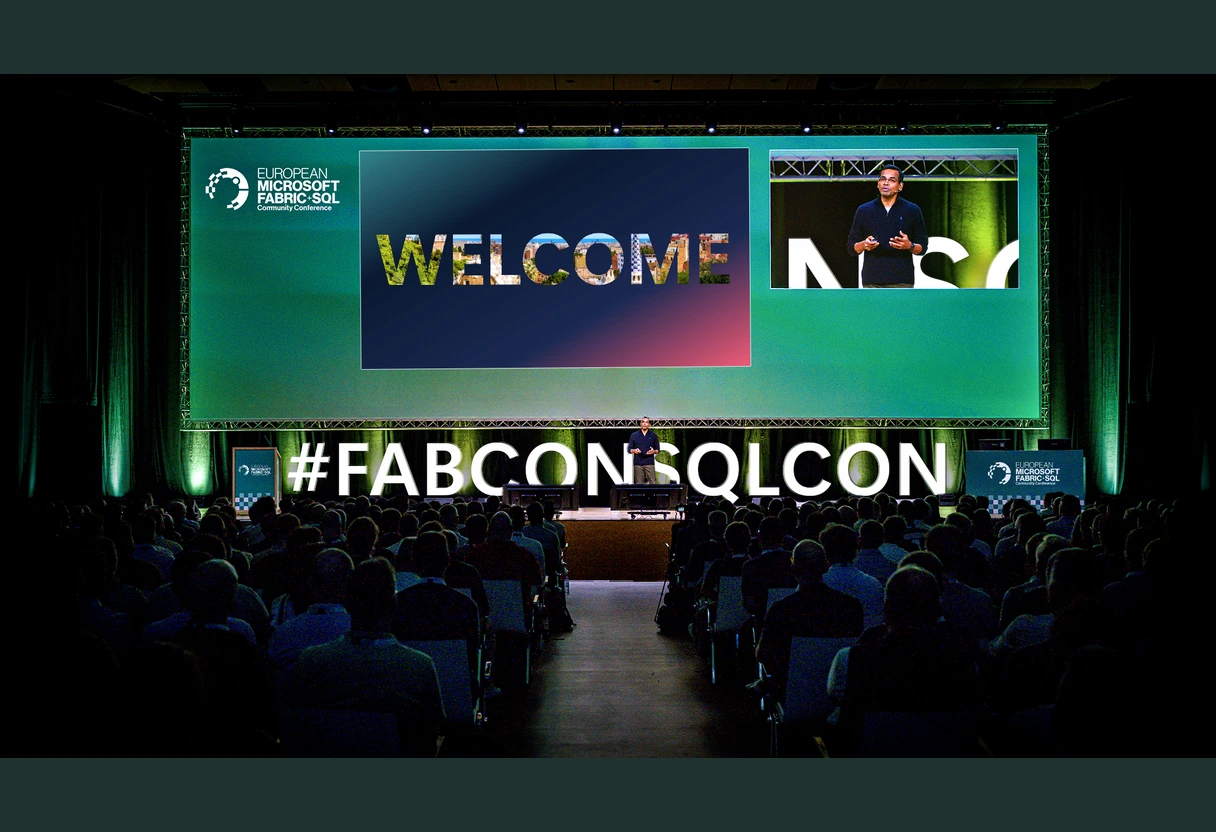
在FabCon与SQLCon 2026巴塞罗那大会上,微软围绕'为Microsoft Copilot与智能体打数据地基'主题,发布Azure SQL Database Hyperscale一系列新能力。智能应用对数据库提出更高要求:更大规模、更高效率,以及内建对AI场景的支持。
Serverless自动暂停(auto-pause)for Azure SQL Database Hyperscale进入公开预览:数据库在空闲时段自动暂停计算,负载回来时自动恢复,削减开发、测试与间歇负载的成本,且无需改动应用行为。微软同时把弹性池密度提升到每池支持最多50个数据库,并让192 vCore计算正式可用(GA),为关键业务应用提供更大规模与并发。
更受AI场景关注的是DiskANN向量索引的正式可用(GA):该能力覆盖Azure SQL Database Hyperscale、Azure SQL Managed Instance,以及Fabric中的SQL数据库,把高性能向量检索直接做进数据库引擎。开发者无需把数据迁移到独立向量库,就能在熟悉的SQL工具里构建推荐引擎、语义搜索与检索增强生成(RAG)应用。
主权与可控性方面,微软把数据平台可运行的位置进一步扩展:SQL Server on Azure Local正式可用,把SQL Server与Azure能力带到本地环境,低延迟就近访问数据;其断连运行模式(ALDO)同样GA,适用于云连接不可用或受限、有意断开的环境。无论受监管行业、边缘还是断连系统,客户都能把现代数据库能力带近数据,同时保持对数据落点的控制。
企服观察
把向量检索直接做进数据库引擎,是今年云数据库最明确的转向之一。过去做RAG,得先把数据搬进一个独立向量库,再维护两套系统的同步与权限。DiskANN进Azure SQL,意味着开发者在熟悉的SQL里就能建推荐、语义搜索和RAG,少一套基础设施。
省下的不只是钱,还有一致性。数据留在原地,检索和事务在同一引擎,权限、加密、备份策略天然统一,不会出现'业务库一套权限、向量库另一套权限'的割裂。对受监管行业,这种单一可信源比多系统拼装更经得起审计。
Serverless自动暂停是FinOps层面的实在功能。开发和测试库常常白天用、夜里空转,一直开着就是纯浪费。自动暂停把空闲算力关掉、负载回来再恢复,应用无需改动——对间歇负载,这能砍掉相当可观的计算账单。
但自动暂停不是万能。连接池、异地复制、长备保留等特性会阻止暂停,首次连接还可能遇到短暂的不可用。上之前要盘点哪些负载真正'间歇且可容忍冷启动',别一股脑全开,否则省下的钱会被运维告警吃掉。
弹性池密度提到每池50库、192 vCore GA,是给关键业务扩规模的空间。多库共享计算、按需在池内伸缩,对SaaS这类每租户一库的模式很友好,既能扛并发又不必为峰值常备过剩资源。
主权与边缘是另一条暗线。SQL Server on Azure Local把能力带到本地,ALDO断连模式覆盖云连不上的环境。对工厂、门店、军工等数据不能出域或网络不稳的场景,现代云数据库能力终于能'走'到数据身边,而不是强制上云。
对国内做数据库和RAG的厂商,信号很清楚:向量能力正在成为关系型数据库的标配而非独立品类。与其另起炉灶做向量库,不如把向量索引、混合检索做进主库,用统一权限和事务一致性换采用率。
落地建议:先用DiskANN做内部文档与工单的语义搜索、RAG试点,验证检索质量是否够用;开发测试库开Serverless自动暂停省成本。生产核心库上向量前,先测查询性能与索引维护开销,别为了省一套系统牺牲主库稳定性。
整体看,Azure这波是把'AI-ready数据库'从概念变成默认能力:向量、Serverless、主权部署一起给。当数据库原生懂向量、会省钱、能本地,企业做AI应用的底座会明显变轻——这才是比单次性能更持久的产业变化。
这次更新还应该放在微软更大的数据战略里看。围绕Copilot与智能体,微软在把Fabric、SQL数据库、语义层串成一条'数据到智能体'的完整链路:数据留在库里、检索原生内建、语义由Fabric IQ补齐、智能体在其上行动。数据库不再只是存取层,而是智能体的运行时底座,这是微软与纯云数据库厂商差异化竞争的抓手。
对开发者体验而言,'用熟悉的SQL做向量检索'降低了AI应用的入门门槛。团队不必再学一套向量数据库的查询范式与运维体系,用T-SQL就能完成向量存取与相似度查询,配合既有权限与审计,中小团队也能在一天内搭出一个可用的语义搜索原型。工具链的熟悉度,往往比极限性能更能决定采用率。
需要留意的是成本与规模边界:向量索引的构建与维护会带来额外的存储与计算开销,大表上DiskANN的索引重建时间、查询并发下的表现,都要在真实数据规模下压测;另外独立向量库在多模态、复杂过滤与专门算法上仍有优势。正确姿势是按场景拆分——交易与主数据留在SQL库做向量检索,超大规模或特殊模态另配专用引擎,两者不冲突。
评论
请评价真实、客观、有价值的内容请回复有价值的信息,无意义的评论将很快被删除,账号将被禁止发言。