

ServiceNow开源AutoSynthData:把企业智能体的失败变成训练数据,Pass@1最高提升35%
新闻原文
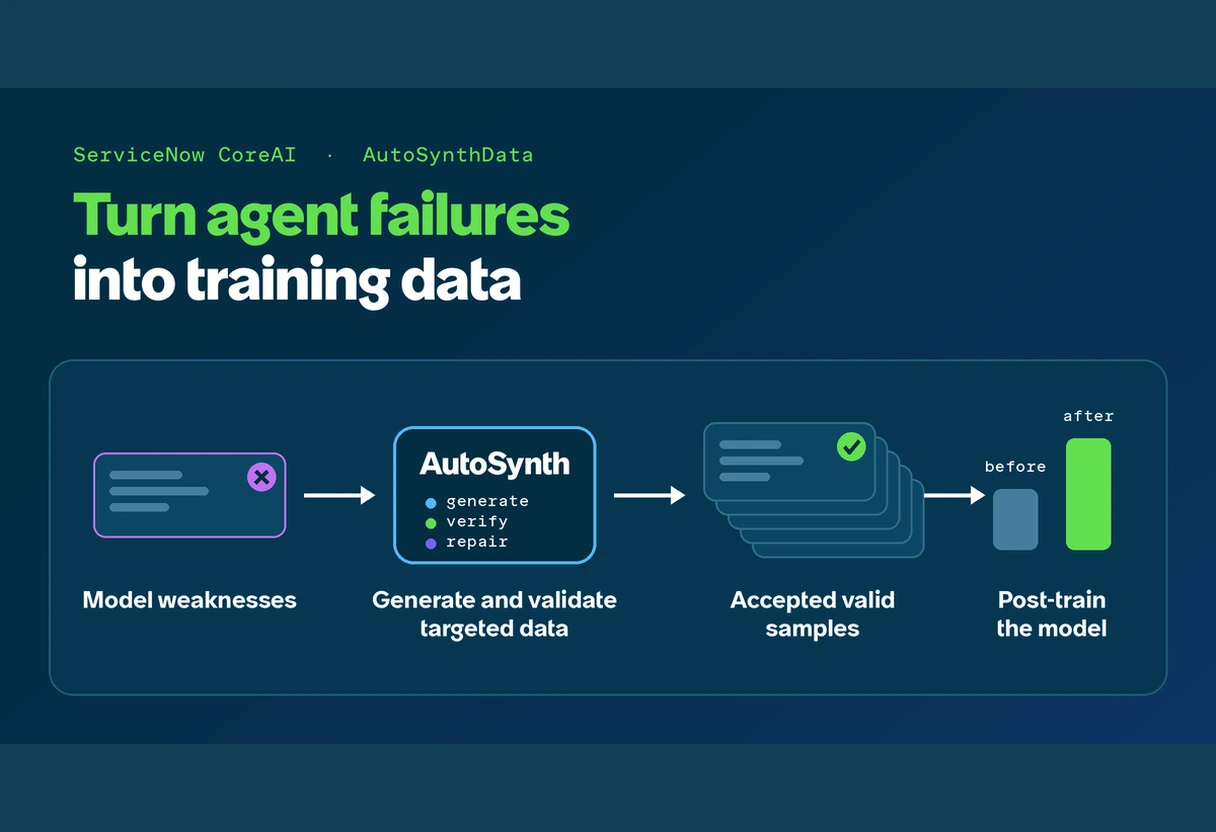
10月2日,ServiceNow CoreAI团队在Hugging Face博客发布AutoSynthData,一条面向企业智能体的训练数据生成流水线。企业希望智能体适配自己的系统、规则与数据状态,但一个模型可能整体不弱,却在某个工作流、某组工具或某条约束上反复出错;单条失败信息有限,训练却需要大量在相似能力上变化的新任务。
AutoSynthData的核心思路是把'失败'变成课程。它先在目标环境里评估目标模型与一个更强的教师模型,识别出目标模型在哪些能力上失败、教师如何成功,提炼成脱敏的'能力规格卡'(不含原始提示、实体、轨迹与验证器细节),再用卡片生成提示、状态、解法路径都不同的新任务。
一条有用的智能体任务被抽象为三元组:系统规范(工具、策略、初始化状态)、面向智能体的用户提示、验证器。提示需满足可行性、真实性与难度;验证器需具备一致性、可靠性与完备性——宽松的验证器会奖励错误行为,过严则会惩罚正确解。每个候选都要通过正向验证(预期解法是否真能完成)与负向验证(错误结果是否真会失败),并经有界修复。
数据集构建分两阶段:目标阶段并行生成并校验核心样本;扩展阶段基于已通过样本生成新变体,且变体不能再作为下一轮扩展的种子,以限制漂移。批次级还有元评审检查覆盖度与多样性。ServiceNow在EnterpriseOps Gym的Hybrid环境以Gemma-4-26B-A4B-it为目标、Qwen3.8-27B为教师,约18小时生成2000条样本,平均Pass@1提升7.2点;ITSM实验用DeepSeek-V4.1-Flash为教师生成1994条,Pass@1从18.77%升至27.18%。该流水线已在Hugging Face开放供研究。
企服观察
企业智能体的瓶颈往往不是模型不够强,而是训练数据不对口。一个通用模型在你们的系统、规则、数据状态下反复栽跟头,加参数、加通用数据都救不了——因为缺的是'针对你具体失败'的练习。AutoSynthData干的就是把失败变成定制习题。
把任务抽象成'系统规范加用户提示加验证器'三元组,是整个方法的骨架。难的是验证器:宽松会奖励错误行为,过严会惩罚正确解。ServiceNow用正向加负向双重验证把'答案对不对'变成可机器判定的事情,这才让合成数据真能用于训练而非只是看着热闹。
'能力规格卡'脱敏是关键设计。生成器只拿到抽象的能力描述,看不到原始提示、实体、轨迹和验证器,因而生成的是提示、状态、解法都不同的新题,而不是背原题。这避免了智能体在评估集上过拟合,学到的是能力而非答案。
两阶段(目标加扩展)加'变体不能再当种子'的限制,是防漂移的巧思。很多合成数据流水线跑几轮就退化成重复变体,AutoSynthData用锚定已校验核心集来约束扩张,保证数据集多样且不过拟合。批次级元评审查覆盖度,进一步防偏。
数字要说清边界。Hybrid环境Pass@1提升7.2点(+35%相对)、ITSM从18.77%到27.18%,都来自ServiceNow自己的受控实验,且依赖一个可执行的模拟环境(EnterpriseOps Gym)和可靠的验证器。换个没有可验证环境的真实系统,效果未必直接复现。
对企业最现实的用法,是拿它补自有智能体的短板:先定位模型在哪些工单、流程上失败,再批量生成同类但场景不同的练习数据做后训练。相比用真实生产数据训练,合成数据不涉及敏感信息外泄,合规上更稳。
开源到Hugging Face供研究,等于把'怎么造企业智能体训练数据'的方法交出来。中小团队不必从零摸索验证器与课程设计,可以基于它搭自己的数据工厂。这种开放比单纯发个微调后的模型更有长期价值。
对国内做智能体平台和企服自动化的厂商,启示直接:别只卖'能对话的机器人',要帮客户建'针对自身失败持续生成训练数据'的闭环。验证器质量、能力卡抽象、防漂移,这三块是这类数据工厂的工程护城河。
一句话:AutoSynthData把企业智能体的进化从'换更大模型'变成'针对弱点造题练'。当训练数据能随模型进步自动移动课程,企业AI的迭代会更快也更省——这可能比单次模型发布更贴近落地的真相。
更值得关注的是它揭示的工程方向:企业智能体的后训练,正在从'靠人工标注'转向'靠环境验证'。只要能搭出可执行、可验证的模拟环境,数据就能源源不断地自动生成并保持质量。这解释了为什么EnterpriseOps Gym这类企业运维模拟环境会成为新基建——环境即数据工厂,验证器即质量关。
和刚开源训练栈的Ai2、把智能体收进数据平台的MongoDB放在一起看,2026年10月的这条主线非常清晰:各家都在补'智能体从Demo到生产'的基础设施,只是切入层不同——Ai2补训练算力层,MongoDB补数据与治理层,ServiceNow补训练数据层。企业落地时正好可以按这三层对照自查:算力够不够、数据治理有没有、训练数据从哪来。
给企业的最后一条建议:先建验证器,再造数据。很多团队急着收集成数据,结果验证器形同虚设,训出来的模型在真实工单上依旧翻车。把'任务是否完成'的判定规则写严谨、把环境模拟做真实,比堆数据量重要得多——AutoSynthData的全部价值都建立在这一点上。
评论
请评价真实、客观、有价值的内容请回复有价值的信息,无意义的评论将很快被删除,账号将被禁止发言。