








OpenAI开源Privacy Filter隐私过滤模型,企业级AI数据安全合规迎来本地化新方案
OpenAI开源1.5B参数Privacy Filter模型,仅50M活跃参数即可精准识别PII信息,支持128K上下文和本地部署,企服数据隐私治理获新利器。
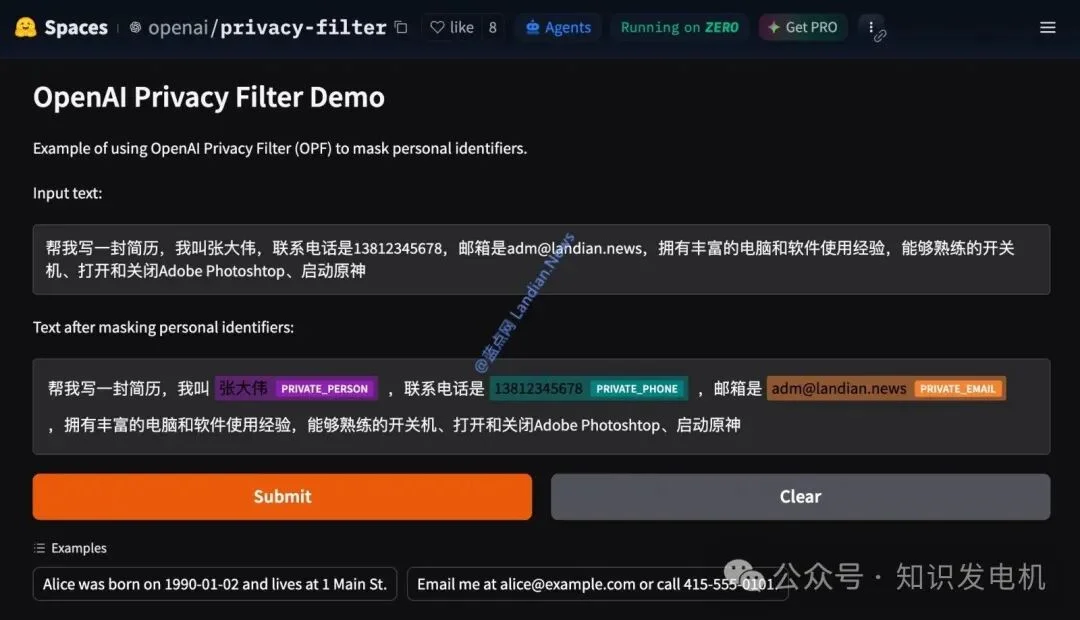
【新闻原文】OpenAI于6月1日开源了Privacy Filter模型——一款专为高吞吐量数据清理打造的隐私检测模型。总参数1.5B,但推理时仅激活约50M参数(采用Sparse Mixture-of-Experts稀疏门控MoE架构),支持最高128K上下文窗口。可识别姓名、地址、电话号码、邮箱、日期、银行账号、API凭证等8类敏感信息,通过上下文语义理解判断而非僵硬的正则匹配。模型以Apache 2.0协议在Hugging Face和GitHub开源,支持开发者下载、定制及商业部署,可在本地完全离线运行。单次前向传播极其轻量,可集成到浏览器、移动App或企业内部工具链中。
【企服观察】OpenAI开源Privacy Filter这一动作,表面上是AI安全领域的一个技术更新,但其对企业服务行业的影响深度和广度,可能远超大多数企服从业者当下的预期。这不仅仅是一个"好用的小工具"的发布——它是AI企服数据治理合规体系建设中一个里程碑式的转折点。
第一,"隐私-by-design"从口号变成了可执行代码。过去,企业在使用大模型处理客户数据时的标准做法是:将原始数据直接发送到云端API,寄希望于供应商的隐私政策和数据隔离措施。这种方式存在两个根本性风险——云端日志记录可能在用户不知情的情况下保存输入数据,同时数据出境面临日趋严格的监管约束。Privacy Filter的本地运行能力,意味着企业可以在数据离开内部网络之前完成隐私清洗,只将脱敏后的"干净文本"发送给大模型API。这种"先过滤后调用"的架构,从技术层面实现了真正的数据最小化原则。
第二,对中国企服市场的合规价值尤其突出。《个人信息保护法》(PIPL)和《数据安全法》实施以来,中国企业对数据出境的合规焦虑一直居高不下。许多跨国企业和金融、医疗等强监管行业的CIO在选择AI SaaS产品时,数据安全合规已经成为第一考量因素——甚至超过了产品功能和技术指标。Privacy Filter的离线运行能力,正好切中了这一痛点:企业可以在本地服务器上运行过滤模型,确保所有包含PII的原始数据从不离开内网,而只将脱敏后的文本发送给云端AI处理。这使得AI SaaS产品的合规审计路径变得前所未有的清晰。
第三,这个模型的MoE架构设计本身,也为企服产品的技术选型提供了新思路。1.5B总参数但仅50M活跃参数——这意味着它在消费级硬件上即可流畅运行。对于企服SaaS公司来说,可以将Privacy Filter直接打包进自己的产品中,在浏览器端或用户侧运行隐私过滤,无需额外购买昂贵的GPU服务器。这种"终端运行+云端推理"的混合架构,可能会成为AI企服产品数据处理的标准范式。
第四,Apache 2.0协议的开源许可进一步降低了集成门槛。企业可以基于自己的数据分布进行微调——这意味着一家银行的Privacy Filter可以精确识别银行卡号和对公账户流水号,而一家医院版本的模型则可以精准标记病历号和诊断信息。这种行业定制化的潜力,大大扩展了该模型在企业级场景中的实用价值。
当然,该模型并非万能。它目前只输出标记(spans),不会直接生成脱敏后的干净文本,开发者需要自己接清洗逻辑。多语言支持目前较弱,在处理中文企业上下文(如中文姓名、中国手机号格式等)时可能需要额外的微调。此外,基准测试由OpenAI自身模型评估,业界对其独立验证结果保持关注。
但总体而言,Privacy Filter的发布标志着AI企服数据安全正从"被动合规"走向"主动治理"的新阶段。对于SaaS产品经理、企业数据安全负责人和AI应用开发者而言,尽快将这类本地化隐私过滤能力整合到产品架构中,不仅是对用户数据的尊重,也是构建长期竞争壁垒的明智选择。
评论
请评价真实、客观、有价值的内容请回复有价值的信息,无意义的评论将很快被删除,账号将被禁止发言。